Zum Hauptinhalt springen

Grok 4.7vs.Qwen 3.8 27B

Wer ist besser?

Grok 4.7 liegt im Gesamtindex klar vorn, kostet aber je Token 50-mal (Eingabe) und 2,4-mal (Ausgabe) so viel.

LeistungGesamtindex, 0 bis 100 · höher ist besser
59

Grok 4.7

Platz 18 bis 25

11

Qwen 3.8 27B

Platz 44 bis 57

TempoToken pro Sekunde · höher ist besser
89

Grok 4.7

eher langsam

40

Qwen 3.8 27B

langsam

PreisDollar je 1 Mio. Token · niedriger ist besser
3 $

Grok 4.7

eher teuer

0,66 $

Qwen 3.8 27B

eher günstig

Grok 4.7

Im Abo

Bei xAI ab 8 € im Monat (The X Subscription Plus). Über andere Anbieter ab 6,83 € im Monat (Poe Basic, mit begrenzten Punkten). 41 Tarife in Deutschland.

Per API

2 $ Eingabe, 6 $ Ausgabe je 1 Mio. Token laut Anbieter; im Preisindex steht das Modell seit 01.10.2026 mit 2,20 $ und 6,60 $.

Qwen 3.8 27B

Im Abo

Kein Abo von Alibaba mit diesem Modell. Über andere Anbieter ab ≈ 1,06 € im Monat (Command Code Go, mit begrenztem Guthaben). 10 Tarife in Deutschland.

Per API

0,04 $ Eingabe, 2,50 $ Ausgabe je 1 Mio. Token laut Anbieter; im Preisindex steht das Modell seit 27.10.2026 mit 0,42 $ und 3 $.

Gesamtindex mit Daten bis 29.10.2026 · Preise vom 29.10.2026 · Tempo: Messung von Artificial Analysis · Abos vom 24.10.2026 · Abo-Preise inkl. USt

Wo liegt der Unterschied?

Werte von 0 bis 100 je Aufgabenbereich. Einen Sieger nennen wir nur, wenn der Abstand groß genug ist und es genug Tests gibt.

Grok 4.7 vorn: 9Qwen 3.8 27B vorn: 0gleichauf: 0zu wenig Daten: 1von 10 Bereichen

Grok 4.7Qwen 3.8 27B0 bis 100, höher ist besser
Bereiche im Gesamtindex
ProgrammierenGrok 4.7 vornGrok 4.7: 57Qwen 3.8 27B: 13
SchlussfolgernGrok 4.7 vornGrok 4.7: 52Qwen 3.8 27B: 6
MathematikGrok 4.7 vornGrok 4.7: 35Qwen 3.8 27B: 8
WissenGrok 4.7 vornGrok 4.7: 67Qwen 3.8 27B: 5
AgentenGrok 4.7 vornGrok 4.7: 72Qwen 3.8 27B: 21
Allgemeinnur Grok 4.7 mit WertungGrok 4.7: 55Qwen 3.8 27B: zu wenig Daten
MultimodalGrok 4.7 vornGrok 4.7: 32Qwen 3.8 27B: 13
Fachgebiete
FinanzenGrok 4.7 vornGrok 4.7: 64Qwen 3.8 27B: 34
RechtGrok 4.7 vornGrok 4.7: 76Qwen 3.8 27B: 23
GesundheitGrok 4.7 vornGrok 4.7: 69Qwen 3.8 27B: 3
3 weitere Bereiche anzeigen, die nicht zum Gesamtindex zählen
Grok 4.7Qwen 3.8 27B0 bis 100, höher ist besser
CybersicherheitGrok 4.7 vornGrok 4.7: 64Qwen 3.8 27B: 19
Produktivitätnur Grok 4.7 mit WertungGrok 4.7: 59Qwen 3.8 27B: zu wenig Daten
Bildungnur Grok 4.7 mit WertungGrok 4.7: 69Qwen 3.8 27B: zu wenig Daten

Selbst ansehen: gleicher Auftrag, ein Versuch

Derselbe Prompt für beide Modelle. Gezeigt wird der neueste Versuch ohne Nachbesserung; er zählt nicht zum Gesamtindex.

Pelikan auf dem Fahrrad

Community-Klassiker für eine freie SVG-Zeichnung.

Grok 4.7
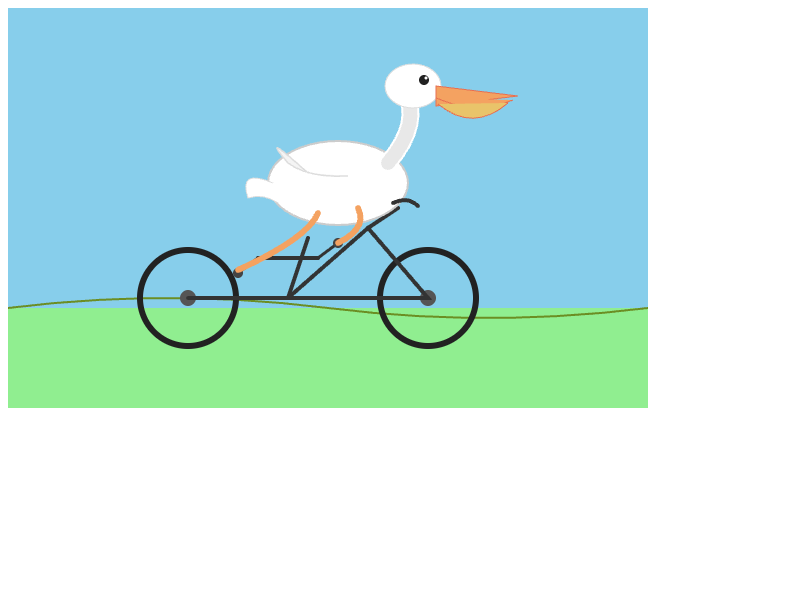
Grok 4.7: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

Reasoning (angefragt): high

Aktueller Versuch
Datum des Testlaufs
01.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
x-ai/grok-4.7
API-Modell laut Antwort
x-ai/grok-4.7
Reasoning-Einstellung
high
Festgelegter Endpunkt
xAI | x-ai/grok-4.7-20260916
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung
Antwortzeit
13,4 s

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

Frühere Versuche (1)
  • 01.10.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high

Qwen 3.8 27B

Noch nicht getestet

Prompt und Testbedingungen

Generate an SVG of a pelican riding a bicycle

Tokenlimit inklusive Reasoning: 8.192 Token

Ursprung der Aufgabe (Simon Willison)
SVG-Kurztest

SVG-Kurztest

Ein SVG-Auftrag mit denselben festen Einstellungen für alle Modelle, ohne verdecktes Nachdenken.

Gemeinsame Testrunde: 43b8c5c46830

Grok 4.7

In dieser Runde nicht verfügbar

Qwen 3.8 27B
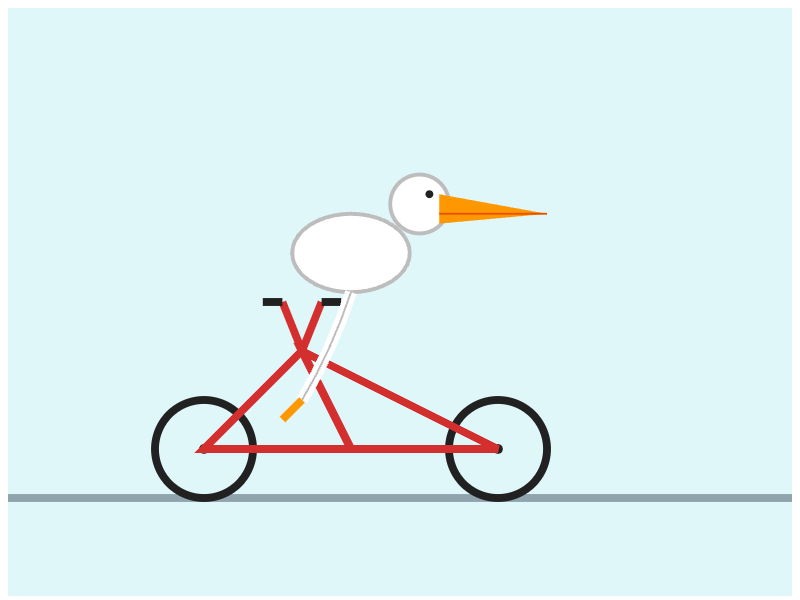
Qwen 3.8 27B: SVG-Kurztest
Testlauf: 14.10.2026 · alibaba
TestdetailsAPI meldet 0 Reasoning-TokensAPI-Modell: qwen/qwen3.8-27b865 Ausgabe-Token

Alle Daten im Vergleich

Der bessere Wert ist fett. Beim Gesamtindex nur, wenn der Abstand klar ist.

KennzahlGrok 4.7Qwen 3.8 27B
Leistung
Gesamtindex0 bis 100, höher ist besser5911
PlatzPlatz 18 bis 25 von 95Platz 44 bis 57 von 95
Preis je 1 Mio. Token
Eingabewas du schickst2 $über 200.000 Token: 4 $0,04 $
Ausgabewas das Modell schreibt6 $über 200.000 Token: 12 $2,50 $
Tempo
Token pro Sekunde8940
Technik
Kontextfensterwie viel Text das Modell auf einmal liest500.000 Token≈ 750 A4-Seiten262.144 Token≈ 390 A4-Seiten
WissensstandMai 2026k. A.
Veröffentlicht21.09.202614.08.2026
VerfügbarkeitAktivAktiv
Offene Gewichteneinja

Preise ohne Rabatte für Zwischenspeicher und Stapelverarbeitung · Seitenzahl als Faustregel nach Artificial Analysis

Gemeinsame Benchmarks

Einzelwerte aus derselben Benchmark-Version, Aufgabe und Messgröße. Fett ist ein Wert nur bei gleichem Testaufbau und klarem Abstand.

A: Grok 4.7B: Qwen 3.8 27B

AA-BriefcaseOverall · höher ist besserGrok 4.7: 1.637,84 eloQwen 3.8 27B: 1.392,67 eloArtificial AnalysisStand 29.10.2026
AA-OmniscienceOverall · höher ist besserGrok 4.7: 31,233 PunkteQwen 3.8 27B: -6,367 PunkteArtificial AnalysisStand 29.10.2026
AA-Omniscience AccuracyOverall · höher ist besserGrok 4.7: 45,7 %Qwen 3.8 27B: 18,3 %Artificial AnalysisStand 29.10.2026
AA-Omniscience Hallucination RateOverall · niedriger ist besserGrok 4.7: 33,8 %Qwen 3.8 27B: 48,7 %Artificial AnalysisStand 29.10.2026
Artificial Analysis Intelligence IndexOverall · höher ist besserGrok 4.7: 34,335 PunkteQwen 3.8 27B: 20,107 PunkteArtificial AnalysisStand 29.10.2026
AutomationBench-AAOverall · höher ist besserGrok 4.7: 65,6 %Qwen 3.8 27B: 48,2 %Artificial AnalysisStand 29.10.2026
Code MigrationOverall · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 44,8 %Qwen 3.8 27B: 14,2 %Vals AIStand 18.10.2026
CritPt v2Overall · höher ist besserGrok 4.7: 13,4 %Qwen 3.8 27B: 0,0 %Artificial AnalysisStand 29.10.2026
CritPt v2 (Hard Subset)Overall · höher ist besserGrok 4.7: 32,0 %Qwen 3.8 27B: 4,0 %Artificial AnalysisStand 29.10.2026
CyberBench v1.1Overall · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 69,5 %Qwen 3.8 27B: 67,8 %Vals AIStand 20.10.2026
54 weitere Benchmarks anzeigen
EMBOverall · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 67 %Qwen 3.8 27B: 59,7 %Vals AIStand 20.10.2026
Finance Agent (v2)Overall · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 52,3 %Qwen 3.8 27B: 48,6 %Vals AIStand 20.10.2026
FrontierCodeOverall · höher ist besserGrok 4.7: 28,7 %Qwen 3.8 27B: 14,9 %Artificial AnalysisStand 29.10.2026
FrontierCode 1.1 MainOverall · höher ist besserGrok 4.7: 39,6 %Qwen 3.8 27B: 28,9 %Artificial AnalysisStand 29.10.2026
GDP.pdfOverall · höher ist besserGrok 4.7: 20,0 %Qwen 3.8 27B: 16,4 %Artificial AnalysisStand 29.10.2026
GDPval-AAOverall · höher ist besserGrok 4.7: 1.591,68 eloQwen 3.8 27B: 1.370,88 eloArtificial AnalysisStand 29.10.2026
HLE-DiamondOverall · höher ist besserGrok 4.7: 23,2 %Qwen 3.8 27B: 15,3 %Artificial AnalysisStand 29.10.2026
IOIOverall · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 57,7 %Qwen 3.8 27B: 39,1 %Vals AIStand 24.10.2026
Legal Research BenchOverall · All-pass · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 47,1 %Qwen 3.8 27B: 36,1 %Vals AIStand 26.10.2026
LegalBenchOverall · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 84,4 %Qwen 3.8 27B: 82,4 %Vals AIStand 13.10.2026
MedCodeOverall · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 49,6 %Qwen 3.8 27B: 28,7 %Vals AIStand 13.10.2026
MedScribeOverall · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 89,4 %Qwen 3.8 27B: 83,8 %Vals AIStand 13.10.2026
MMMU-ProOverall · höher ist besserGrok 4.7: 78,2 %Qwen 3.8 27B: 73,8 %Artificial AnalysisStand 29.10.2026
ProgramBenchOverall · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 0,5 %Qwen 3.8 27B: 0 %Vals AIStand 20.10.2026
ProofBench v1.1Overall · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 26 %Qwen 3.8 27B: 16 %Vals AIStand 24.10.2026
Tax Agent BenchOverall · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 34,2 %Qwen 3.8 27B: 30,9 %Vals AIStand 26.10.2026
Terminal-BenchOverall · höher ist besserGrok 4.7: 25,8 %Qwen 3.8 27B: 5,6 %Artificial AnalysisStand 29.10.2026
Terminal-Bench 2.1Overall · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 73,4 %Qwen 3.8 27B: 58,4 %Vals AIStand 01.10.2026
Terminal-Bench-ScienceOverall · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 10 %Qwen 3.8 27B: 0 %Vals AIStand 25.10.2026
Terminal-Bench-ScienceOverall · höher ist besserGrok 4.7: 4,8 %Qwen 3.8 27B: 0,5 %Artificial AnalysisStand 29.10.2026
Vibe Code Bench v1.1Overall · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 86,2 %Qwen 3.8 27B: 64,9 %Vals AIStand 26.10.2026
AA-Omniscience AccuracyOverall · höher ist besserGrok 4.7: 42,7 %Qwen 3.8 27B: 17,3 %Artificial AnalysisStand 29.10.2026
AA-Omniscience Hallucination RateOverall · niedriger ist besserGrok 4.7: 20,0 %Qwen 3.8 27B: 28,6 %Artificial AnalysisStand 29.10.2026
Code MigrationCLI · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 36,4 %Qwen 3.8 27B: 2,2 %Vals AIStand 18.10.2026
CritPt v2Overall · höher ist besserGrok 4.7: 17,7 %Qwen 3.8 27B: 5,4 %Artificial AnalysisStand 29.10.2026
CyberBench v1.1Patch · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 83,9 %Qwen 3.8 27B: 83,9 %Vals AIStand 20.10.2026
EMBComps · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 65 %Qwen 3.8 27B: 53,3 %Vals AIStand 20.10.2026
Finance Agent (v2)Adjustments · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 46,3 %Qwen 3.8 27B: 47,3 %Vals AIStand 20.10.2026
FrontierCode 1.1 MainOverall · höher ist besserGrok 4.7: 33,8 %Qwen 3.8 27B: 34,2 %Artificial AnalysisStand 29.10.2026
GDPval-AAOverall · höher ist besserGrok 4.7: 1.721,59 eloQwen 3.8 27B: 1.427,26 eloArtificial AnalysisStand 29.10.2026
IOIIOI 2024 · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 61,7 %Qwen 3.8 27B: 31,8 %Vals AIStand 24.10.2026
Legal Research BenchAdministrative / Regulatory · All-pass · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 54,5 %Qwen 3.8 27B: 45,5 %Vals AIStand 26.10.2026
LegalBenchConclusion Tasks · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 88,6 %Qwen 3.8 27B: 88,4 %Vals AIStand 13.10.2026
ProgramBenchAlmost Resolved · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 21,5 %Qwen 3.8 27B: 1 %Vals AIStand 20.10.2026
Tax Agent BenchControversy & Precedence Analysis · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 13,3 %Qwen 3.8 27B: 6,7 %Vals AIStand 26.10.2026
Terminal-Bench 2.1Easy · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 91,7 %Qwen 3.8 27B: 50 %Vals AIStand 01.10.2026
Terminal-Bench-ScienceEarth Sciences · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 25 %Qwen 3.8 27B: 0 %Vals AIStand 25.10.2026
Code MigrationCOBOL · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 70 %Qwen 3.8 27B: 50 %Vals AIStand 18.10.2026
CyberBench v1.1PoC · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 55 %Qwen 3.8 27B: 51,7 %Vals AIStand 20.10.2026
EMBDataroom · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 83,6 %Qwen 3.8 27B: 79,7 %Vals AIStand 20.10.2026
Finance Agent (v2)All-Pass · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 42,1 %Qwen 3.8 27B: 36,8 %Vals AIStand 20.10.2026
IOIIOI 2025 · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 56,2 %Qwen 3.8 27B: 48,5 %Vals AIStand 24.10.2026
Legal Research BenchAdministrative / Regulatory · Weighted partial credit · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 87,2 %Qwen 3.8 27B: 88,5 %Vals AIStand 26.10.2026
LegalBenchInterpretation Tasks · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 81,3 %Qwen 3.8 27B: 82 %Vals AIStand 13.10.2026
ProgramBenchFully Resolved · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 0,5 %Qwen 3.8 27B: 0 %Vals AIStand 20.10.2026
Tax Agent BenchControversy & Precedence Analysis · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 62,7 %Qwen 3.8 27B: 48,3 %Vals AIStand 26.10.2026
Terminal-Bench 2.1Hard · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 67,8 %Qwen 3.8 27B: 43,3 %Vals AIStand 01.10.2026
Terminal-Bench-ScienceEngineering Sciences · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 0 %Qwen 3.8 27B: 0 %Vals AIStand 25.10.2026
Code MigrationCode Quality · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 4,105 / 5Qwen 3.8 27B: 4,197 / 5Vals AIStand 18.10.2026
EMBDCF · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 58,2 %Qwen 3.8 27B: 50 %Vals AIStand 20.10.2026
Finance Agent (v2)Comparables · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 42,2 %Qwen 3.8 27B: 38,9 %Vals AIStand 20.10.2026
IOIIOI 2026 · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 55,3 %Qwen 3.8 27B: 36,8 %Vals AIStand 24.10.2026
Legal Research BenchBusiness & Commercial · All-pass · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 44,2 %Qwen 3.8 27B: 41,9 %Vals AIStand 26.10.2026
LegalBenchIssue Tasks · höher ist besserTestaufbau nicht identisch dokumentiertGrok 4.7: 89,5 %Qwen 3.8 27B: 90,2 %Vals AIStand 13.10.2026

Anderes Duell vergleichen