Claude Sonnet 5.5vs.Qwen 3.8 27B
Wer ist besser?
Claude Sonnet 5.5 liegt im Gesamtindex klar vorn, kostet aber je Token 50-mal (Eingabe) und 4-mal (Ausgabe) so viel.
Claude Sonnet 5.5
Platz 2 bis 6
Qwen 3.8 27B
Platz 44 bis 57
Claude Sonnet 5.5
eher schnell
Qwen 3.8 27B
langsam
Claude Sonnet 5.5
eher teuer
Qwen 3.8 27B
eher günstig
Claude Sonnet 5.5
- Im Abo
Bei Anthropic kostenlos nutzbar (Claude Free), mehr ab 21,42 € im Monat (Claude Pro). Über andere Anbieter ab ≈ 6,36 € im Monat (ElevenLabs Starter, mit begrenztem Guthaben). 64 Tarife in Deutschland.
- Per API
2 $ Eingabe, 10 $ Ausgabe je 1 Mio. Token, unverändert seit 29.09.2026.
Qwen 3.8 27B
- Im Abo
Kein Abo von Alibaba mit diesem Modell. Über andere Anbieter ab ≈ 1,06 € im Monat (Command Code Go, mit begrenztem Guthaben). 10 Tarife in Deutschland.
- Per API
0,04 $ Eingabe, 2,50 $ Ausgabe je 1 Mio. Token laut Anbieter; im Preisindex steht das Modell seit 27.10.2026 mit 0,42 $ und 3 $.
Gesamtindex mit Daten bis 29.10.2026 · Preise vom 29.10.2026 · Tempo: Messung von Artificial Analysis · Abos vom 24.10.2026 · Abo-Preise inkl. USt
Wo liegt der Unterschied?
Werte von 0 bis 100 je Aufgabenbereich. Einen Sieger nennen wir nur, wenn der Abstand groß genug ist und es genug Tests gibt.
Sonnet 5.5 vorn: 9Qwen 3.8 27B vorn: 0gleichauf: 0zu wenig Daten: 1von 10 Bereichen
3 weitere Bereiche anzeigen, die nicht zum Gesamtindex zählen
Selbst ansehen: gleicher Auftrag, ein Versuch
Derselbe Prompt für beide Modelle. Gezeigt wird der neueste Versuch ohne Nachbesserung; er zählt nicht zum Gesamtindex.
Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.
Claude Sonnet 5.5
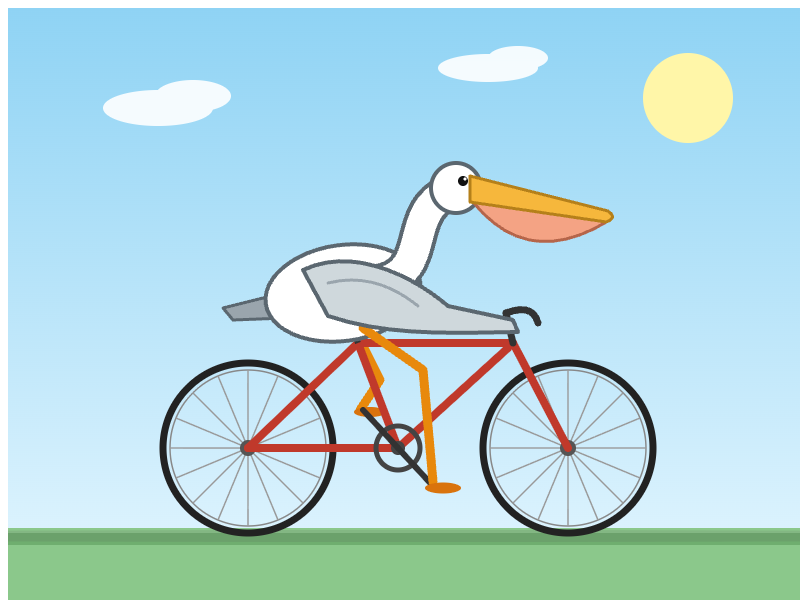
Reasoning (angefragt): high
Aktueller Versuch
- Datum des Testlaufs
- 01.10.2026
- API-Anbieter
- openrouter
- Angefragtes API-Modell
- anthropic/claude-sonnet-5.5
- API-Modell laut Antwort
- anthropic/claude-sonnet-5.5
- Reasoning-Einstellung
- high
- Festgelegter Endpunkt
- Anthropic | anthropic/claude-sonnet-5.5-20260928
- Temperatur
- Anbieterstandard
- Tokenlimit inklusive Reasoning
- 8.192 Token
- Testprotokoll
- community-visual-tests-v1
- Technische Prüfung
- Bestanden, keine Qualitätsbewertung
- Antwortzeit
- 28,2 s
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Qwen 3.8 27B
Noch nicht getestet
Prompt und Testbedingungen
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)SVG-Kurztest
SVG-Kurztest
Ein SVG-Auftrag mit denselben festen Einstellungen für alle Modelle, ohne verdecktes Nachdenken.
Gemeinsame Testrunde: 43b8c5c46830
Claude Sonnet 5.5
In dieser Runde nicht verfügbar
Qwen 3.8 27B
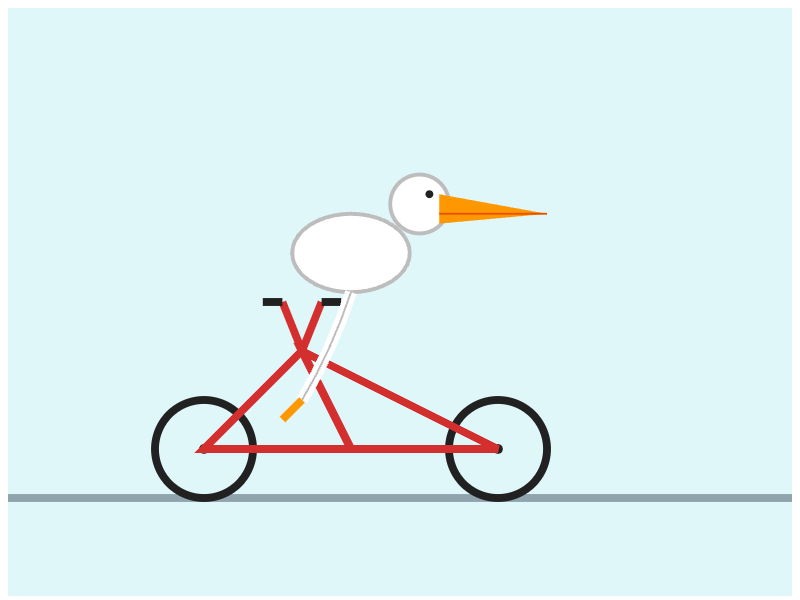
Testdetails
API meldet 0 Reasoning-TokensAPI-Modell: qwen/qwen3.8-27b865 Ausgabe-TokenAlle Daten im Vergleich
Der bessere Wert ist fett. Beim Gesamtindex nur, wenn der Abstand klar ist.
| Kennzahl | Claude Sonnet 5.5 | Qwen 3.8 27B |
|---|---|---|
| Leistung | ||
| Gesamtindex0 bis 100, höher ist besser | 93 | 11 |
| Platz | Platz 2 bis 6 von 95 | Platz 44 bis 57 von 95 |
| Preis je 1 Mio. Token | ||
| Eingabewas du schickst | 2 $ | 0,04 $ |
| Ausgabewas das Modell schreibt | 10 $ | 2,50 $ |
| Tempo | ||
| Token pro Sekunde | 138 | 40 |
| Technik | ||
| Kontextfensterwie viel Text das Modell auf einmal liest | 1 Mio. Token≈ 1.500 A4-Seiten | 262.144 Token≈ 390 A4-Seiten |
| Wissensstand | Juni 2026 | k. A. |
| Veröffentlicht | 28.09.2026 | 14.08.2026 |
| Verfügbarkeit | Aktiv | Aktiv |
| Offene Gewichte | nein | ja |
Preise ohne Rabatte für Zwischenspeicher und Stapelverarbeitung · Seitenzahl als Faustregel nach Artificial Analysis
Gemeinsame Benchmarks
Einzelwerte aus derselben Benchmark-Version, Aufgabe und Messgröße. Fett ist ein Wert nur bei gleichem Testaufbau und klarem Abstand.
A: Claude Sonnet 5.5B: Qwen 3.8 27B
54 weitere Benchmarks anzeigen
Anderes Duell vergleichen
Weitere Duelle
Ähnliche LLM-Vergleiche
Vergleiche Claude Sonnet 5.5 und Qwen 3.8 27B mit weiteren wichtigen Modellen.