Zum Hauptinhalt springen

Direktvergleich

GPT-6 Sol vs. Muse Wonder

Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.

gemeinsame Messreihen
166
verschiedene Benchmarks
18
jüngster Abruf
15.10.2026

Modellauswahl ändern

Steckbrief

Allgemeine Daten

Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.

Allgemeine Daten von GPT-6 Sol und Muse Wonder
MerkmalGPT-6 SolMuse Wonder
AnbieterOpenAIMeta
Erschienen22. Sept. 202612. Okt. 2026
VerfügbarkeitAktivPreview
ModelltypProprietärProprietär
ParameterNicht veröffentlichtNicht veröffentlicht
ArchitekturNicht veröffentlichtNicht veröffentlicht
Kontextfenster1.050.000 Token1.048.576 Token
Wissensstand20. April 2026Nicht veröffentlicht
Technische QuellenModell, KontextModell, Kontext

Kosten

API-Preise im Vergleich

Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.

API-Preise von GPT-6 Sol und Muse Wonder
PreisartGPT-6 SolMuse Wonder
API-Eingabe2 $ ≤272K / 4 $ >272K4 $
API-Ausgabe10 $ ≤272K / 15 $ >272K20 $
Cache lesen0,2 $ ≤272K / 0,4 $ >272K0,2 $
Cache schreiben (5 Min.)2,5 $ ≤272K / 5 $ >272KNicht ausgewiesen
Cache schreiben (1 Std.)Nicht ausgewiesenNicht ausgewiesen
Preis geprüft22.09.2026 Quelle15.10.2026 Quelle
GPT-6 SolMuse Wonder
API-EingabeUSD pro 1 Mio. Token, Basistarif
GPT-6 SolGünstiger2 $
Muse Wonder4 $
API-AusgabeUSD pro 1 Mio. Token, Basistarif
GPT-6 SolGünstiger10 $
Muse Wonder20 $
Cache lesenUSD pro 1 Mio. Token, Basistarif
GPT-6 SolGleichstand0,2 $
Muse WonderGleichstand0,2 $

Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand

Preise nach Anbieter

Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.

Für Muse Wonder ist im gespeicherten OpenRouter-Stand kein Anbietertarif verfügbar. Der offizielle Direktpreis wird trotzdem angezeigt.

Anbieterpreise von GPT-6 Sol und Muse Wonder
ModellAnbieterBezugsweg und TarifEingabe pro 1 Mio. TokenAusgabe pro 1 Mio. TokenQuelle
GPT-6 SolOpenAIDirekt beim EntwicklerBis 272.000 Kontext-Token2 $10 $Quelle22.09.2026
OpenAIDirekt beim EntwicklerÜber 272.000 Kontext-Token4 $15 $Quelle22.09.2026
Amazon BedrockÜber OpenRouteramazon-bedrock/us-east-12,2 $11 $Quelle16.10.2026
AzureÜber OpenRouterazure2 $10 $Quelle16.10.2026
AzureÜber OpenRouterazure/eu2,2 $11 $Quelle16.10.2026
AzureÜber OpenRouterazure/us2,2 $11 $Quelle16.10.2026
OpenAIÜber OpenRouteropenai2 $10 $Quelle16.10.2026
OpenAIÜber OpenRouteropenai/fast4 $20 $Quelle16.10.2026
OpenAIÜber OpenRouteropenai/flexGünstigster erfasster Preis: 1 $Günstigster erfasster Preis: 5 $Quelle16.10.2026
Muse WonderMetaDirekt beim EntwicklerStandard-APIGünstigster erfasster Preis: 4 $Günstigster erfasster Preis: 20 $Quelle15.10.2026

Leistung

Gemeinsame Benchmarks

Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.

Fähigkeitsprofil aus vergleichbaren Benchmarks

Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.

255075100CodingReasoningWissenFinanzenAllgemein
GPT-6 Sol
Muse Wonder
Coding: 98,4 / 99,1 (2 Benchmarkfamilien)
Reasoning: 97,8 / 100 (1 Benchmarkfamilie)
Wissen: 97,5 / 100 (1 Benchmarkfamilie)
Finanzen: 96,5 / 100 (1 Benchmarkfamilie)
Allgemein: 96,4 / 100 (1 Benchmarkfamilie)

22 passende Messreihen aus 2 Benchmarkfamilien wurden berücksichtigt. Das Radar zeigt 5 von 5 vergleichbaren Kategorien.

GPT-6 SolMuse Wonder
BioMysteryBenchOverall. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-6 SolHöherer Messwert74,815 %
Muse Wonder67,037 %
Code MigrationOverall. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-6 Sol57,195 %
Muse WonderHöherer Messwert62,552 %
CyberBench v1.1Overall. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-6 Sol77,976 %
Muse WonderHöherer Messwert80,357 %
EMBOverall. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-6 SolHöherer Messwert71,53 %
Muse Wonder67,084 %
Finance Agent (v2)Overall. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-6 Sol49,05 %
Muse WonderHöherer Messwert56,637 %
Harvey's Legal Agent BenchmarkOverall · Task fully resolved. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-6 Sol1,667 %
Muse WonderHöherer Messwert17,083 %
IOIOverall. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-6 SolHöherer Messwert82,611 %
Muse Wonder66,944 %
Legal Research BenchOverall · All-pass. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-6 Sol28,846 %
Muse WonderHöherer Messwert50,481 %
LMArena Code Arena WebDevOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-6 SolGewinner1.685,864
Muse Wonder1.650,947
LMArena Text, Style ControlOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
GPT-6 Sol1.458,271
Muse WonderGewinner1.512,671
MysteryMechanismOverall. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-6 SolHöherer Messwert30,18 %
Muse Wonder27,477 %
ProofBenchOverall. Mehr ist besser. Testaufbau nicht identisch dokumentiert
GPT-6 Sol83 %
Muse WonderHöherer Messwert84 %

Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand

Benchmarkwerte von GPT-6 Sol und Muse Wonder
Benchmark und AufgabeGPT-6 SolMuse WonderQuelle
BioMysteryBenchOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Harness: Terminus 2, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Harness: Terminus 2, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert74,815 %
67,037 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Code MigrationOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
57,195 %
Höherer Messwert62,552 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
CyberBench v1.1Overall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
77,976 %
Höherer Messwert80,357 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
EMBOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert71,53 %
67,084 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Finance Agent (v2)Overall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
49,05 %
Höherer Messwert56,637 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Harvey's Legal Agent BenchmarkOverall · Task fully resolved
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
1,667 %
Höherer Messwert17,083 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
IOIOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert82,611 %
66,944 %
Vals AI
Quellendetails
Datenstand: 14.10.2026
Legal Research BenchOverall · All-pass
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
28,846 %
Höherer Messwert50,481 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
LMArena Code Arena WebDevOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Sol: Snapshot: gpt-6-sol-max, Reasoning: max, Harness: Arena Code Arena WebDev
Muse Wonder: Snapshot: muse-wonder-max, Reasoning: max, Harness: Arena Code Arena WebDev
GPT-6 Sol: Arena-Bewertung aus 4.032 veröffentlichten Paarvergleichen.Muse Wonder: Arena-Bewertung aus 1.228 veröffentlichten Paarvergleichen.
Gewinner1.685,864
95-%-Konfidenzintervall: ±10,999Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis.
1.650,947
95-%-Konfidenzintervall: ±18,263Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis.
LMArena
Quellendetails
Datenstand: 13.10.2026
LMArena Text, Style ControlOverall
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Sol: Snapshot: gpt-6-sol-max, Reasoning: max, Harness: Arena Text, style control
Muse Wonder: Snapshot: muse-wonder-max, Reasoning: max, Harness: Arena Text, style control
GPT-6 Sol: Arena-Bewertung aus 11.903 veröffentlichten Paarvergleichen.Muse Wonder: Arena-Bewertung aus 1.944 veröffentlichten Paarvergleichen.
1.458,271
95-%-Konfidenzintervall: ±6,418Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis.
Gewinner1.512,671
95-%-Konfidenzintervall: ±13,236Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis.
LMArena
Quellendetails
Datenstand: 13.10.2026
MysteryMechanismOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert30,18 %
27,477 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
ProofBenchOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
83 %
Höherer Messwert84 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Public Benefits Bench v1.1Overall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
56,631 %
Höherer Messwert70,23 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Tax Agent BenchOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
15,002 %
Höherer Messwert36,269 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Terminal-Bench 4.0Overall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 4.0Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
44,444 %
Höherer Messwert49,495 %
Vals AI
Quellendetails
Datenstand: 13.10.2026
Terminal-Bench ScienceOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Harness: Mini-SWE-agent, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Harness: Mini-SWE-agent, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert30 %
22,857 %
Vals AI
Quellendetails
Datenstand: 14.10.2026
Vals IndexOverall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: weighted index scoreBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
57,536 %
Höherer Messwert61,062 %
Vals AI
Quellendetails
Datenstand: 13.10.2026
Vibe Code Bench v1.1Overall
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Harness: OpenHands, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Harness: OpenHands, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert87,824 %
83,089 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
BioMysteryBenchHard
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Harness: Terminus 2, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Harness: Terminus 2, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert35,294 %
29,412 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Code MigrationCLI
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
52,927 %
Höherer Messwert60,07 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
CyberBench v1.1Patch
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert89,286 %
85,714 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
EMBComps
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
73,295 %
Höherer Messwert79,488 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Finance Agent (v2)Adjustments
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
43,241 %
Höherer Messwert52,67 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Harvey's Legal Agent BenchmarkAntitrust Competition · Criteria passed
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: criteria pass rateBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
78,623 %
Höherer Messwert93,841 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
IOIIOI 2024
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert100 %
66,833 %
Vals AI
Quellendetails
Datenstand: 14.10.2026
Legal Research BenchAdministrative / Regulatory · All-pass
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
39,394 %
Höherer Messwert63,636 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
LMArena Code Arena WebDevWebdev
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Sol: Snapshot: gpt-6-sol-max, Reasoning: max, Harness: Arena Code Arena WebDev
Muse Wonder: Snapshot: muse-wonder-max, Reasoning: max, Harness: Arena Code Arena WebDev
GPT-6 Sol: Arena-Bewertung aus 4.032 veröffentlichten Paarvergleichen.Muse Wonder: Arena-Bewertung aus 1.228 veröffentlichten Paarvergleichen.
Gewinner1.685,864
95-%-Konfidenzintervall: ±10,999Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis.
1.650,947
95-%-Konfidenzintervall: ±18,263Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis.
LMArena
Quellendetails
Datenstand: 13.10.2026
LMArena Text, Style ControlBusiness, management and finance
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Sol: Snapshot: gpt-6-sol-max, Reasoning: max, Harness: Arena Text, style control
Muse Wonder: Snapshot: muse-wonder-max, Reasoning: max, Harness: Arena Text, style control
GPT-6 Sol: Arena-Bewertung aus 2.220 veröffentlichten Paarvergleichen.Muse Wonder: Arena-Bewertung aus 338 veröffentlichten Paarvergleichen.
1.447,173
95-%-Konfidenzintervall: ±13,15Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis.
Gewinner1.500,247
95-%-Konfidenzintervall: ±30,856Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis.
LMArena
Quellendetails
Datenstand: 13.10.2026
Tax Agent BenchControversy & Precedence Analysis
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
6,667 %
Höherer Messwert20 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Terminal-Bench 4.0Hardware
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 4.0Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
6,667 %
Höherer Messwert46,667 %
Vals AI
Quellendetails
Datenstand: 13.10.2026
Terminal-Bench ScienceEarth Sciences
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Harness: Mini-SWE-agent, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Harness: Mini-SWE-agent, Temperatur: 1, Ausgabegrenze: 131.072 tokens
25 %
Höherer Messwert50 %
Vals AI
Quellendetails
Datenstand: 14.10.2026
Vals IndexCode Migration
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: benchmark scoreBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
56,92 %
Höherer Messwert62,009 %
Vals AI
Quellendetails
Datenstand: 13.10.2026
BioMysteryBenchHuman-solvable
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Harness: Terminus 2, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Harness: Terminus 2, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert84,018 %
75,799 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Code MigrationCOBOL
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Kein direkter Sieger70 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
CyberBench v1.1PoC
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
66,667 %
Höherer Messwert75 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
EMBDataroom
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert83,92 %
79,232 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Finance Agent (v2)All-Pass
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
35,981 %
Höherer Messwert45,936 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Harvey's Legal Agent BenchmarkAntitrust Competition · Task fully resolved
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
0 %
Höherer Messwert20 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
IOIIOI 2025
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert79,333 %
75,5 %
Vals AI
Quellendetails
Datenstand: 14.10.2026
Legal Research BenchAdministrative / Regulatory · Weighted partial credit
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: weighted partial-credit scoreBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
80,457 %
Höherer Messwert90,571 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
LMArena Code Arena WebDevWebdev-html
Testdetails
Kein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Sol: Snapshot: gpt-6-sol-max, Reasoning: max, Harness: Arena Code Arena WebDev
Muse Wonder: Snapshot: muse-wonder-max, Reasoning: max, Harness: Arena Code Arena WebDev
GPT-6 Sol: Arena-Bewertung aus 772 veröffentlichten Paarvergleichen.Muse Wonder: Arena-Bewertung aus 158 veröffentlichten Paarvergleichen.
1.682,93
95-%-Konfidenzintervall: ±24,785Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis.
Kein klarer Vorsprung1.721,908
95-%-Konfidenzintervall: ±51,47Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis.
LMArena
Quellendetails
Datenstand: 13.10.2026
LMArena Text, Style ControlCoding
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Sol: Snapshot: gpt-6-sol-max, Reasoning: max, Harness: Arena Text, style control
Muse Wonder: Snapshot: muse-wonder-max, Reasoning: max, Harness: Arena Text, style control
GPT-6 Sol: Arena-Bewertung aus 2.760 veröffentlichten Paarvergleichen.Muse Wonder: Arena-Bewertung aus 487 veröffentlichten Paarvergleichen.
1.518,379
95-%-Konfidenzintervall: ±11,783Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis.
Gewinner1.557,956
95-%-Konfidenzintervall: ±26,189Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis.
LMArena
Quellendetails
Datenstand: 13.10.2026
Tax Agent BenchControversy & Precedence Analysis
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
50,662 %
Höherer Messwert71,362 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Terminal-Bench 4.0Media
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 4.0Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert41,667 %
33,333 %
Vals AI
Quellendetails
Datenstand: 13.10.2026
Terminal-Bench ScienceEngineering Sciences
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Harness: Mini-SWE-agent, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Harness: Mini-SWE-agent, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert22,222 %
0 %
Vals AI
Quellendetails
Datenstand: 14.10.2026
Vals IndexEMB
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: benchmark scoreBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert71,53 %
67,084 %
Vals AI
Quellendetails
Datenstand: 13.10.2026
Code MigrationCode Quality
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: mean reviewer code-quality ratingBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert4,375 / 5
4,061 / 5
Vals AI
Quellendetails
Datenstand: 12.10.2026
EMBDCF
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert63,142 %
51,035 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Finance Agent (v2)Comparables
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
40,833 %
Höherer Messwert47,933 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Harvey's Legal Agent BenchmarkArbitration International Dispute Resolution · Criteria passed
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: criteria pass rateBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
83,871 %
Höherer Messwert92,473 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
IOIIOI 2026
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert68,5 %
58,5 %
Vals AI
Quellendetails
Datenstand: 14.10.2026
Legal Research BenchBusiness & Commercial · All-pass
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
27,907 %
Höherer Messwert48,837 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
LMArena Code Arena WebDevWebdev-react
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Sol: Snapshot: gpt-6-sol-max, Reasoning: max, Harness: Arena Code Arena WebDev
Muse Wonder: Snapshot: muse-wonder-max, Reasoning: max, Harness: Arena Code Arena WebDev
GPT-6 Sol: Arena-Bewertung aus 2.378 veröffentlichten Paarvergleichen.Muse Wonder: Arena-Bewertung aus 787 veröffentlichten Paarvergleichen.
Gewinner1.688,269
95-%-Konfidenzintervall: ±13,996Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis.
1.637,813
95-%-Konfidenzintervall: ±23,199Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis.
LMArena
Quellendetails
Datenstand: 13.10.2026
LMArena Text, Style ControlCreative writing
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Sol: Snapshot: gpt-6-sol-max, Reasoning: max, Harness: Arena Text, style control
Muse Wonder: Snapshot: muse-wonder-max, Reasoning: max, Harness: Arena Text, style control
GPT-6 Sol: Arena-Bewertung aus 2.486 veröffentlichten Paarvergleichen.Muse Wonder: Arena-Bewertung aus 427 veröffentlichten Paarvergleichen.
1.441,256
95-%-Konfidenzintervall: ±12,885Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis.
Gewinner1.485,682
95-%-Konfidenzintervall: ±29,474Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis.
LMArena
Quellendetails
Datenstand: 13.10.2026
Tax Agent BenchCurrent & Temporal Analysis
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
23,179 %
Höherer Messwert50 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Terminal-Bench 4.0ML
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 4.0Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Kein direkter Sieger45,455 %
Vals AI
Quellendetails
Datenstand: 13.10.2026
Terminal-Bench ScienceLife Sciences
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Harness: Mini-SWE-agent, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Harness: Mini-SWE-agent, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Höherer Messwert42,105 %
21,053 %
Vals AI
Quellendetails
Datenstand: 14.10.2026
Vals IndexFinance Agent v2
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: benchmark scoreBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
49,05 %
Höherer Messwert56,637 %
Vals AI
Quellendetails
Datenstand: 13.10.2026
EMBLBO
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
59,445 %
Höherer Messwert60,69 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Finance Agent (v2)Disclosure Analysis
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
55,634 %
Höherer Messwert67,252 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Harvey's Legal Agent BenchmarkArbitration International Dispute Resolution · Task fully resolved
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
Kein direkter Sieger0 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
Legal Research BenchBusiness & Commercial · Weighted partial credit
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: weighted partial-credit scoreBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
80,401 %
Höherer Messwert86,88 %
Vals AI
Quellendetails
Datenstand: 12.10.2026
LMArena Text, Style ControlEnglish
Testdetails
Kein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-6 Sol: Snapshot: gpt-6-sol-max, Reasoning: max, Harness: Arena Text, style control
Muse Wonder: Snapshot: muse-wonder-max, Reasoning: max, Harness: Arena Text, style control
GPT-6 Sol: Arena-Bewertung aus 4.618 veröffentlichten Paarvergleichen.Muse Wonder: Arena-Bewertung aus 802 veröffentlichten Paarvergleichen.
1.460,65
95-%-Konfidenzintervall: ±9,352Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis.
Gewinner1.523,395
95-%-Konfidenzintervall: ±20,831Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis.
LMArena
Quellendetails
Datenstand: 13.10.2026
Tax Agent BenchCurrent & Temporal Analysis
Testdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserGPT-6 Sol: Reasoning: max, Ausgabegrenze: 128.000 tokens
Muse Wonder: Reasoning: max, Temperatur: 1, Ausgabegrenze: 131.072 tokens
56,104 %
Höherer Messwert77,655 %
Vals AI
Quellendetails
Datenstand: 12.10.2026

Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand

Eigene Modelltests

Unsere Tests

Für diese Auswahl gibt es keine gemeinsame Testrunde. Es werden keine Ergebnisse aus verschiedenen Runden gemischt.

Frühere Tests

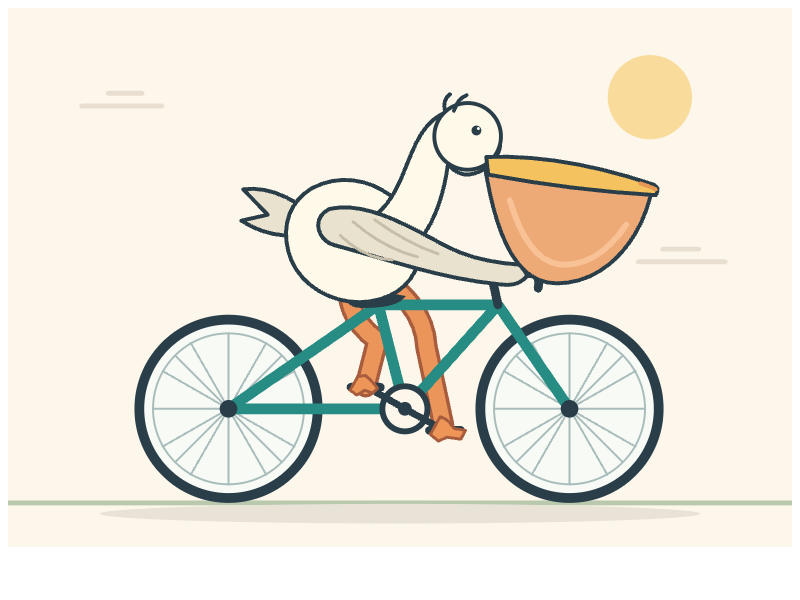
Pelikan auf dem Fahrrad

Community-Klassiker für eine freie SVG-Zeichnung.

GPT-6 Sol

GPT-6 Sol: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

Reasoning (angefragt): high

Aktueller Versuch
Datum des Testlaufs
01.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
openai/gpt-6-sol
API-Modell laut Antwort
openai/gpt-6-sol
Reasoning-Einstellung
high
Festgelegter Endpunkt
OpenAI | openai/gpt-6-sol-20260922
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung
Antwortzeit
80,5 s

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

Muse Wonder

Noch nicht getestet

Prompt und Testbedingungen

Generate an SVG of a pelican riding a bicycle

Tokenlimit inklusive Reasoning: 8.192 Token

Ursprung der Aufgabe (Simon Willison)

So liest du den Vergleich

Ein Benchmark-Sieg ist kein Gesamturteil

Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.

Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.

Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.

Weitere Duelle

Vergleiche GPT-6 Sol und Muse Wonder mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.
Zum vollständigen LLM-Vergleich