Zum Hauptinhalt springen

GPT-5.4 minivs.Qwen 3.8 27B

Wer ist besser?

Im Gesamtindex gleichauf, der Abstand ist zu klein für einen klaren Sieger. Qwen 3.8 27B ist günstiger: GPT-5.4 mini kostet je Token 18,8-mal (Eingabe) und 1,8-mal (Ausgabe) so viel.

LeistungGesamtindex, 0 bis 100 · höher ist besser
5

GPT-5.4 mini

Platz 54 bis 60

11

Qwen 3.8 27B

Platz 44 bis 57

TempoToken pro Sekunde · höher ist besser
230

GPT-5.4 mini

schnell

40

Qwen 3.8 27B

langsam

PreisDollar je 1 Mio. Token · niedriger ist besser
1,69 $

GPT-5.4 mini

eher teuer

0,66 $

Qwen 3.8 27B

eher günstig

GPT-5.4 mini

Im Abo

Kein Abo von OpenAI mit diesem Modell. Über andere Anbieter ab ≈ 6,36 € im Monat (ElevenLabs Starter, mit begrenztem Guthaben). 36 Tarife in Deutschland.

Per API

0,75 $ Eingabe, 4,50 $ Ausgabe je 1 Mio. Token, unverändert seit Beginn unserer Preiserfassung am 14.08.2026.

Qwen 3.8 27B

Im Abo

Kein Abo von Alibaba mit diesem Modell. Über andere Anbieter ab ≈ 1,06 € im Monat (Command Code Go, mit begrenztem Guthaben). 10 Tarife in Deutschland.

Per API

0,04 $ Eingabe, 2,50 $ Ausgabe je 1 Mio. Token laut Anbieter; im Preisindex steht das Modell seit 27.10.2026 mit 0,42 $ und 3 $.

Gesamtindex mit Daten bis 29.10.2026 · Preise vom 29.10.2026 · Tempo: Messung von Artificial Analysis · Abos vom 24.10.2026 · Abo-Preise inkl. USt

Wo liegt der Unterschied?

Werte von 0 bis 100 je Aufgabenbereich. Einen Sieger nennen wir nur, wenn der Abstand groß genug ist und es genug Tests gibt.

GPT-5.4 mini vorn: 0Qwen 3.8 27B vorn: 4gleichauf: 2zu wenig Daten: 4von 10 Bereichen

GPT-5.4 miniQwen 3.8 27B0 bis 100, höher ist besser
Bereiche im Gesamtindex
ProgrammierenQwen 3.8 27B vornGPT-5.4 mini: 5Qwen 3.8 27B: 13
SchlussfolgerngleichaufGPT-5.4 mini: 7Qwen 3.8 27B: 6
Mathematiknur Qwen 3.8 27B mit WertungGPT-5.4 mini: zu wenig DatenQwen 3.8 27B: 8
Wissenzu wenig DatenGPT-5.4 mini: 4Qwen 3.8 27B: 5
AgentengleichaufGPT-5.4 mini: 9Qwen 3.8 27B: 21
Allgemeinnur GPT-5.4 mini mit WertungGPT-5.4 mini: 11Qwen 3.8 27B: zu wenig Daten
MultimodalQwen 3.8 27B vornGPT-5.4 mini: 6Qwen 3.8 27B: 13
Fachgebiete
FinanzenQwen 3.8 27B vornGPT-5.4 mini: 5Qwen 3.8 27B: 34
RechtQwen 3.8 27B vornGPT-5.4 mini: 3Qwen 3.8 27B: 23
Gesundheitnur Qwen 3.8 27B mit WertungGPT-5.4 mini: zu wenig DatenQwen 3.8 27B: 3
1 weitere Bereiche anzeigen, die nicht zum Gesamtindex zählen
GPT-5.4 miniQwen 3.8 27B0 bis 100, höher ist besser
Cybersicherheitnur Qwen 3.8 27B mit WertungGPT-5.4 mini: zu wenig DatenQwen 3.8 27B: 19

Selbst ansehen: gleicher Auftrag, ein Versuch

Derselbe Prompt für beide Modelle. Gezeigt wird der neueste Versuch ohne Nachbesserung; er zählt nicht zum Gesamtindex.

Pelikan auf dem Fahrrad

Community-Klassiker für eine freie SVG-Zeichnung.

GPT-5.4 mini
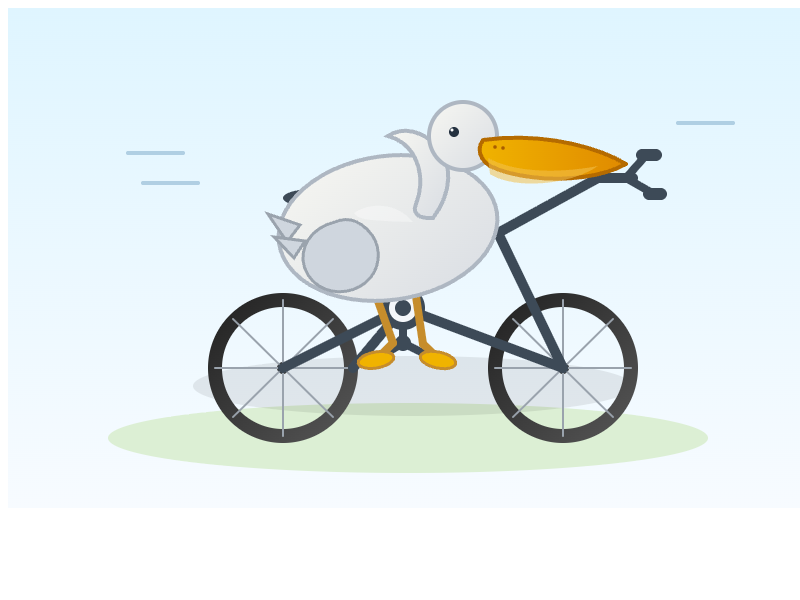
GPT-5.4 mini: Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.

Reasoning (angefragt): high

Aktueller Versuch
Datum des Testlaufs
02.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
openai/gpt-5.4-mini
API-Modell laut Antwort
openai/gpt-5.4-mini
Reasoning-Einstellung
high
Festgelegter Endpunkt
OpenAI | openai/gpt-5.4-mini-20260317
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung
Antwortzeit
13,5 s

Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.

Frühere Versuche (2)
  • 01.10.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high
  • 07.09.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high

Qwen 3.8 27B

Noch nicht getestet

Prompt und Testbedingungen

Generate an SVG of a pelican riding a bicycle

Tokenlimit inklusive Reasoning: 8.192 Token

Ursprung der Aufgabe (Simon Willison)
SVG-Kurztest

SVG-Kurztest

Ein SVG-Auftrag mit denselben festen Einstellungen für alle Modelle, ohne verdecktes Nachdenken.

Gemeinsame Testrunde: 43b8c5c46830

GPT-5.4 mini

In dieser Runde nicht verfügbar

Qwen 3.8 27B
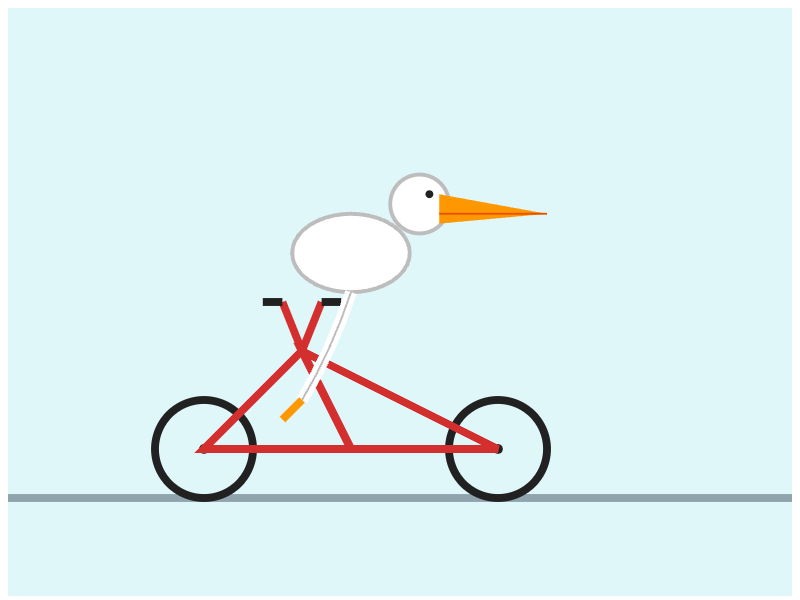
Qwen 3.8 27B: SVG-Kurztest
Testlauf: 14.10.2026 · alibaba
TestdetailsAPI meldet 0 Reasoning-TokensAPI-Modell: qwen/qwen3.8-27b865 Ausgabe-Token

Alle Daten im Vergleich

Der bessere Wert ist fett. Beim Gesamtindex nur, wenn der Abstand klar ist.

KennzahlGPT-5.4 miniQwen 3.8 27B
Leistung
Gesamtindex0 bis 100, höher ist besser511
PlatzPlatz 54 bis 60 von 95Platz 44 bis 57 von 95
Preis je 1 Mio. Token
Eingabewas du schickst0,75 $0,04 $
Ausgabewas das Modell schreibt4,50 $2,50 $
Tempo
Token pro Sekunde23040
Technik
Kontextfensterwie viel Text das Modell auf einmal liest400.000 Token≈ 600 A4-Seiten262.144 Token≈ 390 A4-Seiten
Wissensstand31.08.2025k. A.
Veröffentlicht17.03.202614.08.2026
VerfügbarkeitAktivAktiv
Offene Gewichteneinja

Preise ohne Rabatte für Zwischenspeicher und Stapelverarbeitung · Seitenzahl als Faustregel nach Artificial Analysis

Gemeinsame Benchmarks

Einzelwerte aus derselben Benchmark-Version, Aufgabe und Messgröße. Fett ist ein Wert nur bei gleichem Testaufbau und klarem Abstand.

A: GPT-5.4 miniB: Qwen 3.8 27B

Code MigrationOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 12,9 %Qwen 3.8 27B: 14,2 %Vals AIStand 18.10.2026
CritPt v2Overall · höher ist besserGPT-5.4 mini: 2,9 %Qwen 3.8 27B: 0,0 %Artificial AnalysisStand 29.10.2026
EMBOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 45,4 %Qwen 3.8 27B: 59,7 %Vals AIStand 20.10.2026
Finance Agent (v2)Overall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 45,4 %Qwen 3.8 27B: 48,6 %Vals AIStand 20.10.2026
GDPval-AAOverall · höher ist besserGPT-5.4 mini: 597,62 eloQwen 3.8 27B: 1.082,47 eloArtificial AnalysisStand 29.10.2026
GPQA DiamondOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 83,1 %Qwen 3.8 27B: 88,9 %Vals AIStand 01.09.2026
Legal Research BenchOverall · All-pass · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 12,5 %Qwen 3.8 27B: 36,1 %Vals AIStand 26.10.2026
LiveCodeBenchOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 81,5 %Qwen 3.8 27B: 84 %Vals AIStand 01.09.2026
MMLU ProOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 84,6 %Qwen 3.8 27B: 84,3 %Vals AIStand 01.09.2026
MMMU ProOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 79,2 %Qwen 3.8 27B: 83,9 %Vals AIStand 01.09.2026
54 weitere Benchmarks anzeigen
MMMU-ProOverall · höher ist besserGPT-5.4 mini: 71,2 %Qwen 3.8 27B: 74,2 %Artificial AnalysisStand 29.10.2026
MortgageTaxOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 63,5 %Qwen 3.8 27B: 64,9 %Vals AIStand 01.09.2026
ProgramBenchOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 0 %Qwen 3.8 27B: 0 %Vals AIStand 20.10.2026
SWE-bench VerifiedOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 73 %Qwen 3.8 27B: 86 %Vals AIStand 01.09.2026
Tax Agent BenchOverall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 8,8 %Qwen 3.8 27B: 30,9 %Vals AIStand 26.10.2026
TaxEval v2Overall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 71,2 %Qwen 3.8 27B: 70,9 %Vals AIStand 01.09.2026
Terminal-Bench 2.1Overall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 54,7 %Qwen 3.8 27B: 58,4 %Vals AIStand 01.10.2026
Vibe Code Bench v1.1Overall · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 48 %Qwen 3.8 27B: 64,9 %Vals AIStand 26.10.2026
Code MigrationCLI · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 8,2 %Qwen 3.8 27B: 2,2 %Vals AIStand 18.10.2026
CritPt v2Overall · höher ist besserGPT-5.4 mini: 0,0 %Qwen 3.8 27B: 0,3 %Artificial AnalysisStand 29.10.2026
EMBComps · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 40,5 %Qwen 3.8 27B: 53,3 %Vals AIStand 20.10.2026
Finance Agent (v2)Adjustments · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 45,4 %Qwen 3.8 27B: 47,3 %Vals AIStand 20.10.2026
GDPval-AAOverall · höher ist besserGPT-5.4 mini: 1.022,2 eloQwen 3.8 27B: 1.427,26 eloArtificial AnalysisStand 29.10.2026
GPQA DiamondFew-Shot CoT · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 84,8 %Qwen 3.8 27B: 88,9 %Vals AIStand 01.09.2026
Legal Research BenchAdministrative / Regulatory · All-pass · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 15,2 %Qwen 3.8 27B: 45,5 %Vals AIStand 26.10.2026
LiveCodeBenchEasy · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 97,8 %Qwen 3.8 27B: 99,1 %Vals AIStand 01.09.2026
MMLU ProBiology · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 91,4 %Qwen 3.8 27B: 91,5 %Vals AIStand 01.09.2026
MMMU-ProOverall · höher ist besserGPT-5.4 mini: 60,5 %Qwen 3.8 27B: 69,9 %Artificial AnalysisStand 29.10.2026
MortgageTaxNumerical Extraction · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 79,4 %Qwen 3.8 27B: 69,4 %Vals AIStand 01.09.2026
ProgramBenchAlmost Resolved · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 3 %Qwen 3.8 27B: 1 %Vals AIStand 20.10.2026
SWE-bench Verified<15 min fix · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 85,6 %Qwen 3.8 27B: 90,2 %Vals AIStand 01.09.2026
Tax Agent BenchControversy & Precedence Analysis · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 3,3 %Qwen 3.8 27B: 6,7 %Vals AIStand 26.10.2026
TaxEval v2Correctness · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 63 %Qwen 3.8 27B: 60,1 %Vals AIStand 01.09.2026
Terminal-Bench 2.1Easy · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 75 %Qwen 3.8 27B: 50 %Vals AIStand 01.10.2026
Code MigrationCOBOL · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 27,1 %Qwen 3.8 27B: 50 %Vals AIStand 18.10.2026
CritPt v2Overall · höher ist besserGPT-5.4 mini: 10,0 %Qwen 3.8 27B: 5,4 %Artificial AnalysisStand 29.10.2026
EMBDataroom · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 48,3 %Qwen 3.8 27B: 79,7 %Vals AIStand 20.10.2026
Finance Agent (v2)All-Pass · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 32,4 %Qwen 3.8 27B: 36,8 %Vals AIStand 20.10.2026
GPQA DiamondZero-Shot CoT · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 81,3 %Qwen 3.8 27B: 88,9 %Vals AIStand 01.09.2026
Legal Research BenchAdministrative / Regulatory · Weighted partial credit · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 69,7 %Qwen 3.8 27B: 88,5 %Vals AIStand 26.10.2026
LiveCodeBenchHard · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 61,7 %Qwen 3.8 27B: 65,7 %Vals AIStand 01.09.2026
MMLU ProBusiness · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 89,7 %Qwen 3.8 27B: 90,2 %Vals AIStand 01.09.2026
MMMU-ProOverall · höher ist besserGPT-5.4 mini: 73,3 %Qwen 3.8 27B: 76,3 %Artificial AnalysisStand 29.10.2026
MortgageTaxSemantic Extraction · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 47,6 %Qwen 3.8 27B: 60,5 %Vals AIStand 01.09.2026
ProgramBenchFully Resolved · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 0 %Qwen 3.8 27B: 0 %Vals AIStand 20.10.2026
SWE-bench Verified>4 hours · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 0 %Qwen 3.8 27B: 66,7 %Vals AIStand 01.09.2026
Tax Agent BenchControversy & Precedence Analysis · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 32,2 %Qwen 3.8 27B: 48,3 %Vals AIStand 26.10.2026
TaxEval v2Stepwise Reasoning · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 79,4 %Qwen 3.8 27B: 81,6 %Vals AIStand 01.09.2026
Terminal-Bench 2.1Hard · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 34,4 %Qwen 3.8 27B: 43,3 %Vals AIStand 01.10.2026
Code MigrationCode Quality · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 3,053 / 5Qwen 3.8 27B: 4,197 / 5Vals AIStand 18.10.2026
EMBDCF · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 40,6 %Qwen 3.8 27B: 50 %Vals AIStand 20.10.2026
Finance Agent (v2)Comparables · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 40,3 %Qwen 3.8 27B: 38,9 %Vals AIStand 20.10.2026
Legal Research BenchBusiness & Commercial · All-pass · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 11,6 %Qwen 3.8 27B: 41,9 %Vals AIStand 26.10.2026
LiveCodeBenchMedium · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 84,9 %Qwen 3.8 27B: 87,2 %Vals AIStand 01.09.2026
MMLU ProChemistry · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 89,1 %Qwen 3.8 27B: 91,8 %Vals AIStand 01.09.2026
ProgramBenchRaw Pass Rate · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 54,4 %Qwen 3.8 27B: 11,2 %Vals AIStand 20.10.2026
SWE-bench Verified1-4 hours · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 33,3 %Qwen 3.8 27B: 69 %Vals AIStand 01.09.2026
Tax Agent BenchCurrent & Temporal Analysis · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 10 %Qwen 3.8 27B: 43,1 %Vals AIStand 26.10.2026
Terminal-Bench 2.1Medium · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 64,2 %Qwen 3.8 27B: 67,3 %Vals AIStand 01.10.2026
EMBLBO · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 41,6 %Qwen 3.8 27B: 53,7 %Vals AIStand 20.10.2026
Finance Agent (v2)Disclosure Analysis · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 48,3 %Qwen 3.8 27B: 60,3 %Vals AIStand 20.10.2026
Legal Research BenchBusiness & Commercial · Weighted partial credit · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 71,2 %Qwen 3.8 27B: 86,8 %Vals AIStand 26.10.2026
MMLU ProComputer Science · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 87,1 %Qwen 3.8 27B: 88,3 %Vals AIStand 01.09.2026
SWE-bench Verified15 min - 1 hour · höher ist besserTestaufbau nicht identisch dokumentiertGPT-5.4 mini: 70,9 %Qwen 3.8 27B: 85,8 %Vals AIStand 01.09.2026

Anderes Duell vergleichen