Claude Opus 4.8
In dieser Runde nicht verfügbar
Direktvergleich
Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.
Steckbrief
Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.
| Merkmal | Claude Opus 4.8 | GPT-5.6 Terra |
|---|---|---|
| Anbieter | Anthropic | OpenAI |
| Erschienen | Mai 2026 | 9. Juli 2026 |
| Verfügbarkeit | Legacy | Aktiv |
| Modelltyp | Proprietär | Proprietär |
| Parameter | Nicht veröffentlicht | Nicht veröffentlicht |
| Architektur | Nicht veröffentlicht | Nicht veröffentlicht |
| Kontextfenster | 1.000.000 Token | 1.050.000 Token |
| Wissensstand | Januar 2026 | 16. Februar 2026 |
| Technische Quellen | Modell, Wissensstand | Modell, Kontext, Wissensstand |
Kosten
Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.
| Preisart | Claude Opus 4.8 | GPT-5.6 Terra |
|---|---|---|
| API-Eingabe | 5 $ | 2 $ ≤272K / 4 $ >272K |
| API-Ausgabe | 25 $ | 12 $ ≤272K / 18 $ >272K |
| Cache lesen | 0,5 $ | 0,2 $ ≤272K / 0,4 $ >272K |
| Cache schreiben (5 Min.) | 6,25 $ | 2,5 $ ≤272K / 5 $ >272K |
| Cache schreiben (1 Std.) | 10 $ | Nicht ausgewiesen |
| Preis geprüft | 22.09.2026 Quelle | 22.09.2026 Quelle |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.
Für Claude Opus 4.8 ist im gespeicherten OpenRouter-Stand kein Anbietertarif verfügbar. Der offizielle Direktpreis wird trotzdem angezeigt.
| Modell | Anbieter | Bezugsweg und Tarif | Eingabe pro 1 Mio. Token | Ausgabe pro 1 Mio. Token | Quelle |
|---|---|---|---|---|---|
| Claude Opus 4.8 | Anthropic | Direkt beim EntwicklerStandard-API | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle22.09.2026 |
| GPT-5.6 Terra | OpenAI | Direkt beim EntwicklerBis 272.000 Kontext-Token | 2 $ | 12 $ | Quelle22.09.2026 |
| OpenAI | Direkt beim EntwicklerÜber 272.000 Kontext-Token | 4 $ | 18 $ | Quelle22.09.2026 | |
| Amazon Bedrock | Über OpenRouteramazon-bedrock/us-east-1 | 2,2 $ | 13,2 $ | Quelle26.10.2026 | |
| Azure | Über OpenRouterazure | 2 $ | 12 $ | Quelle26.10.2026 | |
| Azure | Über OpenRouterazure/eu | 2,2 $ | 13,2 $ | Quelle26.10.2026 | |
| Azure | Über OpenRouterazure/us | 2,2 $ | 13,2 $ | Quelle26.10.2026 | |
| OpenAI | Über OpenRouteropenai | 2 $ | 12 $ | Quelle26.10.2026 | |
| OpenAI | Über OpenRouteropenai/fast | 4 $ | 24 $ | Quelle26.10.2026 | |
| OpenAI | Über OpenRouteropenai/flex | Günstigster erfasster Preis: 1 $ | Günstigster erfasster Preis: 6 $ | Quelle26.10.2026 |
Benchmark-Index
Der Index fasst unabhängige Benchmarks auf einer Skala von 0 bis 100 zusammen. Ein Vorsprung zählt erst, wenn ein Modell in mindestens 95 % von 200 Neuberechnungen mit zufällig neu gezogenen Testfamilien vorn liegt. Sonst gelten beide als gleichauf.
Claude Opus 4.8 liegt in 5 von 11 gemeinsamen Bereichen vorn. In 5 Bereichen liegen beide gleichauf.
| Bereich | Claude Opus 4.8 | GPT-5.6 Terra |
|---|---|---|
| Programmierengleichauf | 55,3 | 61,3 |
| Schlussfolgerngleichauf | 46,2 | 56,6 |
| Wissen | 65,6 | 29,3 |
| Agentengleichauf | 56,7 | 61,8 |
| Allgemein | 45,3 | 63,6 |
| Finanzengleichauf | 65,0 | 60,4 |
| Rechtgleichauf | 57,4 | 41,4 |
| Gesundheit | 67,8 | 40,3 |
| Multimodal | 55,0 | 47,7 |
| Produktivität | 68,3 | 49,1 |
| Bildung | 71,1 | 56,5 |
Leistung
Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.
Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.
14 passende Messreihen aus 12 Benchmarkfamilien wurden berücksichtigt. Das Radar zeigt 7 von 7 vergleichbaren Kategorien.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
| Benchmark und Aufgabe | Claude Opus 4.8 | GPT-5.6 Terra | Quelle |
|---|---|---|---|
AA-BriefcaseOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v1.1Messgröße: AA-Briefcase EloBewertung: Mehr ist besserClaude Opus 4.8: Snapshot: Claude Opus 4.8 (Max), Reasoning: Max GPT-5.6 Terra: Snapshot: GPT-5.6 Terra (Max), Reasoning: MaxClaude Opus 4.8: Exakte AA-Konfiguration: Claude Opus 4.8 (Max) (Release claude-opus-4-8, Zeile claude-opus-4-8, UUID 992b7b84-5069-4c6a-9295-834252553d50, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-5.6 Terra: Exakte AA-Konfiguration: GPT-5.6 Terra (Max) (Release gpt-5-6-terra, Zeile gpt-5-6-terra, UUID bcf8db0a-3bb6-4d82-9516-0f57370c85a6, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 1.321,43 elo | Gewinner1.334,22 elo | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
AA-LCROverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v1.1Messgröße: Pass rateBewertung: Mehr ist besserClaude Opus 4.8: Snapshot: Claude Opus 4.8 (Max), Reasoning: Max GPT-5.6 Terra: Snapshot: GPT-5.6 Terra (Max), Reasoning: MaxClaude Opus 4.8: Exakte AA-Konfiguration: Claude Opus 4.8 (Max) (Release claude-opus-4-8, Zeile claude-opus-4-8, UUID 992b7b84-5069-4c6a-9295-834252553d50, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-5.6 Terra: Exakte AA-Konfiguration: GPT-5.6 Terra (Max) (Release gpt-5-6-terra, Zeile gpt-5-6-terra, UUID bcf8db0a-3bb6-4d82-9516-0f57370c85a6, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 77,7 % | Gewinner83,0 % | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
AA-OmniscienceOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: AA-Omniscience IndexBewertung: Mehr ist besserClaude Opus 4.8: Snapshot: Claude Opus 4.8 (Max), Reasoning: Max GPT-5.6 Terra: Snapshot: GPT-5.6 Terra (Max), Reasoning: MaxClaude Opus 4.8: Exakte AA-Konfiguration: Claude Opus 4.8 (Max) (Release claude-opus-4-8, Zeile claude-opus-4-8, UUID 992b7b84-5069-4c6a-9295-834252553d50, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-5.6 Terra: Exakte AA-Konfiguration: GPT-5.6 Terra (Max) (Release gpt-5-6-terra, Zeile gpt-5-6-terra, UUID bcf8db0a-3bb6-4d82-9516-0f57370c85a6, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | Gewinner28,75 Punkte Der Index kann negative Werte annehmen und reicht laut Anbieter von -100 bis 100. | 0,05 Punkte Der Index kann negative Werte annehmen und reicht laut Anbieter von -100 bis 100. | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
AA-Omniscience AccuracyOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: AA Omniscience diagnosticMessgröße: AA-Omniscience AccuracyBewertung: Mehr ist besserClaude Opus 4.8: Snapshot: Claude Opus 4.8 (Max), Reasoning: Max, Versuche: AA-reported aggregate; diagnostic-specific run count is not stated on the leaderboard GPT-5.6 Terra: Snapshot: GPT-5.6 Terra (Max), Reasoning: Max, Versuche: AA-reported aggregate; diagnostic-specific run count is not stated on the leaderboardClaude Opus 4.8: Exakte AA-Konfiguration: Claude Opus 4.8 (Max) (Release claude-opus-4-8, Zeile claude-opus-4-8, UUID 992b7b84-5069-4c6a-9295-834252553d50, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. Anteil der insgesamt korrekt beantworteten Fragen, unabhängig davon, ob das Modell andere Fragen beantwortet oder sich enthält.GPT-5.6 Terra: Exakte AA-Konfiguration: GPT-5.6 Terra (Max) (Release gpt-5-6-terra, Zeile gpt-5-6-terra, UUID bcf8db0a-3bb6-4d82-9516-0f57370c85a6, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. Anteil der insgesamt korrekt beantworteten Fragen, unabhängig davon, ob das Modell andere Fragen beantwortet oder sich enthält. | Gewinner48,8 % Dies ist die separat veröffentlichte Genauigkeitsdiagnostik, nicht der AA-Omniscience-Index. AA bezeichnet höhere Werte als besser. | 46,8 % Dies ist die separat veröffentlichte Genauigkeitsdiagnostik, nicht der AA-Omniscience-Index. AA bezeichnet höhere Werte als besser. | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
AA-Omniscience Hallucination RateOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: AA Omniscience diagnosticMessgröße: AA-Omniscience Hallucination RateBewertung: Weniger ist besserClaude Opus 4.8: Snapshot: Claude Opus 4.8 (Max), Reasoning: Max, Versuche: AA-reported aggregate; diagnostic-specific run count is not stated on the leaderboard GPT-5.6 Terra: Snapshot: GPT-5.6 Terra (Max), Reasoning: Max, Versuche: AA-reported aggregate; diagnostic-specific run count is not stated on the leaderboardClaude Opus 4.8: Exakte AA-Konfiguration: Claude Opus 4.8 (Max) (Release claude-opus-4-8, Zeile claude-opus-4-8, UUID 992b7b84-5069-4c6a-9295-834252553d50, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. Anteil falscher Antworten an allen nicht korrekten Antworten: falsch / (falsch + teilweise richtig + nicht beantwortet).GPT-5.6 Terra: Exakte AA-Konfiguration: GPT-5.6 Terra (Max) (Release gpt-5-6-terra, Zeile gpt-5-6-terra, UUID bcf8db0a-3bb6-4d82-9516-0f57370c85a6, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. Anteil falscher Antworten an allen nicht korrekten Antworten: falsch / (falsch + teilweise richtig + nicht beantwortet). | Gewinner39,3 % Dies ist die separat veröffentlichte Halluzinationsraten-Diagnostik, nicht der AA-Omniscience-Index. AA bezeichnet niedrigere Werte als besser. | 87,9 % Dies ist die separat veröffentlichte Halluzinationsraten-Diagnostik, nicht der AA-Omniscience-Index. AA bezeichnet niedrigere Werte als besser. | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
Artificial Analysis Intelligence IndexOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v4.3.2Messgröße: Artificial Analysis Intelligence IndexBewertung: Mehr ist besserClaude Opus 4.8: Snapshot: Claude Opus 4.8 (Max), Reasoning: Max GPT-5.6 Terra: Snapshot: GPT-5.6 Terra (Max), Reasoning: MaxClaude Opus 4.8: Exakte AA-Konfiguration: Claude Opus 4.8 (Max) (Release claude-opus-4-8, Zeile claude-opus-4-8, UUID 992b7b84-5069-4c6a-9295-834252553d50, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-5.6 Terra: Exakte AA-Konfiguration: GPT-5.6 Terra (Max) (Release gpt-5-6-terra, Zeile gpt-5-6-terra, UUID bcf8db0a-3bb6-4d82-9516-0f57370c85a6, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 41,79 Punkte | Gewinner42,083 Punkte | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
AutomationBench-AAOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: Objectives completed without guardrail violationsBewertung: Mehr ist besserClaude Opus 4.8: Snapshot: Claude Opus 4.8 (Max), Reasoning: Max GPT-5.6 Terra: Snapshot: GPT-5.6 Terra (Max), Reasoning: MaxClaude Opus 4.8: Exakte AA-Konfiguration: Claude Opus 4.8 (Max) (Release claude-opus-4-8, Zeile claude-opus-4-8, UUID 992b7b84-5069-4c6a-9295-834252553d50, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-5.6 Terra: Exakte AA-Konfiguration: GPT-5.6 Terra (Max) (Release gpt-5-6-terra, Zeile gpt-5-6-terra, UUID bcf8db0a-3bb6-4d82-9516-0f57370c85a6, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 45,6 % | Gewinner59,6 % | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
BrowseCompOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 1,266 tasksMessgröße: accuracyBewertung: Mehr ist besserHerstellerübergreifende Vergleichstabelle mit Browser-Werkzeugen. Die genauen Agentensysteme unterscheiden sich. | 84,3 % Redaktionelle Auswahl aus der Hersteller-Tabelle, kein vollständiger Auszug der Vergleichsgruppe. | Gewinner87,5 % Redaktionelle Auswahl aus der Hersteller-Tabelle, kein vollständiger Auszug der Vergleichsgruppe. | OpenAIQuellendetailsDatenstand: 09.07.2026 |
Code MigrationOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 47,25 % | Höherer Messwert47,804 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
CorpFin v2OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens | Höherer Messwert66,706 % | 65,307 % | Vals AIQuellendetailsDatenstand: 12.08.2026 |
EMBOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert69,373 % | 66,205 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Finance Agent (v2)OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 53,918 % | Höherer Messwert54,436 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
GDP.pdfOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: All-pass rateBewertung: Mehr ist besserClaude Opus 4.8: Snapshot: Claude Opus 4.8 (Max), Reasoning: Max GPT-5.6 Terra: Snapshot: GPT-5.6 Terra (Max), Reasoning: MaxClaude Opus 4.8: Exakte AA-Konfiguration: Claude Opus 4.8 (Max) (Release claude-opus-4-8, Zeile claude-opus-4-8, UUID 992b7b84-5069-4c6a-9295-834252553d50, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-5.6 Terra: Exakte AA-Konfiguration: GPT-5.6 Terra (Max) (Release gpt-5-6-terra, Zeile gpt-5-6-terra, UUID bcf8db0a-3bb6-4d82-9516-0f57370c85a6, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 22,8 % | Gewinner24,0 % | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
GDPval-AAOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: v2.1Messgröße: GDPval-AA EloBewertung: Mehr ist besserClaude Opus 4.8: Snapshot: Claude Opus 4.8 (Max), Reasoning: Max GPT-5.6 Terra: Snapshot: GPT-5.6 Terra (Max), Reasoning: MaxClaude Opus 4.8: Exakte AA-Konfiguration: Claude Opus 4.8 (Max) (Release claude-opus-4-8, Zeile claude-opus-4-8, UUID 992b7b84-5069-4c6a-9295-834252553d50, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-5.6 Terra: Exakte AA-Konfiguration: GPT-5.6 Terra (Max) (Release gpt-5-6-terra, Zeile gpt-5-6-terra, UUID bcf8db0a-3bb6-4d82-9516-0f57370c85a6, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | Gewinner1.453,47 elo | 1.451,58 elo | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
GPQA DiamondOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens | Höherer Messwert92,424 % | 90,909 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
Harvey's Legal Agent BenchmarkOverall · Task fully resolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: task resolution rateBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert9,583 % | 0,833 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Humanity's Last ExamOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: unspecifiedMessgröße: Text-only pass@1 accuracyBewertung: Mehr ist besserClaude Opus 4.8: Snapshot: Claude Opus 4.8 (Max), Reasoning: Max GPT-5.6 Terra: Snapshot: GPT-5.6 Terra (Max), Reasoning: MaxClaude Opus 4.8: Exakte AA-Konfiguration: Claude Opus 4.8 (Max) (Release claude-opus-4-8, Zeile claude-opus-4-8, UUID 992b7b84-5069-4c6a-9295-834252553d50, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-5.6 Terra: Exakte AA-Konfiguration: GPT-5.6 Terra (Max) (Release gpt-5-6-terra, Zeile gpt-5-6-terra, UUID bcf8db0a-3bb6-4d82-9516-0f57370c85a6, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | Gewinner48,7 % Der Anbieter beschreibt seine Vergleichsauswertung als text-only 2.158 Fragen, nicht als den vollständigen 2.500-Fragen-Datensatz. | 42,9 % Der Anbieter beschreibt seine Vergleichsauswertung als text-only 2.158 Fragen, nicht als den vollständigen 2.500-Fragen-Datensatz. | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
IFBenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: AA test set: 294 questionsMessgröße: IFBench prompt-level loose accuracy (pass@1)Bewertung: Mehr ist besserClaude Opus 4.8: Snapshot: Claude Opus 4.8 (Max), Reasoning: Max, Versuche: pass@1, 5 repeats per question GPT-5.6 Terra: Snapshot: GPT-5.6 Terra (Max), Reasoning: Max, Versuche: pass@1, 5 repeats per questionClaude Opus 4.8: Exakte AA-Konfiguration: Claude Opus 4.8 (Max) (Release claude-opus-4-8, Zeile claude-opus-4-8, UUID 992b7b84-5069-4c6a-9295-834252553d50, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. Artificial Analysis führt 294 Fragen aus dem IFBench-Testdatensatz mit fünf Wiederholungen je Frage aus. Der offizielle Evaluator bewertet die Genauigkeit je Prompt im Modus loose als pass@1.GPT-5.6 Terra: Exakte AA-Konfiguration: GPT-5.6 Terra (Max) (Release gpt-5-6-terra, Zeile gpt-5-6-terra, UUID bcf8db0a-3bb6-4d82-9516-0f57370c85a6, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. Artificial Analysis führt 294 Fragen aus dem IFBench-Testdatensatz mit fünf Wiederholungen je Frage aus. Der offizielle Evaluator bewertet die Genauigkeit je Prompt im Modus loose als pass@1. | 62,2 % Die Angabe von 58 bezieht sich auf die verifizierbaren Out-of-Domain-Bedingungstypen, nicht auf die Zahl der Fragen im AA-Testlauf. | Gewinner71,2 % Die Angabe von 58 bezieht sich auf die verifizierbaren Out-of-Domain-Bedingungstypen, nicht auf die Zahl der Fragen im AA-Testlauf. | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
Legal Research BenchOverall · All-passTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert43,75 % | 41,346 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LegalBenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 83,568 % | Höherer Messwert85,105 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
LiveCodeBench v6OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens | Höherer Messwert87,819 % | 85,93 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LMArena Text, Style ControlOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.8: Snapshot: claude-opus-4-8, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.8: Arena-Bewertung aus 65.172 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 43.271 veröffentlichten Paarvergleichen. | Höherer Messwert1.474,319 95-%-Konfidenzintervall: ±3,846Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.466,429 95-%-Konfidenzintervall: ±4,257Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 15.10.2026 |
LMArena Vision, Style ControlOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.8: Snapshot: claude-opus-4-8, Harness: Arena Vision, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Vision, style controlClaude Opus 4.8: Arena-Bewertung aus 18.852 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 11.020 veröffentlichten Paarvergleichen. | Höherer Messwert1.278,955 95-%-Konfidenzintervall: ±6,534Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.268,044 95-%-Konfidenzintervall: ±7,452Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
MedCodeOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 30.000 tokens GPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 30.000 tokens | Höherer Messwert53,217 % | 43,414 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
MedScribeOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 30.000 tokens GPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 30.000 tokens | Höherer Messwert85,755 % | 82,869 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
MMLU-ProOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens | Höherer Messwert89,585 % | 86,659 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MMMU-ProOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert86,59 % | 86,474 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MortgageTaxOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens | Höherer Messwert69,912 % | 67,329 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
ProgramBenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: fully resolved rateBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert1 % | 0,5 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Public Benefits Bench v1.1OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert68,133 % | 62,382 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
SAGEOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 30.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 30.000 tokens | Höherer Messwert54,788 % | 47,003 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
SkillsBenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Harness: OpenHands, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Harness: OpenHands, Ausgabegrenze: 128.000 tokens | Höherer Messwert59,227 % | 58,895 % | Vals AIQuellendetailsDatenstand: 27.09.2026 |
SWE-bench VerifiedOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 88,6 % | Höherer Messwert95,4 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
Tax Agent BenchOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 29,999 % | Höherer Messwert30,035 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
TaxEval v2OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens | 75,634 % | Höherer Messwert76,166 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
Terminal-BenchOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: 4.0Messgröße: Task successBewertung: Mehr ist besserClaude Opus 4.8: Snapshot: Claude Opus 4.8 (Max), Reasoning: Max GPT-5.6 Terra: Snapshot: GPT-5.6 Terra (Max), Reasoning: MaxClaude Opus 4.8: Exakte AA-Konfiguration: Claude Opus 4.8 (Max) (Release claude-opus-4-8, Zeile claude-opus-4-8, UUID 992b7b84-5069-4c6a-9295-834252553d50, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch.GPT-5.6 Terra: Exakte AA-Konfiguration: GPT-5.6 Terra (Max) (Release gpt-5-6-terra, Zeile gpt-5-6-terra, UUID bcf8db0a-3bb6-4d82-9516-0f57370c85a6, reasoning=true, source reasoning-token configuration budget=0, suffix=Max). Der konfigurierte Wert ist kein gemessener Tokenverbrauch. | 21,7 % | Gewinner35,4 % | Artificial AnalysisQuellendetailsDatenstand: 19.10.2026 |
Terminal-Bench 2.1OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 71,91 % | Höherer Messwert77,528 % | Vals AIQuellendetailsDatenstand: 28.09.2026 |
Terminal-Bench 4.0OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 4.0Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert23,232 % | 22,727 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Terminal-Bench ScienceOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Harness: Mini-SWE-agent, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Harness: Mini-SWE-agent, Ausgabegrenze: 128.000 tokens | 4,286 % | Höherer Messwert10 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Vals IndexOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: weighted index scoreBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert55,1 % | 53,085 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Vals Multimodal IndexOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.2Messgröße: weighted index scoreBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens | Höherer Messwert70,889 % | 65,07 % | Vals AIQuellendetailsDatenstand: 11.08.2026 |
Vibe Code Bench v1.1OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Harness: OpenHands, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Harness: OpenHands, Ausgabegrenze: 128.000 tokens | Höherer Messwert82,725 % | 74,594 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Code MigrationCLITestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 40,143 % | Höherer Messwert40,405 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
CorpFin v2Exact PagesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens | Höherer Messwert64,336 % | 63,17 % | Vals AIQuellendetailsDatenstand: 12.08.2026 |
EMBCompsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert72,797 % | 62,157 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Finance Agent (v2)AdjustmentsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 48,387 % | Höherer Messwert49,711 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
GPQA DiamondFew-Shot CoTTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens | Höherer Messwert91,919 % | 89,899 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
Harvey's Legal Agent BenchmarkAntitrust Competition · Criteria passedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: criteria pass rateBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert87,319 % | 77,536 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
Legal Research BenchAdministrative / Regulatory · All-passTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: all-pass rateBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 43,939 % | Höherer Messwert57,576 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LegalBenchConclusion TasksTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 88,937 % | Höherer Messwert90,327 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
LiveCodeBench v6EasyTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens | Höherer Messwert99,068 % | 97,205 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
LMArena Text, Style ControlOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.8: Snapshot: claude-opus-4-8-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.8: Arena-Bewertung aus 64.100 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 43.271 veröffentlichten Paarvergleichen. | Höherer Messwert1.481,495 95-%-Konfidenzintervall: ±3,868Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.466,429 95-%-Konfidenzintervall: ±4,257Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 15.10.2026 |
LMArena Vision, Style ControlOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.8: Snapshot: claude-opus-4-8-high, Reasoning: high, Harness: Arena Vision, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Vision, style controlClaude Opus 4.8: Arena-Bewertung aus 18.341 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 11.020 veröffentlichten Paarvergleichen. | Höherer Messwert1.285,632 95-%-Konfidenzintervall: ±6,5Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.268,044 95-%-Konfidenzintervall: ±7,452Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
MMLU-ProBiologyTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens | Höherer Messwert94,7 % | 93,026 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
MortgageTaxNumerical ExtractionTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens | Höherer Messwert79,73 % | 74,324 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
ProgramBenchAlmost ResolvedTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: almost-resolved rateBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert15,5 % | 15 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
SAGEAutomataTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 30.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 30.000 tokens | Höherer Messwert41,666 % | 38,889 % | Vals AIQuellendetailsDatenstand: 08.10.2026 |
SkillsBenchNo SkillsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Harness: OpenHands, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Harness: OpenHands, Ausgabegrenze: 128.000 tokens | 43,674 % | Höherer Messwert48,842 % | Vals AIQuellendetailsDatenstand: 27.09.2026 |
SWE-bench Verified<15 min fixTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 92,784 % | Höherer Messwert96,907 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
Tax Agent BenchControversy & Precedence AnalysisTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | 13,133 % | Höherer Messwert16,667 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
TaxEval v2CorrectnessTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 128.000 tokens | 64,513 % | Höherer Messwert65,822 % | Vals AIQuellendetailsDatenstand: 01.09.2026 |
Terminal-Bench 2.1EasyTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 2.1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Kein direkter Sieger100 % | Kein direkter Sieger100 % | Vals AIQuellendetailsDatenstand: 28.09.2026 |
Terminal-Bench 4.0HardwareTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 4.0Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Ausgabegrenze: 128.000 tokens | Höherer Messwert26,667 % | 0 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Terminal-Bench ScienceEarth SciencesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 0.1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.8: Compute: max, Harness: Mini-SWE-agent, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Harness: Mini-SWE-agent, Ausgabegrenze: 128.000 tokens | Kein direkter Sieger0 % | Kein direkter Sieger0 % | Vals AIQuellendetailsDatenstand: 14.10.2026 |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand | |||
Eigene Modelltests
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
Gemeinsame Testrunde: 43b8c5c46830
In dieser Runde nicht verfügbar
In dieser Runde nicht verfügbar
Community-Klassiker für eine freie SVG-Zeichnung.
Claude Opus 4.8
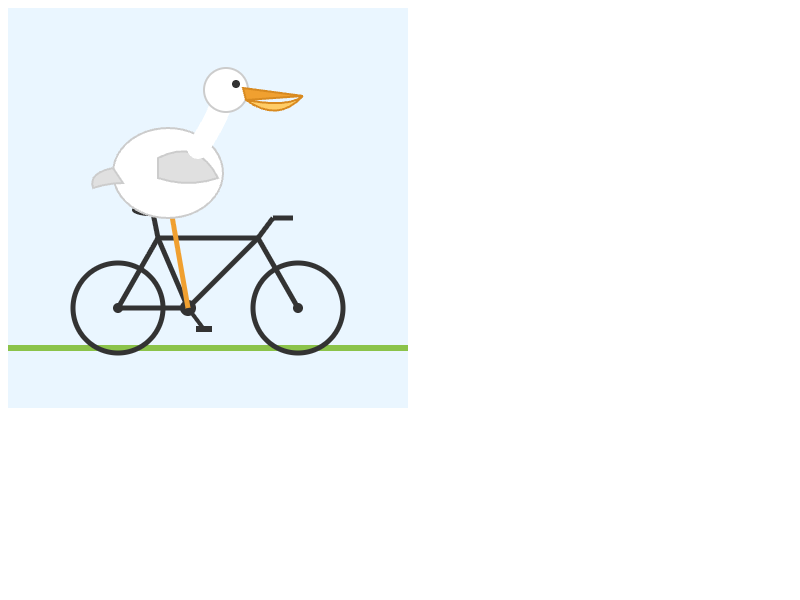
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
GPT-5.6 Terra
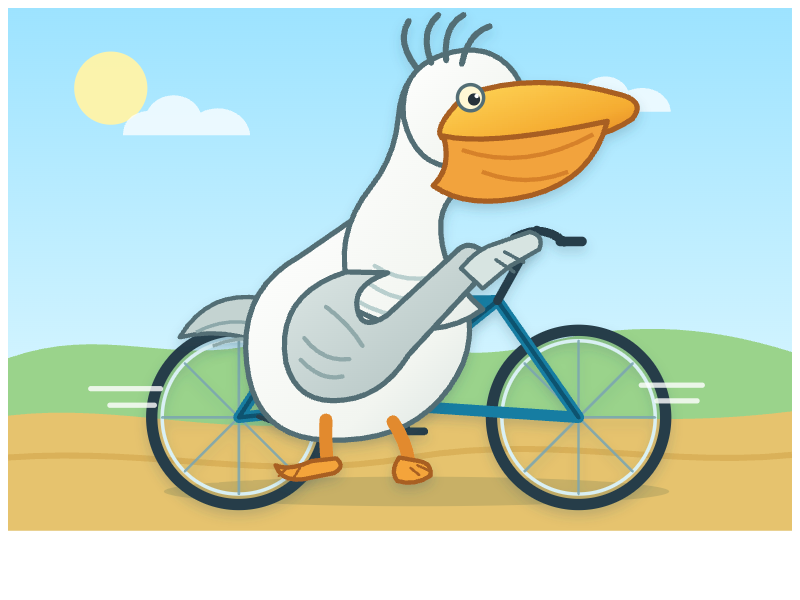
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)So liest du den Vergleich
Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.
Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.
Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.
Weitere Duelle
Vergleiche Claude Opus 4.8 und GPT-5.6 Terra mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.