Ich bin bei KI-Stimmen lange skeptisch gewesen.
Zu roboterhaft, zu monoton, zu sehr nach Bahnhofsdurchsage. Die meisten Tools, die ich über die Jahre ausprobiert habe, klangen wie ein Navigationsgerät aus 2015. Schön für eine Demo, aber nichts, was ich ernsthaft auf einen YouTube-Kanal oder in ein Hörbuch packen würde.
Dann kam ElevenLabs immer wieder in meinem Umfeld auf. Podcaster nutzen es, Synchronstudios reden darüber, in englischsprachigen KI-Kreisen gilt es seit Jahren als Referenz. Also habe ich es mir für diesen Artikel noch einmal ganz genau angeschaut, nicht nur kurz im kostenlosen Tarif herumgeklickt, sondern mit meinem Creator-Tarif, echten Texten und, wo es ging, mit konkreten, nachvollziehbaren Zahlen.
In diesem Erfahrungsbericht erzähle ich dir, was ich getestet habe, wo ElevenLabs für mich wirklich überzeugt, wo es Schwächen hat und für wen sich das Tool lohnt. Und für wen ehrlicherweise etwas Günstigeres reicht.
- Das Flaggschiff-Modell von ElevenLabs heißt inzwischen Eleven v3 und liefert die natürlichste KI-Sprachqualität, die ich bisher gehört habe, inklusive Audio-Tags wie [flüstert] und [lacht], mit denen du Emotion direkt im Text steuerst
- Ich habe neun Kernfunktionen bewertet und vier weitere Werkzeuge praktisch nachgetestet: Voice Design, Voice Remixing, Flows sowie Bild & Video. Music v2 habe ich zusätzlich mit eigenem deutschen Gesang geprüft. Die Stem-Trennung ließ sich starten, ihre Dateien aber nicht unabhängig kontrollieren. Dubbing v2 blieb auch im dritten Anlauf ohne Ergebnis
- Es ist keine reine Text-to-Speech-App, sondern eine ganze Audio-Plattform mit transparenter Credit-Abrechnung (rund 1 Credit pro Zeichen bei v3), die bei intensiver Nutzung aber auch schnell teurer werden kann
1. Mein Fazit vorweg
Damit du nicht den ganzen Artikel lesen musst, falls du es eilig hast: ElevenLabs ist für mich aktuell das beste KI-Tool für Stimmen am Markt.
Meine Note: 1,5.
Diese Note ist kein Bauchgefühl, sondern das gewichtete Ergebnis aus neun Einzelnoten, die ich dir in Sektion 3 mitsamt Beleg vorrechne. Ohne den Ausrutscher bei Dubbing v2, dem einzigen benoteten Kernwerkzeug ohne Ergebnis, wäre es eine 1,4. Bei den späteren Zusatztests blieben ebenfalls einzelne Schritte offen, die ich in Sektion 12.1 getrennt ausweise.
Die Sprachqualität von Eleven v3 ist auf einem Niveau, bei dem ich beim ersten Hören kurz gestutzt habe. Mit den Audio-Tags [flüstert] und [lacht] steuere ich Emotion direkt im Text. In meinen bisherigen Tests habe ich das bei keinem anderen Tool so erlebt, und weiter unten kannst du dir den Unterschied selbst anhören. Dazu kommt der größte Pluspunkt im Alltag: Ich habe Text-to-Speech, Voice Cloning, Scribe, einen Musikgenerator und Dubbing in einem einzigen Konto, statt für jede Aufgabe ein anderes Abo zu brauchen.
Allerdings:
Es ist nicht das günstigste Tool, und die Credit-Abrechnung kann bei viel Nutzung schnell teuer werden, vor allem beim Musikgenerator, wenn du die Länge auf „Automatisch“ stellst (dazu gleich mehr, das hat mich selbst überrascht). Der Free-Tarif hat außerdem kein Voice Cloning, und Dubbing v2 hat mir in drei Anläufen kein Ergebnis geliefert. Wenn du also nur ab und zu einen Blogartikel vertonen willst, reicht oft eine schlankere Lösung. Wer dagegen Stimme ernsthaft und regelmäßig nutzt, kommt an ElevenLabs gerade kaum vorbei.
Ausprobieren kostet dich nichts, der kostenlose Tarif von ElevenLabs reicht für die ersten Tests locker aus.
2. Mein Test-Setup: was ich wirklich gemacht habe
Für diesen Artikel bin ich nicht nur ein bisschen herumgeklickt, sondern habe mit echten Aufgaben und meinem eigenen Konto getestet.
Mein Workspace heißt „ElevenCreative“ und läuft auf dem Creator-Tarif für 22 $ im Monat, die Oberfläche selbst nutze ich dabei auf Deutsch. Als ich den ersten Teil dieses Tests gemacht habe, standen 16.748 von 131.000 Credits auf meinem Creator-Konto, das Kontingent erneuerte sich am 19. August. Die Basis im Creator-Tarif sind 121.000 Credits im Monat, die zusätzlichen rund 10.000 Credits stammen offenbar aus einer Aktion oder einem Rollover.
Damit die Hörproben untereinander überhaupt vergleichbar sind, habe ich mich vorher auf ein einziges deutsches Testskript festgelegt. Es läuft in diesem Artikel durch Text-to-Speech, durch den Stimmklon, durch den Voice Changer und am Ende sogar durch die Transkription, jedes Mal Wort für Wort identisch:
Hallo, ich bin Finn. Gerade teste ich, wie natürlich diese KI-Stimme deutschen Text vorliest. Achte einmal auf die Betonung, das Sprechtempo und die kleinen Pausen zwischen den Sätzen.Die Rahmenbedingungen habe ich genauso festgezurrt, sonst stünde jede Hörprobe für sich allein.
- Modell Eleven v3, außer wo ich ausdrücklich etwas anderes nenne. Der Voice Changer und Studio laufen bei ElevenLabs auf Eleven Multilingual v2.
- Stimme Liam („Energetic, Social Media Creator“), Stabilität in der Mitte zwischen Kreativ und Robust.
- Ausgabe als MP3 mit 44,1 kHz und 128 kbps.
- Testzeitraum 6. bis 29. August 2026.
Konkret habe ich getestet:
- Text-to-Speech mit Eleven v3, inklusive Audio-Tags, mit echten Generierungen und nachvollziehbarem Credit-Verbrauch.
- Denselben Text zusätzlich mit dem älteren Modell Eleven Multilingual v2 und mit einer deutschen Stimme, als direkten Vergleich zum Hören.
- Voice Cloning: Ich habe live einen Instant Voice Clone erstellt und stelle dir Original und Klon direkt gegenüber.
- Den Voice Changer, der meine fertige TTS-Stimme in eine ganz andere Stimme umgewandelt hat.
- Scribe (Sprache zu Text), gemessen an meinem eigenen TTS-Sample, bei dem ich den Originaltext Wort für Wort kenne.
- Music v2, inklusive Song-Editor, Inpainting, Genre-Wechsel und eigenem deutschen Songtext. Die Stem-Trennung habe ich angestoßen, die Ausgabedateien aber nicht unabhängig kontrolliert.
- Studio, die Langform-Umgebung für Hörbücher, mit einem vertonten Testabsatz.
- Die Soundeffekte, mit einem englischen Prompt für Regen und fernen Donner.
- Dubbing v2 in drei Anläufen, mit einer Datei, einer eigenen URL und einem offiziellen NASA-YouTube-Video. Alle drei blieben ohne fertiges Ergebnis.
- ElevenAgents: einen echten Customer-Support-Agenten aufgebaut und ein Testgespräch mit gemessenen Kosten geführt.
- Voice Design und Voice Remixing mit einer frei entworfenen historischen Erzählerstimme, die ausdrücklich keine reale Person imitiert.
- Bild & Video mit einem selbst erzeugten 16:9-Motiv und einer 4-sekündigen Animation über Veo 3.1 Fast.
- Flows mit einer deutschen Erzählerstimme, einem Bibliotheks-Soundeffekt und einem verbundenen Kompositionsknoten.
Bei den neun benoteten Kernfunktionen belege ich die hörbaren Ergebnisse soweit möglich direkt mit Audiodateien aus meinem Konto. Die zusätzlichen Nachtests dokumentiere ich mit ihrem tatsächlichen Status. Bei Dubbing v2 entstand in drei Versuchen keine Ausgabe, und warum das so ist, schreibe ich in Sektion 9 offen hin.
3. Mein Testurteil in Zahlen
Bevor ich Werkzeug für Werkzeug durchgehe, hier mein Urteil auf einen Blick. Jede Zeile nennt, womit ich getestet habe und wo im Artikel der Beleg dazu steht, damit du meine Noten nachrechnen kannst, statt sie mir zu glauben.
Wie komme ich damit auf meine Gesamtnote?
Ich gewichte nach Bedeutung im Alltag. Text zu Sprache zählt 30 % und Voice Cloning 20 %, weil das der Kern des Produkts ist. Scribe bekommt 15 %, ElevenAgents und Music v2 je 10 %, Voice Changer und Studio je 5 %, und die letzten 5 % teilen sich Soundeffekte und Dubbing. Rechnerisch ergibt das eine 1,49, also gerundet meine 1,5.
Ohne Dubbing v2 wäre es eine 1,4. Ich lasse den Ausreißer trotzdem in der Rechnung, weil ein Werkzeug, das in drei Anläufen kein Ergebnis liefert, in der Note auftauchen muss und nicht in einer Fußnote.
4. Text zu Sprache: Eleven v3 und Audio Tags
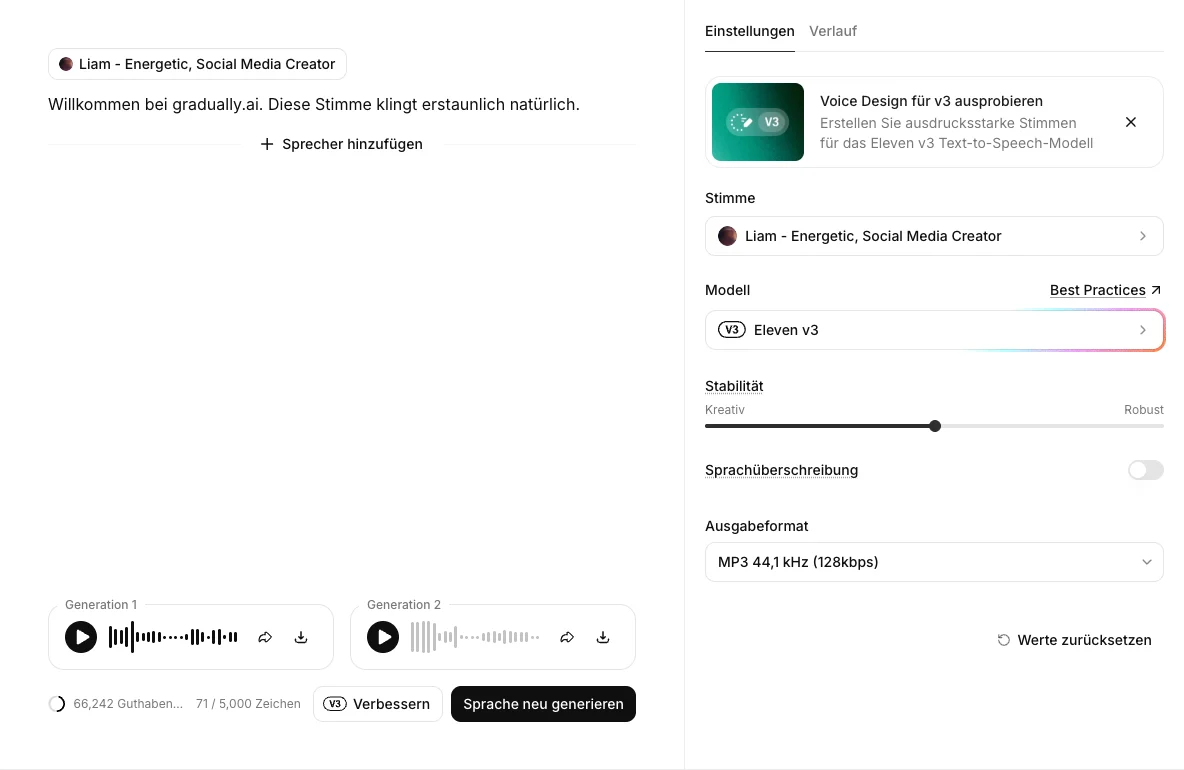
Der Kern von ElevenLabs ist inzwischen das Sprachmodell Eleven v3. Es deckt über 70 Sprachen ab, Deutsch inklusive, standardmäßig erzeugt es dabei MP3-Dateien mit 44,1 kHz und 128 kbps, WAV und andere Formate kannst du dir wählen. Pro Generierung erlaubt dir v3 bis zu 5.000 Zeichen. In meinem ersten Vergleich lieferte der Editor zwei Varianten.
Als Stimme habe ich „Liam, Energetic, Social Media Creator“ genutzt, frei wählbar aus der Bibliothek, dazu gibt es einen Stabilitäts-Slider zwischen Kreativ und Robust.
Zuerst habe ich mein festes Testskript aus Sektion 2 ohne jeden Schnickschnack generieren lassen, also reinen Text ohne eine einzige Steueranweisung.
Audio-Beispiel: das feste Testskript mit Eleven v3 und der Stimme Liam, ohne Audio-Tags
Zur Kontrolle rechne ich dir den Credit-Verbrauch vor, weil vage Angaben mich selbst immer nerven. Ich habe drei Generierungen mitgezählt. Mein Testskript hat 184 Zeichen, danach war mein Guthaben exakt um 184 Credits geringer. Ein zweiter Durchlauf mit 148 Zeichen kostete genau 148 Credits, ein dritter mit 182 Zeichen genau 182. Bei Eleven v3 kostet dich ein Zeichen also ziemlich genau einen Credit, ohne Rabatt und ohne Aufschlag. Die komplette Messreihe über alle Funktionen findest du weiter unten in Sektion 15.
Jetzt zu dem Teil, der mich wirklich beeindruckt hat.
Audio-Tags sind kleine Markierungen, die du direkt in deinen Text schreibst, und die Stimme setzt sie um. Mit [flüstert] flüstert sie, mit [lacht] lacht sie. Der Editor erkennt beide Tags sogar farbig markiert im Text, du siehst also schon vor der Generierung, was er als Anweisung verstanden hat. Weil mein festes Testskript bewusst ohne Tags auskommt, habe ich dafür einen zweiten, kurzen Text genommen:
„[flüstert] Ich verrate dir ein Geheimnis. [lacht] Keine Sorge, nichts Schlimmes. Diese Stimme wurde komplett von einer KI erzeugt.“
Audio-Beispiel: der zweite Text mit den Audio-Tags [flüstert] und [lacht], hör dir den Emotions-Unterschied an
Der Unterschied ist beim Anhören sofort da. Das erste Beispiel liest vor, das zweite spielt. Genau das bietet so kein anderes Text-to-Speech-Tool, das ich kenne.
4.1 Englische Stimme gegen deutsche Stimme, gleicher deutscher Text
Eleven v3 kann über 70 Sprachen. Diese Zahl sagt dir allerdings nichts darüber, wie muttersprachlich eine einzelne Stimme klingt, und genau daran scheitern viele deutsche Projekte. Liam ist eine englische Stimme, die Deutsch spricht, Otto ist eine deutsche Studio-Stimme. Beide bekommen hier dasselbe Skript und dasselbe Modell.
Englische Stimme Liam mit Eleven v3, festes Testskript (11,8 Sekunden)
Deutsche Stimme Otto mit Eleven v3, identisches Skript (11,2 Sekunden)
Beim ersten Hören klingen beide gut, und das ist die Falle. Der Unterschied sitzt in der Aussprache einzelner Wörter. Am deutlichsten hörst du ihn bei „vorliest“, das Liam so verschleift, dass es fast wie „vollließt“ klingt. Otto spricht dieselbe Stelle sauber aus. Dazu kommt das Tempo, denn Liam braucht für den identischen Text 11,8 Sekunden, Otto nur 11,2.
Für deutschsprachige Inhalte würde ich deshalb immer eine deutsche Stimme nehmen, auch wenn eine englische Stimme im Test „irgendwie geht“. Der Aufwand ist derselbe, die Credits sind dieselben, und der Unterschied fällt genau den Hörern auf, für die du produzierst.
4.2 Eleven v3 gegen Eleven Multilingual v2
„Die natürlichste KI-Stimme, die ich bisher gehört habe“ ist eine wertlose Behauptung, solange du nur eine einzige Aufnahme zu hören bekommst. Also habe ich Otto mein Testskript ein zweites Mal vorlesen lassen, diesmal mit dem älteren Modell Eleven Multilingual v2. Gleiche Stimme, gleiche 184 Zeichen, nur ein anderes Modell darunter.
Otto mit Eleven v3, festes Testskript (11,2 Sekunden)
Otto mit Eleven Multilingual v2, identisches Skript (11,5 Sekunden)
Mein Eindruck ist ernüchternder, als die Versionsnummern vermuten lassen. Beide Modelle sprechen den Satz sauber und ohne Aussetzer, v3 ist dabei einen Tick flotter unterwegs (11,2 gegen 11,5 Sekunden). Der wirkliche Unterschied liegt nicht im Klang eines schlichten Satzes, sondern in dem, was du steuern kannst.
- Eleven v3: über 70 Sprachen, Audio-Tags und in meinem Test zwei Varianten, dafür nur ein einziger Regler für die Stabilität.
- Eleven Multilingual v2: 29 Sprachen, von ElevenLabs selbst als „Studioqualität“ ausgewiesen, nur eine Generierung pro Durchlauf, dafür feinere Regler für Geschwindigkeit, Stabilität, Ähnlichkeit, Stilübertreibung und Sprecherverstärkung.
- Flash v2.5: 32 Sprachen, auf ultraniedrige Latenz getrimmt und für Gespräche in Echtzeit gedacht, nicht für produzierte Aufnahmen.
Ein Detail aus dem Editor spricht übrigens dagegen, v2 einfach als „das alte Modell“ abzuhaken.
Für die beste Konsistenz mit professionellen Stimmklonen empfiehlt ElevenLabs nämlich ausdrücklich Multilingual v2 statt v3. Passend dazu laufen auch der Voice Changer und Studio auf v2. Wer also regelmäßig mit einem geklonten Sprecher produziert, fährt mit dem vermeintlich älteren Modell unter Umständen besser.
Bezahlt habe ich für beide Generierungen exakt dasselbe, nämlich 184 Credits für 184 Zeichen. Im Text-zu-Sprache-Editor ist v2 also kein Spartarif, die Wahl zwischen den Modellen ist eine reine Qualitäts- und Steuerungsfrage.
5. Voice Cloning: Instant gegen Professional
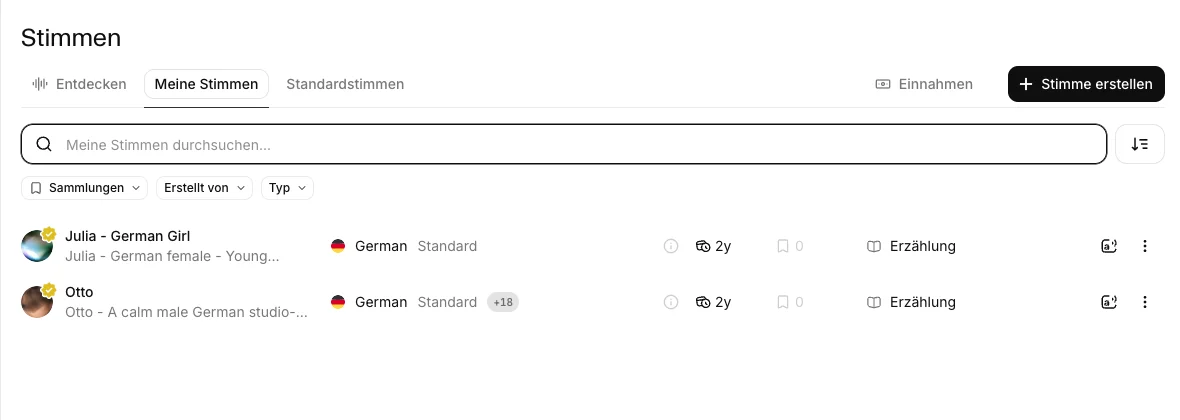
Beim Voice Cloning hat sich einiges getan, seit ich das letzte Mal genauer hingeschaut habe. Unter „Stimme erstellen“ bietet ElevenLabs inzwischen vier Wege an, nämlich Stimmendesign (du beschreibst eine Stimme in Text und bekommst sie in unter einer Minute), die sofortige Stimmenklonung, den professionellen Stimmenklon und Stimmen-Remixing.
Stimmendesign und Stimmen-Remixing habe ich inzwischen ebenfalls praktisch ausprobiert. Für den Design-Test habe ich eine ältere deutsche Erzählerstimme mit warmem Bariton, genauer Hochdeutsch-Aussprache und ruhigem Vortrag beschrieben. Wichtig war die ausdrückliche Anweisung, keine konkrete reale Person zu imitieren. ElevenLabs lieferte drei Varianten, eine davon habe ich als „Historischer Erzähler (synthetisch)“ gespeichert und anschließend mit Eleven v3 vertont.
Hörprobe der frei entworfenen, rein synthetischen Erzählerstimme
Der Text der Hörprobe lautet „Dies ist eine synthetisch entworfene historische Erzählerstimme. Sie imitiert keine reale Person. Stell dir einen alten Vortragssaal vor, in dem jedes Wort mit Ruhe, Gewicht und einem Hauch vergangener Zeit gesprochen wird.“
Danach habe ich genau diese synthetische Stimme im Remix etwas jünger, heller und gesprächiger machen lassen. Auch hier kamen drei getrennte Vorschauen zurück. Für historische Anmutung ist das der saubere Weg. Eine Aufnahme aus einem öffentlichen Archiv mag zwar frei zugänglich sein, daraus folgt aber nicht automatisch das Recht, die unverwechselbare Stimme eines echten Verstorbenen zu klonen.
Der Unterschied zwischen Instant und Professional ist der, der für die meisten Leser zählt.
Beim Instant Voice Clone (IVC) akzeptiert die Oberfläche bereits sehr kurze Aufnahmen. Für ein belastbareres Ergebnis empfiehlt ElevenLabs allerdings 1 bis 2 Minuten sauberes Audio. Der Klon ist fast sofort verfügbar und ab dem Starter-Tarif enthalten. Für den Professional Voice Clone (PVC) brauchst du mindestens 30 Minuten sauberes Audiomaterial, für bessere Ergebnisse empfiehlt ElevenLabs mindestens 1 Stunde und möglichst 2 bis 3 Stunden. Das anschließende Fine-Tuning dauert laut Dokumentation meist 3 bis 6 Stunden und kann bei längerer Warteschlange bis zu 24 Stunden beanspruchen. Den PVC gibt es erst ab dem Creator-Tarif für 22 $, und dort steht ein reservierter Slot zur Verfügung.
Auf dem freien Tarif gibt es übrigens gar kein Voice Cloning, weder Instant noch Professional. Mein Creator-Konto zeigte damals 0 von 30 belegten Stimmen-Slots, das ist die Gesamtkapazität für eigene und geklonte Stimmen in diesem Tarif, unabhängig von dem einen dedizierten PVC-Slot.
Diesmal habe ich den Instant Voice Clone nicht nur beschrieben, sondern live gebaut. Als Ausgangsmaterial dienten zwei synthetische Sprach-Samples der ElevenLabs-Stimme Liam von zusammen rund 22 Sekunden, nicht meine eigene Stimme. Beim Upload war die Option „Hintergrundgeräusche entfernen“ von Haus aus aktiv. Nach rund zwei Minuten Verarbeitung war dieser Testklon im Konto verfügbar.
Einen Schritt hat ElevenLabs mir dabei nicht durchgehen lassen:
Bevor ich den Instant-Klon speichern konnte, musste ich per Checkbox ausdrücklich bestätigen, dass ich alle nötigen Rechte und Zustimmungen habe, um diese Sprachproben hochzuladen und zu klonen, samt Verweis auf Nutzungsbedingungen, verbotene Inhalte und Datenschutz. Beim Professional Voice Clone ist ElevenLabs strenger: Dort ist nur die eigene Stimme erlaubt, die du zusätzlich persönlich verifizieren musst.
Und jetzt der eigentliche Test:
Wie nah kommt so ein Zwei-Minuten-Klon ans Original heran? Auch hier hilft das feste Testskript, denn beide Aufnahmen sprechen exakt dieselben 184 Zeichen. Oben hörst du die Original-Stimme Liam, direkt darunter meinen frisch erstellten Instant-Klon.
Original: die ElevenLabs-Stimme Liam mit dem festen Testskript
Instant Voice Clone: aus meinen hochgeladenen Samples erstellt, identisches Skript
Mein Urteil: Für zwei Minuten Aufwand und rund 22 Sekunden Ausgangsmaterial ist die Ähnlichkeit erstaunlich. Der Klon trifft Klangfarbe und Sprechcharakter, und für schnelle Projekte würde ich ihn ohne Zögern einsetzen. Perfekt deckungsgleich mit dem Original ist er nicht, und genau diese letzte Lücke ist der Grund, warum es den Professional Voice Clone mit seinen 30 Minuten Material überhaupt gibt.
Für meinen eigenen Professional Voice Clone habe ich außerdem 34:14 Minuten aus einer Zoom-Coaching-Aufnahme lokal vorbereitet. Ich habe drei zusammenhängende Finn-Passagen ausgewählt, Beiträge anderer Teilnehmender ausgespart und daraus eine 48-kHz-Mono-Datei mit 192 kbit/s erstellt. Hochgeladen ist sie noch nicht. Vor dem Upload braucht es eine letzte Hörkontrolle, und die anschließende Live-Verifikation muss ich selbst einsprechen.
Das ist ein wichtiger Unterschied zu den Audiodateien, die du aus ElevenLabs herunterladen kannst. Den eigentlichen PVC-Stimmklon exportierst du nicht als Datei. Wenn du später kündigst oder unter Creator herunterstufst, bleibt der Klon laut offizieller PVC-Dokumentation erhalten, ist aber erst nach einem erneuten Upgrade wieder nutzbar.
6. Voice Changer: eine Aufnahme mit einer anderen Stimme sprechen lassen
Der Voice Changer macht etwas anderes als das Klonen: Er nimmt eine fertige Aufnahme und legt sie auf eine andere Stimme, ohne den Inhalt neu zu generieren. Speech-to-Speech nennt ElevenLabs das.
Ein Detail, das viele übersehen:
Der Voice Changer läuft nicht auf dem Flaggschiff Eleven v3, sondern noch auf dem älteren Modell Eleven Multilingual v2. Das steht direkt in der Oberfläche. Du lädst Audio bis 50 MB hoch oder nimmst direkt auf, und stellst über Regler Stabilität, Ähnlichkeit, Stilübertreibung, Hintergrundgeräusche und Sprecherverstärkung ein.
Für den Test habe ich mein fertiges TTS-Sample mit der Stimme Liam genommen, also die schlichte Aufnahme von weiter oben, und sie in die Stimme „Julia“ (German Girl) umgewandelt. Der Text bleibt Wort für Wort gleich, nur die Stimme wechselt.
Audio-Beispiel: mein Liam-TTS-Sample, per Voice Changer in die Stimme Julia umgewandelt (Eleven Multilingual v2)
Gekostet hat mich das 197 Credits für 12 Sekunden Audio, also rund 985 Credits pro Minute. Pro Sekunde deutlich teurer als reines Text-to-Speech, aber für das, was da passiert, nachvollziehbar. Praktisch ist der Voice Changer immer dann, wenn du eine Aufnahme schon hast, dein eigenes Sprechen, ein Interview oder einen fertigen Take, und nur die Stimme darüber tauschen willst, statt alles neu einzusprechen oder neu zu generieren.
7. Scribe: Sprache zu Text in 92 Sprachen
ElevenLabs kann nicht nur Stimme aus Text machen, sondern auch umgekehrt. Dafür gibt es Scribe v2 für hochgeladene Dateien und Scribe v2 Realtime für laufende Audioströme. Hier habe ich den Datei-Upload getestet, nicht die Echtzeit-Variante.
Im Live-Banner bewirbt ElevenLabs Scribe selbst als „blitzschnelle Transkription mit unvergleichlicher Genauigkeit in 92 Sprachen“ und nennt es das „branchenführende ASR-Modell“. Große Worte, die Sprachenzahl kann ich dir aber bestätigen: 92 Sprachen stehen tatsächlich zur Auswahl.
Diesmal habe ich Scribe aber auch selbst gemessen, und zwar mit einem Fall, bei dem ich die Wahrheit vorher kenne.
Ich habe mein eigenes TTS-Sample von oben transkribieren lassen. Der Originaltext steht Wort für Wort fest, 28 Wörter, jede Abweichung lässt sich also eindeutig zuordnen. Die Sprache hat Scribe von allein korrekt als Deutsch erkannt.
Hallo, ich bin Finn. Grade(Gerade) teste ich, wie natürlich diese KI-Stimme deutschen Text vorliest. 8(Achte) einmal auf die Betonung, das Sprechtempo und die kleinen Pausen zwischen den Sätzen.Zwei Abweichungen bei 28 Wörtern, macht in diesem einfachen Wortvergleich rund 93 % Übereinstimmung. Aus „Gerade“ wird „Grade“, aus „Achte“ die Ziffer „8“. Das ist ein kleiner Kontrolltest mit bekanntem Text, keine standardisierte Word-Error-Rate-Messung für natürliche Gespräche.
Der Härtetest steht deshalb woanders. Ich habe ElevenLabs bereits in meinem ausführlichen Vergleich von KI-Transkriptionssoftwares gegen fünf andere Tools antreten lassen, aufgenommen mit dem eingebauten Mikrofon eines alten MacBooks und bewusst suboptimalen Bedingungen. Dort kam ElevenLabs auf 98,11 % Zeichen- und 90,26 % Wortgenauigkeit und landete damit auf Platz 1 von sechs Tools.
Für meinen Clip von zwölf Sekunden hat der Batch-Upload über zwei Minuten gebraucht. Dieser einzelne Durchlauf sagt nichts über die Latenz von Scribe v2 Realtime aus. Den Streaming-Pfad habe ich nicht gemessen. Wenn du größere Dateistapel verarbeiten willst, prüfe die Wartezeit deshalb mit deinem eigenen Material.
Für ein echtes Interview würde ich Scribe dennoch nicht blind auf Basis dieser 28 Wörter buchen. ElevenLabs dokumentiert zusätzlich Keyterm-Prompts für Fachbegriffe, Sprechertrennung und Zeitstempel. Der Modus No Verbatim kann Füllwörter und Wiederholungen glätten, liefert dann aber bewusst kein wortgetreues Transkript. Untertitel kannst du als SRT oder VTT exportieren.
Genau diese Funktionen habe ich hier noch nicht praktisch geprüft. Wer damit Gespräche mit mehreren Personen verarbeitet, sollte Eigennamen und Fachwörter vorher hinterlegen und ein fertiges Transkript immer gegenhören. Die Funktionsübersicht steht in der Scribe-Dokumentation und in der Anleitung für Untertitel.
Für mich praktisch ist vor allem, dass ich für Transkription kein zusätzliches Tool brauche, sondern im selben Konto bleibe. Wer sehr viel transkribiert, sollte sich trotzdem spezialisierte Anbieter wie Sonix oder Amberscript anschauen, die genau auf diese Aufgabe ausgelegt sind.
8. Music v2: der Musikgenerator
Seit Ende Mai 2026 gibt es mit Music v2 auch einen Musikgenerator, aktuell das zweite Modell nach einer ersten Version, die noch in meiner Generierungs-Historie sichtbar ist.
Auch hier rechne ich dir den Credit-Verbrauch vor. Music v2 kostet 900 Credits pro Minute und Variante. In meinem ersten Test mit Länge „Automatisch“ entstanden zwei Varianten mit 2:00 und 2:30 Minuten. Gemessen am Guthaben vorher und nachher hat mich diese eine Generierung 4.115 Credits gekostet. Später konnte ich bei einem 30-Sekunden-Song auch nur eine Variante wählen. Stelle die Variantenanzahl und Länge deshalb bewusst ein, statt dich auf eine vermeintliche Standardmenge zu verlassen.
Bei den Songtexten hast du die Wahl zwischen „Automatisch“ (Auto-Lyrics) und eigenem Text. Das Genre erkennt ElevenLabs meist automatisch aus deinem Prompt, in meinen Tests etwa hip-hop, electronic und ambient. Zum Download stehen dir MP3, MP4, WAV und ein erweitertes Format zur Verfügung.
Den Gesang habe ich inzwischen mit einem komplett eigenen deutschen Vierzeiler nachgetestet. Ich habe eine 30-sekündige Chamber-Pop-Ballade mit warmem Bariton, Klavier und Streichern erzeugt, eine Variante eingestellt und 450 Credits bezahlt. Music v2 hat daraus den fertigen Song „Stimmen aus Papier“ mit dem eingegebenen Text gebaut. Im Menü lässt sich der Track anschließend entweder in Gesang und Instrumental oder in Gesang, Bass, Schlagzeug, Gitarre, Klavier und Sonstiges aufteilen. Für meinen 30-Sekunden-Track zeigte die Oberfläche 225 beziehungsweise 450 Credits an. Die vollständige Trennung habe ich gestartet, die einzelnen Dateien konnte ich in meiner Browser-Automation aber nicht unabhängig herunterladen und anhören.
Hörprobe „Stimmen aus Papier“, 30 Sekunden aus meinem Gesangstest mit eigenem Text
Für diesen Test habe ich folgenden Liedtext eingegeben. „Leise fällt das Licht ins alte Haus. Jede Seite trägt die Zeit hinaus. Stimmen aus Papier, wir hören zu. Zwischen Staub und Sternen wächst die Ruh.“
Audio-Beispiel: 30 Sekunden aus einem Lo-Fi-Track, den ich mit Music v2 erzeugt habe
Besonders spannend fand ich den Song-Editor. Dort arbeitest du mit einer Timeline aus Sektionen, Intro, Verse, Bridge und Outro. Jede Sektion hat eigene Stil-Tags und ein eigenes Tempo, in meinem Test zum Beispiel „relaxed lo-fi hip-hop groove“, „dusty snare“ und 82 BPM. Genau hier steckt das Inpainting, du kannst eine einzelne Sektion neu generieren lassen, ohne den Rest des Songs anzufassen, oder ihr über neue Stil-Tags ein anderes Genre verpassen.
Wie weit so ein Genre-Wechsel wirklich trägt, habe ich separat nachgemessen.
Er greift zuverlässig auf Tag-Ebene, die ausgewählte Sektion bekommt also tatsächlich neue Stil- und Tempo-Angaben, während die Nachbar-Sektionen unverändert bleiben. Klanglich blieb der Wechsel aber deutlich näher am Original, als die neuen Tags versprechen. Die Messwerte dazu stehen in meinem Music-Guide, den ich gleich unten verlinke.
Eine solche Nachgenerierung kostet wieder 900 Credits pro Minute und Variante, du setzt sie also gezielt ein und nicht wahllos. Die Oberfläche und den kompletten Workflow habe ich mir genau angeschaut, und für ein noch junges Musik-Feature wirkt das erstaunlich ausgereift.
Wie Inpainting, Genre-Wechsel und der Song-Editor im Detail funktionieren und was Music v2 im Vergleich zu Suno kann, habe ich in einem eigenen Guide zu ElevenLabs Music ausführlich aufgeschrieben.
9. Dubbing v2: automatische Video-Übersetzung
Für Video-Übersetzung und Synchronisation hat ElevenLabs ein eigenes Werkzeug, aktuell mit dem Zusatz „Dubbing v2 (Alpha)“ gekennzeichnet.
Im Intro-Modal wirbt ElevenLabs mit drei Versprechen für Dubbing v2:
- Die Emotion und der Ausdruck des ursprünglichen Sprechers bleiben erhalten.
- Die Formulierung wird angepasst, damit die Übersetzung in 92 Sprachen natürlich klingt.
- Stimmenklonen und Synchronisation laufen automatisch ab.
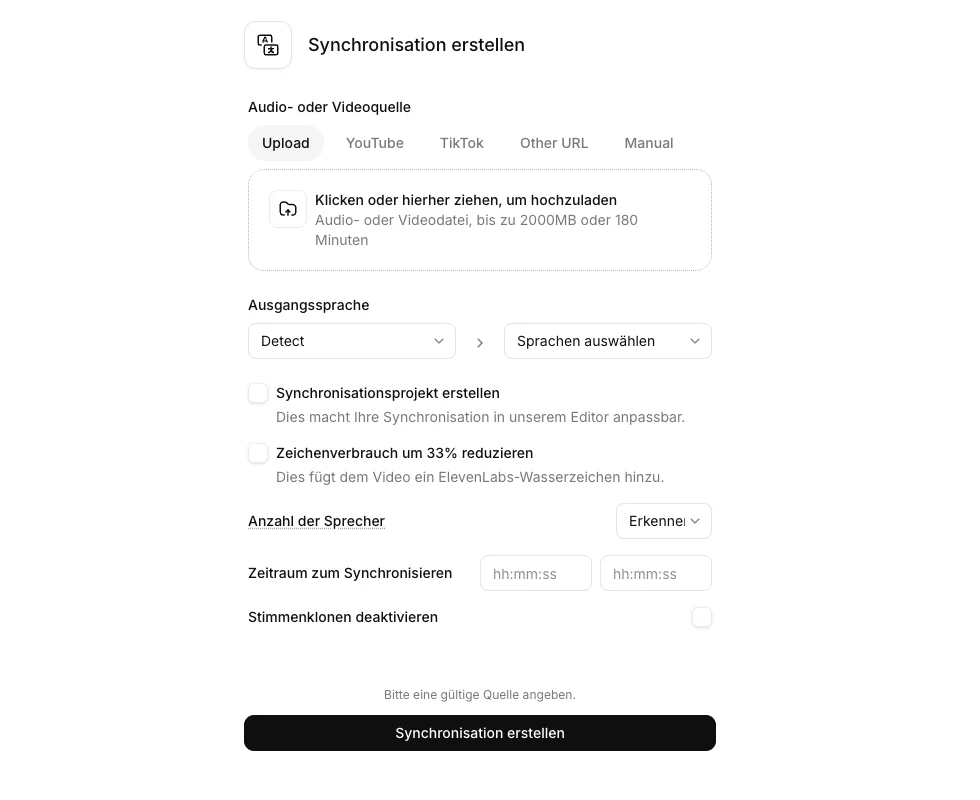
Auf dem Upload-Screen lädst du eine Datei hoch oder fügst direkt eine URL ein. Laut aktueller Dubbing-Dokumentation gelten für v2 im Browser gleichzeitig die Grenzen von 2 GB und 180 Minuten. Danach wählst du die Zielsprachen aus, unter „Erweitert“ gibt es zusätzliche Einstellungen.
Dubbing v2 arbeitet vollständig automatisch und liefert eine verlustfreie Audiodatei, aber keinen Lip-Sync und keinen Editor für die Übersetzung. Für nachträgliche Textänderungen brauchst du ein Dubbing-Studio-Projekt mit dem älteren v1-Modell. Diese Produktgrenze und die vorgesehenen Exporte erkläre ich in der Anleitung zu KI-Dubbing. Einen solchen vollständigen Ablauf habe ich hier nicht geprüft.
Und genau hier endet mein Test. Unter den neun benoteten Kernwerkzeugen ist Dubbing v2 das einzige ohne Ausgabe. Nicht abgeschlossene Schritte aus den späteren Zusatztests führe ich in Sektion 12.1 separat auf.
Beim ersten Anlauf habe ich es über den Datei-Upload versucht, mit exakt der Audiodatei, die ich vorher schon durch den Voice Changer und durch Scribe geschickt hatte. Beide hatten sie anstandslos angenommen. In Dubbing v2 blieb die erkannte Dauer dauerhaft auf „--“ stehen, der Spinner drehte sich endlos, und die Generierung ließ sich nicht starten.
Beim zweiten Anlauf, ein paar Tage später, habe ich den URL-Weg genommen und eine Sample-URL von gradually.ai eingefügt. Auch das ging schief, diesmal mit der Meldung „Medien von dieser URL konnten nicht geladen werden“. Diesen zweiten Fehlschlag rechne ich ElevenLabs nur zur Hälfte an, weil vermutlich der Bot-Schutz meiner eigenen Seite den Abruf blockiert hat.
Für einen dritten, unabhängigen Versuch habe ich deshalb ein offizielles NASA-Video auf YouTube als Quelle verwendet und Englisch als Zielsprache ausgewählt. Auch diese URL konnte Dubbing v2 nicht laden. Damit lässt sich der Fehler nicht mehr nur mit meiner eigenen Website erklären. Ein fertiger Dub entstand in keinem der drei Versuche.
Dieselbe Datei lieferte im selben Konto mit Voice Changer und Scribe Ergebnisse, in Dubbing v2 dagegen nicht. Die beiden URL-Versuche zeigen, dass mein Problem nicht auf diesen einen Upload beschränkt war. Ob die Ursache beim jeweiligen Input, beim Dienst oder bei meiner Testumgebung lag, bleibt offen.
In meinem Konto liegt aus einem früheren Test noch eine Dubbing-Hörprobe, ein Auszug aus Sebastian Fitzeks „Elternabend“, damals allerdings noch mit dem Vorgängermodell Dubbing v1. Daraus und aus meinen fehlgeschlagenen v2-Versuchen lässt sich kein allgemeines Qualitätsurteil über die aktuelle Version ableiten.
10. ElevenAgents: Sprach-Bots
ElevenLabs bietet mit ElevenAgents außerdem einen Baukasten für KI-Sprach-Agenten, also Bots, die am Telefon oder im Chat sprechen sollen.
ElevenAgents ist ein eigenes, großes Thema. Ich habe mir das Dashboard angeschaut, und schon dort wird klar, wie umfangreich der Baukasten ist: Telefonnummern, WhatsApp, Wissensdatenbank, Tools und die LLM-Konfiguration liegen alle in einer Oberfläche.
Diesmal habe ich es nicht beim Draufschauen belassen, sondern einen Agenten gebaut und getestet.
Zwei Wege gibt es dafür: einen fünfstufigen Assistenten (Vorlage, Branche, Anwendungsfall, Tools, erstellen) oder fertige Schnellstart-Vorlagen wie Customer Support, Language Practice Tutor oder Front Desk Receptionist. Ich bin mit der Vorlage „Customer Support“ gestartet. Die kommt nicht leer, sondern mit einem kompletten System-Prompt (Persönlichkeit „Jamie, ruhiger, kompetenter Support-Techniker“, dazu Umgebung und Tonfall) und einer ganzen Tool-Ebene: eigene Tools wie Zendesk oder Salesforce per API-Key und System-Tools wie Gespräch beenden, Sprache erkennen, an einen menschlichen Agenten weiterleiten oder Status aktualisieren.
Ein Detail, das mir als Entwickler gefallen hat:
Beim Veröffentlichen zeigt ElevenAgents einen Diff-Review-Dialog, veröffentlichte gegen aktuelle Version, fast wie bei Git, samt Commit-Nachricht. Versionskontrolle für Sprach-Agenten, sauber gelöst.
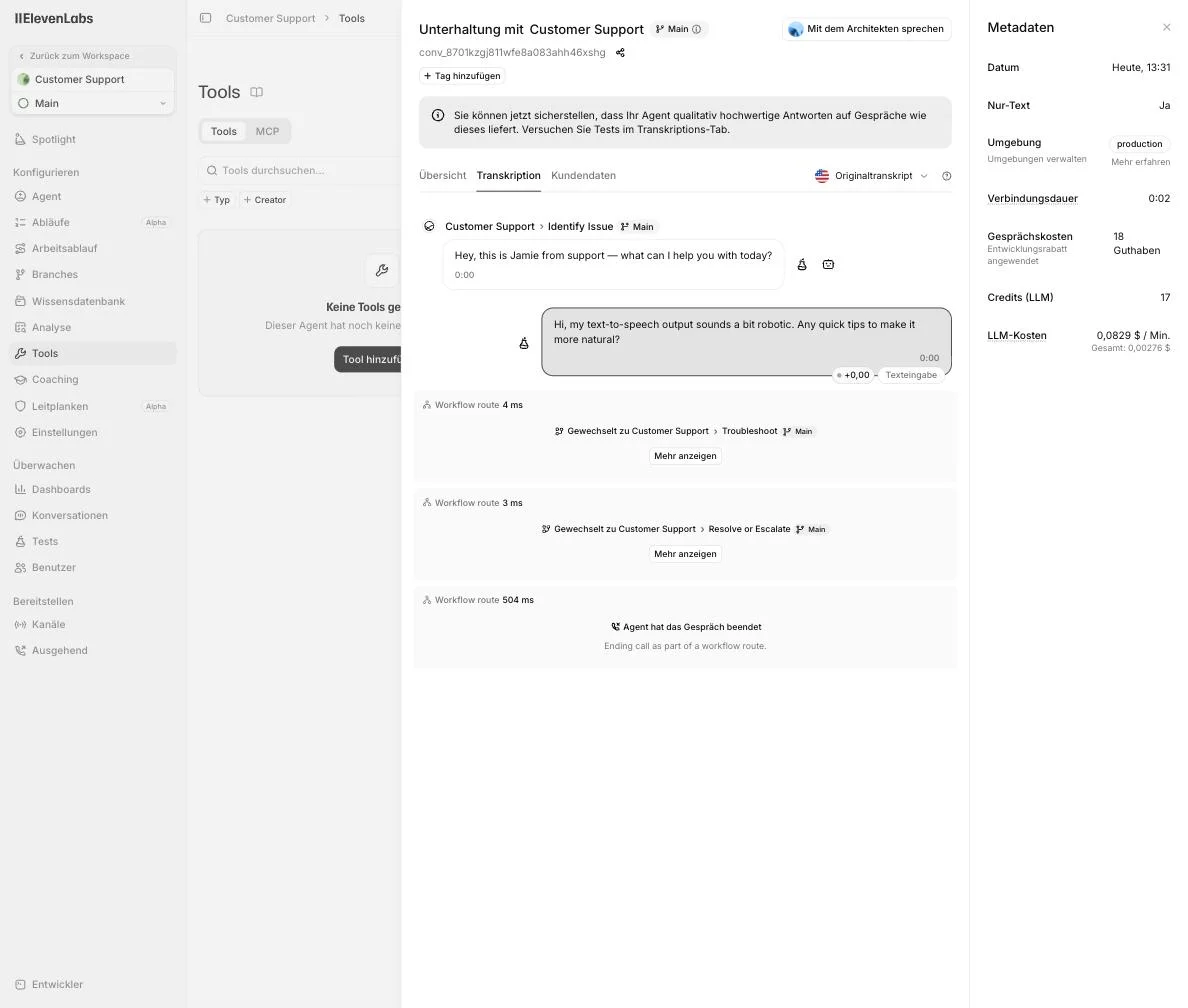
Dann das eigentliche Testgespräch. Über das Text-Widget hat der Agent mich begrüßt („Hey, this is Jamie from support, what can I help you with today?“), meine Frage entgegengenommen und einen mehrstufigen Workflow durchlaufen: Identify Issue, dann Troubleshoot, dann Resolve or Escalate. Die „Customer Support“-Vorlage ist also kein simpler Prompt-Agent, sondern ein Workflow-Agent mit echten Verzweigungen.
Und ja, einen Haken muss ich benennen:
Im reinen Text-Testmodus hat der Workflow am Ende die letzte Textantwort abgeschnitten, weil er als Teil einer Workflow-Route auf „Gespräch beenden“ gesprungen ist. Dieser Agent ist klar für Sprache gebaut, nicht für den Chat, und die automatische Gesprächszusammenfassung von ElevenLabs hat genau das selbst benannt.
Was mich dann doch beeindruckt hat, war die Auswertung danach. Für jedes Gespräch gibt es eine eigene Detailseite mit KI-generierter Zusammenfassung, Gesprächsstatus (bei mir „Erfolgreich“), einer Sentiment-Analyse (neutral, keine Frustration) und dem kompletten Wort-Transkript mit Zeitstempeln und den durchlaufenen Workflow-Routen.
Die Kostenanzeige wies für mein Gespräch mit Entwicklerrabatt 18 Credits aus, davon 17 fürs Sprachmodell, sowie einen LLM-Satz von 0,0829 $ pro Minute. Auf zwei Sekunden umgerechnet sind das etwa 0,00276 $ für diesen LLM-Anteil. Das sind nicht die gesamten Gesprächskosten und kein allgemeiner Tarif für andere Agenten oder Kanäle.
Einen Punkt solltest du kennen, bevor du an einen Telefon-Bot denkst:
ElevenLabs verkauft keine eigenen Telefonnummern. Importieren kannst du eine Nummer nur von Twilio, von einem SIP-Trunk oder von Exotel, jeweils mit externem Konto und Zugangsdaten. ElevenAgents ist also die Stimm- und Logikschicht, die eigentliche Telefonie bringst du von einem anderen Anbieter mit. Als weitere Kanäle kommen noch WhatsApp und ausgehende Anrufe im Batch dazu.
Für einen ersten echten Test hat mich ElevenAgents überzeugt: Die Vorlagen nehmen dir viel Arbeit ab, die Auswertung ist erstklassig, und die Workflow-Logik ist mehr als ein simpler Chat-Prompt. Wer damit ernst machen will, sollte den Agenten aber im Sprachbetrieb testen, nicht im Chat, und die Telefonie-Anbindung von Anfang an mitdenken.
11. Studio: Langform für Hörbücher und lange Texte
Studio ist die Langform-Umgebung für Projekte wie Hörbücher. Du legst ein Audio-Projekt an, arbeitest in Kapiteln und Absätzen und weist jedem Absatz eine eigene Stimme zu. Ich habe einen Testabsatz mit der deutschen Studio-Stimme „Otto“ vertont, das läuft dort auf Eleven Multilingual v2 und kostete rund einen Credit pro Zeichen, für meinen kurzen Absatz also 281 Credits. Pro Absatz gibt es eigene KI-Werkzeuge wie Text verbessern, Voice Changer oder Hintergrundgeräusche entfernen. Reine Hörbücher haben inzwischen sogar einen eigenen Bereich außerhalb von Studio bekommen.
Mein kurzer Absatz belegt aber weder ein ganzes Hörbuch noch die Zuverlässigkeit über mehrere Kapitel. Der eigene Audiobooks-Bereich kann EPUB- und PDF-Manuskripte in Kapitel übernehmen, Sprecher erkennen und unterschiedlichen Figuren Stimmen zuweisen. Für Romane mit Dialogen sind außerdem Aussprache-Wörterbücher, Änderungen pro Absatz und Kapitel-Exporte vorgesehen. Das ist ein sinnvoller Workflow für Autoren und Verlage, aber keine Qualität, die ich mit meinem 280-Zeichen-Test schon behaupten kann.
Zum Studio-Umfeld gehören außerdem GenFM, das aus einem Quelldokument ein neues Podcast-Skript entwickelt, Actor Mode zum Ausrichten von Prosodie und Emotion an einer Referenzaufnahme, Video-to-Music, Untertitel und ein Studio Agent für Videoprojekte. GenFM ist damit keine wortgetreue Vorlesefunktion, sondern ein eigener Podcast-Workflow. Auch diese Werkzeuge listet ElevenLabs offiziell, ich habe sie in diesem Test aber nicht selbst durchgespielt. Wenn du einen Podcast oder ein Hörbuch planst, würde ich nicht mit einem kompletten Buch starten, sondern mit zwei kurzen Kapiteln, zwei Stimmen und Eigennamen, bei denen eine falsche Aussprache sofort auffällt.
Für bestehende Blogartikel ist Audio Native interessanter als ein weiteres Studio-Projekt. Es bettet einen Vorlese-Player direkt in eine Website ein und ist laut ElevenLabs im Creator-Tarif verfügbar. Das habe ich noch nicht auf gradually.ai eingebaut. Die Funktion ist deshalb eine dokumentierte Option, keine von mir gemessene Leseerfahrung.
12. Soundeffekte
Auch die Soundeffekte habe ich kurz ausprobiert. Aus einem englischen Prompt wie „sanfter Regen am Fenster mit fernem Donner“ erzeugt ElevenLabs vier kurze Varianten auf einmal, die du danach über Vorschläge wie „Regenstärke“ oder „Donner-Detail“ weiter verfeinerst.
Die vier Clips waren in meinem Test jeweils rund eine Sekunde lang, für eine Hörprobe in diesem Artikel also zu kurz. Die rund 17 Credits sind eine historische Schätzung aus der damaligen Oberfläche, nicht am Guthaben gemessen und keine aktuelle Preisempfehlung. ElevenLabs nennt auf seiner Preisseite derzeit 200 Credits pro Soundeffekt-Generierung. Das ist kein Urteil über längere Geräusche oder nahtlose Loops. Laut offizieller Anleitung sind Effekte bis 30 Sekunden vorgesehen. Dafür fehlt mir noch ein belastbarer Hörtest.
12.1 Weitere Werkzeuge im Überblick
Die folgenden Zusatztests stammen vom 29. August 2026 und ändern die gewichtete Gesamtnote aus Sektion 3 nicht rückwirkend. Weitere Funktionen ordne ich anhand der Dokumentation ein und kennzeichne sie als noch nicht praktisch getestet.
Voice Design und Voice Remixing haben im Zusatztest genau das getan, was sie sollen. Aus einer frei beschriebenen, synthetischen Erzählerstimme entstanden drei Varianten. Eine davon ließ sich anschließend in drei weiteren Vorschauen jünger, heller und gesprächiger remixen. Gerade für eine historische Anmutung ist das die bessere Idee als der Klon einer realen Person.
Im Bereich Bild & Video habe ich mit GPT Image 2 einen leeren Vortragssaal erzeugt und mit Veo 3.1 Fast eine viersekündige Kamerafahrt daraus gemacht. Bei Flows konnte ich eine deutsche Erzählung und Bibliotheksatmosphäre erzeugen. Der Kompositionsknoten renderte ohne Videospur jedoch nicht. Das ist ein offener Workflow-Schritt, kein Beweis dafür, dass das Produkt grundsätzlich nicht funktioniert.
Synthetisch erzeugtes Standbild und viersekündige Kamerafahrt durch einen leeren historischen Vortragssaal bei Kerzenlicht. Das Video hat keinen Ton.
Den Stimmenisolator konnte ich nicht abschließend prüfen. Die Testdatei mit Sprache und zugemischter Musik liegt lokal bereit, der Datei-Upload war in meiner Browser-Automation aber gesperrt. Beim Mehrsprecher-Modus von Text-to-Speech konnte ich eine zweite Sprecherzeile und Stimme anlegen, das zweite Editorfeld aber nicht befüllen. Das sind Grenzen meiner Testautomatisierung, nicht automatisch Grenzen der Funktionen.
Bei den Echtzeit-Werkzeugen gilt derselbe Grundsatz. Die Weboberfläche für Scribe Realtime, Live-Voice-Changer und den Sprachmodus von ElevenAgents verlangt Mikrofonzugriff. Über die API lassen sich Echtzeit-Audioströme jedoch auch anders anbinden. Die API-Abrechnung und Konfiguration sind nicht automatisch mit einem Klick in der Creator-Oberfläche gleichzusetzen. Ich habe weder Latenz noch Unterbrechungen oder Sprachqualität dieses Pfads selbst getestet und mache daraus deshalb keine Leistungszusage.
Für Entwickler ist das API-Feature „Forced Alignment“ interessant, wenn ein gesprochenes Audio etwa für Karaoke-Untertitel oder ein geschnittenes Video auf einen Text gelegt werden soll. Das ist nicht mit einer allgemeinen Transkriptionsbewertung zu verwechseln. Details nennt die offizielle API-Dokumentation.
Auch Audio Detector und Avatare stehen auf meiner Funktionsliste, aber nicht auf meiner Testliste. Der Detector soll nach Angaben von ElevenLabs eigene generierte Audios erkennen, er ist kein universeller KI-Detektor. Ein negatives Ergebnis beweist also nicht, dass ein Audio menschlich oder original ist. Avatare verbinden ein Bild mit einem gesprochenen Skript und Lippensynchronität, sie sind laut Anbieter in den kostenpflichtigen Tarifen verfügbar. Für beide Funktionen fehlt mir ein Qualitätsvergleich mit echter Veröffentlichungssituation.
Ads Engine nehme ich bewusst nicht als Creator-Lücke auf. ElevenLabs führt die Funktion derzeit als Alpha ab Pro. Für einen Creator-Test wäre sie also weder freigeschaltet noch der sinnvolle nächste Schritt.
13. Die Stärken aus meiner Sicht
Nach diesem Test sind das die Punkte, bei denen ElevenLabs für mich klar vorne liegt:
- Qualität und Natürlichkeit: Das ist der wichtigste Punkt. Eleven v3 klingt in meinem Test näher an einem echten Menschen als alle anderen Stimmen, die ich dort verglichen habe. Gerade bei emotionalen oder erzählenden Texten merkt man den Unterschied deutlich.
- Audio Tags als klarer Vorteil: [flüstert] und [lacht] direkt im Text zu schreiben und im Ergebnis genau das zu hören, habe ich in meinen bisherigen Tests bei keinem anderen Tool so erlebt. Das ist nicht nur ein nettes Extra, sondern der Grund, warum ElevenLabs für anspruchsvolle Sprachprojekte für mich so weit vorne liegt.
- Eine Plattform statt vieler Abos: Text-to-Speech, Scribe, Voice Cloning, Music v2, Dubbing und ElevenAgents in einem Konto. Für mich der unterschätzte Vorteil im Alltag, weil ich nicht zwischen mehreren Tools und mehreren Rechnungen jonglieren muss.
- Nachvollziehbare Credit-Abrechnung: Bei Eleven v3 kostet ein Zeichen fast exakt einen Credit, das habe ich in meinem Test bis auf die Stelle genau nachgerechnet. Keine versteckte Rundung, keine Überraschung auf der Rechnung.
14. Die Schwächen, klar benannt
Kein Tool ist perfekt, und nur zu schwärmen würde dir bei der Entscheidung nicht helfen. Das sind die Punkte, die du kennen solltest:
- Kein Voice Cloning im Free-Tarif: Wer nur mal reinschnuppern will, kann Stimmen zwar benutzen, aber keine eigene klonen. Instant Voice Cloning gibt es erst ab Starter, Professional Voice Cloning erst ab Creator.
- Music v2 auf „Automatisch“ frisst schnell Guthaben: Eine einzige Generierung hat mich 4.115 Credits gekostet, also rund 3,4 % eines Creator-Monatskontingents für einen Anlauf. Wer testet, sollte die Länge manuell begrenzen.
- Der Preis kann bei viel Nutzung steigen: ElevenLabs rechnet über Credits ab. Solange du gelegentlich vertonst, kommst du mit den günstigen Tarifen gut hin. Produzierst du aber täglich lange Texte oder ganze Hörbücher, verbrauchst du schnell viele Credits und landest in den höheren Tarifen.
- Dubbing v2 lieferte in meinem Test kein Ergebnis: In drei Anläufen kam kein fertiger Dub heraus. Der Datei-Upload blieb hängen, meine eigene URL scheiterte und selbst ein offizielles NASA-Video auf YouTube ließ sich nicht laden. Die Ursache bleibt offen.
- USD-Abrechnung und Steuern beim Checkout: Die Tarife sind in US-Dollar angegeben. Welche Steuern zusätzlich anfallen, hängt von Rechnungsland und Steuerstatus ab. Verlass dich deshalb nicht auf eine pauschale Umrechnung, sondern prüfe den Checkout.
- Höhere Latenz bei v3 für Echtzeit: Eleven v3 liefert die beste Qualität, braucht dafür aber etwas länger. Für vorproduzierte Inhalte ist das egal, für einen Live-Sprach-Bot ist die Latenz ein Thema, das du einplanen musst.
- Natürlichste Sprachqualität in meinem Test (Eleven v3), gerade bei emotionalen Texten
- Audio Tags wie [flüstert] und [lacht] für echte Emotion direkt im Text
- Komplette Audio-Plattform: TTS, Voice Cloning, Scribe (92 Sprachen), Music v2, Dubbing und ElevenAgents in einem Konto
- Nachvollziehbare Credit-Abrechnung, rund 1 Credit pro Zeichen bei v3
- Kostenloser Tarif zum Ausprobieren, Einstieg ab 6 $ pro Monat
- Kommerzielle Nutzung je nach Dienst, Tarif und geltenden Bedingungen
15. Preise und Tarife
Bevor wir zu den Tarifen kommen, die Zahl, die im Alltag wirklich zählt.
Ich habe bei jeder Generierung das Guthaben vorher und nachher notiert, und so ist diese Tabelle entstanden, gemessen im hochgestuften Scale-Konto. Die Einheiten habe ich bewusst nicht gleichgemacht, weil ElevenLabs je nach Funktion pro Zeichen, pro Minute oder pro Anrufminute abrechnet.
Die beiden Music-Werte stammen aus unterschiedlichen beobachteten Vorgängen. Ein kompletter Auto-Track kostete 4.115 Credits, eine Outro-Neugenerierung 1.350 Credits. Vor jeder Änderung zeigt dir die Oberfläche den für diesen Vorgang geltenden Preis.
Was ElevenLabs offiziell je Funktion und Modell berechnet, steht in meinem Artikel zu den ElevenLabs Preisen. Die Tabelle hier oben zeigt dagegen, was am Ende wirklich vom Guthaben abgezogen wurde.
ElevenLabs hat eine kostenlose Version und mehrere Bezahl-Tarife. Hier die wichtigsten im Überblick, mit den Zahlen aus meinem eigenen Konto und der Abo-Seite.
Zusätzliche Minuten kosten dich außerhalb des Kontingents zwischen 0,36 $ (Free) und 0,17 $ (Pro und Scale) pro Minute, je günstiger der Tarif desto teurer die einzelne Zusatzminute. Bei Creator liegt die Zusatzminute bei 0,18 $, und wenn dir die Credits ausgehen, kannst du dort zusätzliche Credits per Pay-as-you-go nachkaufen.
Die Studio-Projekte unterscheiden sich ebenfalls je Tarif: 20 bei Starter, 1.000 bei Creator, 3.000 bei Pro und 9.000 bei Scale. Für sehr große Teams gibt es außerdem noch einen Business-Tarif. Laut Preisseite kostet er 990 $ im Monat und bringt 6.000.000 Credits mit, also rund 6.000 Freiminuten. Diese Zahlen stammen von der offiziellen Preisseite, nicht aus meinem Konto, weil der Business-Tarif oberhalb meines Creator-Tarifs liegt.
Zahlst du jährlich statt monatlich, bekommst du laut ElevenLabs zwei Monate geschenkt, du zahlst also effektiv nur für 10 statt 12 Monate. Welche Steuern bei dir dazukommen, zeigt ElevenLabs erst beim Checkout. Das hängt vom Rechnungsland und deinem Steuerstatus ab, nicht pauschal von „der EU“.
Viele Funktionen nutzen denselben Credit-Topf, haben aber unterschiedliche Abrechnungssätze. Musik, Dubbing oder längere Studio-Projekte sind deshalb keine kostenlosen Extras. Bezahlte ungenutzte Abo-Credits können laut Preisseite von ElevenLabs unter einem fortlaufenden Bezahl-Abo bis zu zwei Monate übertragen werden. Bei Kündigung oder Downgrade verfällt verbleibendes Abo-Guthaben am Ende des Abrechnungszeitraums.
Eine noch genauere Aufschlüsselung aller sieben Tarife, inklusive des Business-Tarifs und der Hinweise zu Steuern beim Checkout, findest du in meinem separaten Artikel zu den ElevenLabs Preisen.
16. Wann sich ElevenLabs lohnt, und wann nicht
Die Antwort ist ein Es-kommt-darauf-an. Aber ich mag es nicht, dich mit so einer Nicht-Antwort stehen zu lassen, deshalb hier meine klare Einordnung.
16.1 Für wen sich ElevenLabs lohnt
ElevenLabs lohnt sich für dich, wenn du Stimme ernsthaft und regelmäßig nutzt. Konkret heißt das:
- Du produzierst Voice-overs für YouTube-Videos oder Erklärfilme und willst, dass sie professionell klingen, mit echter Betonung statt monotonem Vorlesen.
- Du erstellst Hörbücher oder vertonst längere Texte und brauchst eine Stimme, die Emotion transportiert.
- Du machst einen Podcast und willst Intros, Trailer oder ganze Folgen mit KI-Stimmen produzieren, oder Interviews mit Scribe transkribieren.
- Du willst deine eigene Stimme klonen, um sie immer wieder einzusetzen, ohne jedes Mal ins Mikro zu sprechen.
- Du veröffentlichst mehrsprachig und brauchst saubere Stimmen in vielen Sprachen aus einer Hand.
In all diesen Fällen ist die Kombination aus Qualität, Audio Tags und Plattform-Tiefe den Preis wert.
16.2 Für wen etwas Günstigeres reicht
Verstehe mich nicht falsch:
ElevenLabs ist großartig, aber nicht jeder braucht das. Für dich reicht wahrscheinlich eine schlankere und günstigere Lösung, wenn:
- du nur ab und zu einen Blogartikel zum Anhören vertonen willst.
- dir eine solide, aber nicht perfekte Stimme genügt, weil es um reine Information geht.
- du hauptsächlich transkribierst und kaum Sprache generierst, dann sind spezialisierte Transkriptions-Tools oft die bessere Wahl.
- du ein sehr enges Budget hast und der USD-Preis plus Mehrwertsteuer für dich ins Gewicht fällt.
In diesen Fällen lohnt sich ein Blick auf die ElevenLabs Alternativen. Dort gehe ich auf günstigere und spezialisierte Tools im Detail ein.
17. Mein Fazit
Ich bin als Skeptiker in diesen Test gegangen und als Nutzer wieder herausgekommen.
ElevenLabs hat mich überzeugt, weil es genau das liefert, was ich an KI-Stimmen lange vermisst habe, nämlich Natürlichkeit, Emotion und eine Tiefe, die über reines Vorlesen hinausgeht. Die Audio Tags [flüstert] und [lacht] sind für mich das Feature, das den Unterschied macht, und die Plattform spart mir im Alltag echte Zeit, weil ich nicht mehr zwischen mehreren Tools wechseln muss.
Das günstigste Tool ist es nicht, und für jeden lohnt es sich auch nicht. Für Music v2 solltest du außerdem auf die Länge achten, sonst ist dein Guthaben schneller weg als gedacht, das habe ich am eigenen Konto erlebt. Aber für jeden, der Stimme ernsthaft nutzt, ist ElevenLabs aktuell die erste Adresse. Und ausprobieren kannst du es kostenlos, bevor du auch nur einen Cent ausgibst.
Wenn du es selbst testen willst, kommst du hier direkt zu ElevenLabs und legst mit dem kostenlosen Tarif los.
Häufig gestellte Fragen
Es gibt einige solide Alternativen, je nach Anwendungsfall. Murf.ai ist stark für professionelle Voice-overs, Lovo hat eine riesige Stimmenauswahl und Amazon Polly ist günstig und skalierbar für Entwickler. Wenn du Transkription brauchst, sind Sonix oder Amberscript eine gute Wahl.
Einen ausführlichen Vergleich findest du in meinem Artikel zu den ElevenLabs Alternativen und in der Übersicht der besten KI-Sprachgeneratoren.