Claude Opus 4.6
Direktvergleich
Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.
Steckbrief
Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.
| Merkmal | Claude Opus 4.6 | GPT-5.6 Terra |
|---|---|---|
| Anbieter | Anthropic | OpenAI |
| Erschienen | Feb. 2026 | 9. Juli 2026 |
| Verfügbarkeit | Aktiv | Aktiv |
| Modelltyp | Proprietär | Proprietär |
| Parameter | Nicht veröffentlicht | Nicht veröffentlicht |
| Architektur | Nicht veröffentlicht | Nicht veröffentlicht |
| Kontextfenster | 1.000.000 Token | 1.050.000 Token |
| Wissensstand | Mai 2025 | 16. Februar 2026 |
| Technische Quellen | Modell, Kontext | Modell, Kontext, Wissensstand |
Kosten
Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.
| Preisart | Claude Opus 4.6 | GPT-5.6 Terra |
|---|---|---|
| API-Eingabe | 5 $ | 2 $ ≤272K / 4 $ >272K |
| API-Ausgabe | 25 $ | 12 $ ≤272K / 18 $ >272K |
| Cache lesen | 0,5 $ | 0,2 $ ≤272K / 0,4 $ >272K |
| Cache schreiben (5 Min.) | 6,25 $ | 2,5 $ ≤272K / 5 $ >272K |
| Cache schreiben (1 Std.) | 10 $ | Nicht ausgewiesen |
| Preis geprüft | 22.09.2026 Quelle | 22.09.2026 Quelle |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.
| Modell | Anbieter | Bezugsweg und Tarif | Eingabe pro 1 Mio. Token | Ausgabe pro 1 Mio. Token | Quelle |
|---|---|---|---|---|---|
| Claude Opus 4.6 | Anthropic | Direkt beim EntwicklerStandard-API | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle22.09.2026 |
| Amazon Bedrock | Über OpenRouteramazon-bedrock | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle17.10.2026 | |
| Anthropic | Über OpenRouteranthropic | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle17.10.2026 | |
| Azure | Über OpenRouterazure/global | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle17.10.2026 | |
| Claude Platform on AWS | Über OpenRouterclaude-on-aws | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle17.10.2026 | |
| Über OpenRoutergoogle-vertex/europe | 5,5 $ | 27,5 $ | Quelle17.10.2026 | ||
| Über OpenRoutergoogle-vertex/global | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle17.10.2026 | ||
| GPT-5.6 Terra | OpenAI | Direkt beim EntwicklerBis 272.000 Kontext-Token | 2 $ | 12 $ | Quelle22.09.2026 |
| OpenAI | Direkt beim EntwicklerÜber 272.000 Kontext-Token | 4 $ | 18 $ | Quelle22.09.2026 | |
| Amazon Bedrock | Über OpenRouteramazon-bedrock/us-east-1 | 2,2 $ | 13,2 $ | Quelle17.10.2026 | |
| Azure | Über OpenRouterazure | 2 $ | 12 $ | Quelle17.10.2026 | |
| Azure | Über OpenRouterazure/eu | 2,2 $ | 13,2 $ | Quelle17.10.2026 | |
| Azure | Über OpenRouterazure/us | 2,2 $ | 13,2 $ | Quelle17.10.2026 | |
| OpenAI | Über OpenRouteropenai | 2 $ | 12 $ | Quelle17.10.2026 | |
| OpenAI | Über OpenRouteropenai/fast | 4 $ | 24 $ | Quelle17.10.2026 | |
| OpenAI | Über OpenRouteropenai/flex | Günstigster erfasster Preis: 1 $ | Günstigster erfasster Preis: 6 $ | Quelle17.10.2026 |
Leistung
Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.
Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.
Nicht genug direkt vergleichbare Kategorien für ein belastbares Radar
Nur 0 von mindestens 5 Kategorien enthalten direkt vergleichbare Modellmessungen. Die Benchmarktabellen darunter zeigen die vorhandenen Belege, ohne fehlende Achsen aufzufüllen.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
| Benchmark und Aufgabe | Claude Opus 4.6 | GPT-5.6 Terra | Quelle |
|---|---|---|---|
LMArena Text, Style ControlOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 85.445 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 42.358 veröffentlichten Paarvergleichen. | Höherer Messwert1.497,663 95-%-Konfidenzintervall: ±3,27Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.465,897 95-%-Konfidenzintervall: ±4,269Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Vision, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 26.853 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 11.020 veröffentlichten Paarvergleichen. | Höherer Messwert1.294,46 95-%-Konfidenzintervall: ±6,329Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.268,044 95-%-Konfidenzintervall: ±7,452Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
MedCodeOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.6: Compute: max, Temperatur: 1, Ausgabegrenze: 30.000 tokens GPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 30.000 tokens | Höherer Messwert48,244 % | 43,414 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
MedScribeOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.6: Compute: max, Temperatur: 1, Ausgabegrenze: 30.000 tokens GPT-5.6 Terra: Reasoning: xhigh, Ausgabegrenze: 30.000 tokens | Höherer Messwert86,738 % | 82,869 % | Vals AIQuellendetailsDatenstand: 13.10.2026 |
Vibe Code Bench v1.1OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.6: Compute: max, Harness: OpenHands, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.6 Terra: Reasoning: max, Harness: OpenHands, Ausgabegrenze: 128.000 tokens | 57,573 % | Höherer Messwert74,594 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LMArena Text, Style ControlOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 80.827 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 42.358 veröffentlichten Paarvergleichen. | Höherer Messwert1.503,106 95-%-Konfidenzintervall: ±3,353Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.465,897 95-%-Konfidenzintervall: ±4,269Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Vision, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 22.304 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 11.020 veröffentlichten Paarvergleichen. | Höherer Messwert1.299,232 95-%-Konfidenzintervall: ±6,456Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.268,044 95-%-Konfidenzintervall: ±7,452Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlBusiness, management and financeTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 16.859 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 7.896 veröffentlichten Paarvergleichen. | Höherer Messwert1.499,695 95-%-Konfidenzintervall: ±5,707Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.466,115 95-%-Konfidenzintervall: ±7,508Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlChineseTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Vision, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 1.685 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 642 veröffentlichten Paarvergleichen. | Höherer Messwert1.348,115 95-%-Konfidenzintervall: ±17,347Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.313,871 95-%-Konfidenzintervall: ±24,287Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlBusiness, management and financeTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 15.865 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 7.896 veröffentlichten Paarvergleichen. | Höherer Messwert1.500,43 95-%-Konfidenzintervall: ±5,84Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.466,115 95-%-Konfidenzintervall: ±7,508Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlChineseTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Vision, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 1.488 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 642 veröffentlichten Paarvergleichen. | Höherer Messwert1.351,953 95-%-Konfidenzintervall: ±17,967Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.313,871 95-%-Konfidenzintervall: ±24,287Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlChineseTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 5.821 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 3.323 veröffentlichten Paarvergleichen. | Höherer Messwert1.545,153 95-%-Konfidenzintervall: ±8,666Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.516,639 95-%-Konfidenzintervall: ±10,891Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlCreative writing visionTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Vision, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 1.731 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 914 veröffentlichten Paarvergleichen. | Höherer Messwert1.297,75 95-%-Konfidenzintervall: ±15,034Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.255,12 95-%-Konfidenzintervall: ±20,975Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlChineseTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 5.591 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 3.323 veröffentlichten Paarvergleichen. | Höherer Messwert1.550,027 95-%-Konfidenzintervall: ±8,89Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.516,639 95-%-Konfidenzintervall: ±10,891Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlCreative writing visionTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Vision, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 1.405 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 914 veröffentlichten Paarvergleichen. | Höherer Messwert1.309,447 95-%-Konfidenzintervall: ±16,801Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.255,12 95-%-Konfidenzintervall: ±20,975Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlCodingTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 23.695 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 11.280 veröffentlichten Paarvergleichen. | Höherer Messwert1.547,708 95-%-Konfidenzintervall: ±5,22Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.516,911 95-%-Konfidenzintervall: ±6,59Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlDiagramTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Vision, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 7.260 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 2.891 veröffentlichten Paarvergleichen. | Höherer Messwert1.331,371 95-%-Konfidenzintervall: ±8,825Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.300,563 95-%-Konfidenzintervall: ±11,707Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlCodingTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 20.969 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 11.280 veröffentlichten Paarvergleichen. | Höherer Messwert1.548,395 95-%-Konfidenzintervall: ±5,448Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.516,911 95-%-Konfidenzintervall: ±6,59Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlDiagramTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Vision, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 5.999 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 2.891 veröffentlichten Paarvergleichen. | Höherer Messwert1.324,675 95-%-Konfidenzintervall: ±9,238Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.300,563 95-%-Konfidenzintervall: ±11,707Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlCreative writingTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 14.986 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 9.009 veröffentlichten Paarvergleichen. | Höherer Messwert1.478,397 95-%-Konfidenzintervall: ±6,086Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.429,2 95-%-Konfidenzintervall: ±7,438Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlEnglishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Vision, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 11.327 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 3.785 veröffentlichten Paarvergleichen. | Höherer Messwert1.296,058 95-%-Konfidenzintervall: ±8,463Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.270,126 95-%-Konfidenzintervall: ±11,03Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlCreative writingTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 14.826 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 9.009 veröffentlichten Paarvergleichen. | Höherer Messwert1.499,767 95-%-Konfidenzintervall: ±6,246Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.429,2 95-%-Konfidenzintervall: ±7,438Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlEnglishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Vision, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 9.251 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 3.785 veröffentlichten Paarvergleichen. | Höherer Messwert1.301,128 95-%-Konfidenzintervall: ±8,811Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.270,126 95-%-Konfidenzintervall: ±11,03Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlEnglishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 38.162 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 17.197 veröffentlichten Paarvergleichen. | Höherer Messwert1.506,394 95-%-Konfidenzintervall: ±4,352Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.471,979 95-%-Konfidenzintervall: ±5,623Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlHomeworkTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Vision, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 3.708 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 1.172 veröffentlichten Paarvergleichen. | 1.311,92 95-%-Konfidenzintervall: ±10,944Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | Höherer Messwert1.326,623 95-%-Konfidenzintervall: ±17,485Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlEnglishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 35.612 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 17.197 veröffentlichten Paarvergleichen. | Höherer Messwert1.513,707 95-%-Konfidenzintervall: ±4,48Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.471,979 95-%-Konfidenzintervall: ±5,623Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlHomeworkTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Vision, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 2.849 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 1.172 veröffentlichten Paarvergleichen. | 1.324,17 95-%-Konfidenzintervall: ±12,006Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | Höherer Messwert1.326,623 95-%-Konfidenzintervall: ±17,485Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlEntertainment, sports and mediaTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 19.048 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 10.858 veröffentlichten Paarvergleichen. | Höherer Messwert1.478,55 95-%-Konfidenzintervall: ±5,586Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.433,87 95-%-Konfidenzintervall: ±6,87Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlHumorTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Vision, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 1.025 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 502 veröffentlichten Paarvergleichen. | Höherer Messwert1.294,209 95-%-Konfidenzintervall: ±19,436Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.237,903 95-%-Konfidenzintervall: ±27,081Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlEntertainment, sports and mediaTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 18.282 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 10.858 veröffentlichten Paarvergleichen. | Höherer Messwert1.491,123 95-%-Konfidenzintervall: ±5,751Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.433,87 95-%-Konfidenzintervall: ±6,87Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlHumorTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Vision, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 869 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 502 veröffentlichten Paarvergleichen. | Höherer Messwert1.296,35 95-%-Konfidenzintervall: ±21,068Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.237,903 95-%-Konfidenzintervall: ±27,081Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlExcluding tiesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 64.924 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 31.435 veröffentlichten Paarvergleichen. | Höherer Messwert1.516,544 95-%-Konfidenzintervall: ±4,425Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.473,134 95-%-Konfidenzintervall: ±5,618Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlOcrTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Vision, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 19.427 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 7.536 veröffentlichten Paarvergleichen. | Höherer Messwert1.312,247 95-%-Konfidenzintervall: ±6,33Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.277,413 95-%-Konfidenzintervall: ±7,907Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlExcluding tiesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 61.691 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 31.435 veröffentlichten Paarvergleichen. | Höherer Messwert1.522,764 95-%-Konfidenzintervall: ±4,502Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.473,134 95-%-Konfidenzintervall: ±5,618Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlOcrTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Vision, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 15.929 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 7.536 veröffentlichten Paarvergleichen. | Höherer Messwert1.313,477 95-%-Konfidenzintervall: ±6,575Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.277,413 95-%-Konfidenzintervall: ±7,907Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Text, Style ControlExpert promptsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 8.806 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 4.934 veröffentlichten Paarvergleichen. | Höherer Messwert1.533,95 95-%-Konfidenzintervall: ±7,394Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.506,239 95-%-Konfidenzintervall: ±9,065Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlExpert promptsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 7.356 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 4.934 veröffentlichten Paarvergleichen. | Höherer Messwert1.545,814 95-%-Konfidenzintervall: ±7,928Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.506,239 95-%-Konfidenzintervall: ±9,065Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlFrenchTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 2.808 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 1.326 veröffentlichten Paarvergleichen. | Höherer Messwert1.496,997 95-%-Konfidenzintervall: ±13,146Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.494,648 95-%-Konfidenzintervall: ±17,853Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlFrenchTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 2.619 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 1.326 veröffentlichten Paarvergleichen. | Höherer Messwert1.511,426 95-%-Konfidenzintervall: ±13,557Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.494,648 95-%-Konfidenzintervall: ±17,853Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlGermanTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 1.328 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 675 veröffentlichten Paarvergleichen. | Höherer Messwert1.490,887 95-%-Konfidenzintervall: ±17,278Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.475,268 95-%-Konfidenzintervall: ±23,325Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlGermanTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 1.284 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 675 veröffentlichten Paarvergleichen. | Höherer Messwert1.507,167 95-%-Konfidenzintervall: ±17,309Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.475,268 95-%-Konfidenzintervall: ±23,325Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlHard promptsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 55.452 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 27.663 veröffentlichten Paarvergleichen. | Höherer Messwert1.527,527 95-%-Konfidenzintervall: ±3,977Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.488,924 95-%-Konfidenzintervall: ±4,985Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlHard promptsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 51.483 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 27.663 veröffentlichten Paarvergleichen. | Höherer Messwert1.531,566 95-%-Konfidenzintervall: ±4,093Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.488,924 95-%-Konfidenzintervall: ±4,985Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlHard prompts, EnglishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 25.280 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 11.078 veröffentlichten Paarvergleichen. | Höherer Messwert1.529,961 95-%-Konfidenzintervall: ±5,118Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.489,52 95-%-Konfidenzintervall: ±6,589Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlHard prompts, EnglishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 23.143 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 11.078 veröffentlichten Paarvergleichen. | Höherer Messwert1.535,921 95-%-Konfidenzintervall: ±5,299Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.489,52 95-%-Konfidenzintervall: ±6,589Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlInstruction followingTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 28.622 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 15.046 veröffentlichten Paarvergleichen. | Höherer Messwert1.499,444 95-%-Konfidenzintervall: ±4,848Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.463,168 95-%-Konfidenzintervall: ±5,982Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlInstruction followingTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 26.036 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 15.046 veröffentlichten Paarvergleichen. | Höherer Messwert1.512,245 95-%-Konfidenzintervall: ±5,064Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.463,168 95-%-Konfidenzintervall: ±5,982Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlJapaneseTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 941 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 671 veröffentlichten Paarvergleichen. | Höherer Messwert1.483,858 95-%-Konfidenzintervall: ±21,248Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.474,65 95-%-Konfidenzintervall: ±25,434Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlJapaneseTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 922 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 671 veröffentlichten Paarvergleichen. | Höherer Messwert1.498,901 95-%-Konfidenzintervall: ±21,325Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.474,65 95-%-Konfidenzintervall: ±25,434Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlKoreanTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 1.536 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 825 veröffentlichten Paarvergleichen. | Höherer Messwert1.465,035 95-%-Konfidenzintervall: ±16,873Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.424,887 95-%-Konfidenzintervall: ±21,613Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlKoreanTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 1.361 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 825 veröffentlichten Paarvergleichen. | Höherer Messwert1.445,732 95-%-Konfidenzintervall: ±17,684Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.424,887 95-%-Konfidenzintervall: ±21,613Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlLegal and governmentTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 6.844 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 3.617 veröffentlichten Paarvergleichen. | Höherer Messwert1.506,526 95-%-Konfidenzintervall: ±8,092Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.474,89 95-%-Konfidenzintervall: ±10,597Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlLegal and governmentTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 6.593 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 3.617 veröffentlichten Paarvergleichen. | Höherer Messwert1.510,822 95-%-Konfidenzintervall: ±8,22Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.474,89 95-%-Konfidenzintervall: ±10,597Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlLife, physical and social scienceTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 14.216 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 6.920 veröffentlichten Paarvergleichen. | Höherer Messwert1.518,741 95-%-Konfidenzintervall: ±6,004Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.475,761 95-%-Konfidenzintervall: ±7,851Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlLife, physical and social scienceTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 13.449 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 6.920 veröffentlichten Paarvergleichen. | Höherer Messwert1.528,541 95-%-Konfidenzintervall: ±6,139Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.475,761 95-%-Konfidenzintervall: ±7,851Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlLonger queriesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 37.162 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 19.741 veröffentlichten Paarvergleichen. | Höherer Messwert1.516,98 95-%-Konfidenzintervall: ±4,682Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.468,103 95-%-Konfidenzintervall: ±5,694Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlLonger queriesTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 34.277 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 19.741 veröffentlichten Paarvergleichen. | Höherer Messwert1.522,054 95-%-Konfidenzintervall: ±4,811Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.468,103 95-%-Konfidenzintervall: ±5,694Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlMathTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 4.642 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 1.887 veröffentlichten Paarvergleichen. | Höherer Messwert1.505,04 95-%-Konfidenzintervall: ±9,289Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.480,912 95-%-Konfidenzintervall: ±13,636Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlMathTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 4.148 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 1.887 veröffentlichten Paarvergleichen. | Höherer Messwert1.517,433 95-%-Konfidenzintervall: ±9,697Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.480,912 95-%-Konfidenzintervall: ±13,636Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlMathematical professionsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 4.797 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 2.395 veröffentlichten Paarvergleichen. | Höherer Messwert1.512,7 95-%-Konfidenzintervall: ±9,399Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.491,232 95-%-Konfidenzintervall: ±12,526Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlMathematical professionsTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 4.208 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 2.395 veröffentlichten Paarvergleichen. | Höherer Messwert1.525,513 95-%-Konfidenzintervall: ±9,98Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.491,232 95-%-Konfidenzintervall: ±12,526Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlMedicine and healthcareTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 6.382 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 3.022 veröffentlichten Paarvergleichen. | Höherer Messwert1.512,795 95-%-Konfidenzintervall: ±8,433Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.460,232 95-%-Konfidenzintervall: ±11,667Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlMedicine and healthcareTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 6.092 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 3.022 veröffentlichten Paarvergleichen. | Höherer Messwert1.518,12 95-%-Konfidenzintervall: ±8,547Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.460,232 95-%-Konfidenzintervall: ±11,667Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Text, Style ControlMulti-turnTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Text, style control GPT-5.6 Terra: Snapshot: gpt-5.6-terra-xhigh, Reasoning: xhigh, Harness: Arena Text, style controlClaude Opus 4.6: Arena-Bewertung aus 14.990 veröffentlichten Paarvergleichen.GPT-5.6 Terra: Arena-Bewertung aus 6.820 veröffentlichten Paarvergleichen. | Höherer Messwert1.512,066 95-%-Konfidenzintervall: ±5,994Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.470,5 95-%-Konfidenzintervall: ±7,966Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand | |||
Eigene Modelltests
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
Gemeinsame Testrunde: 4ae5d8eeb9a9
In dieser Runde nicht verfügbar
Community-Klassiker für eine freie SVG-Zeichnung.
Claude Opus 4.6
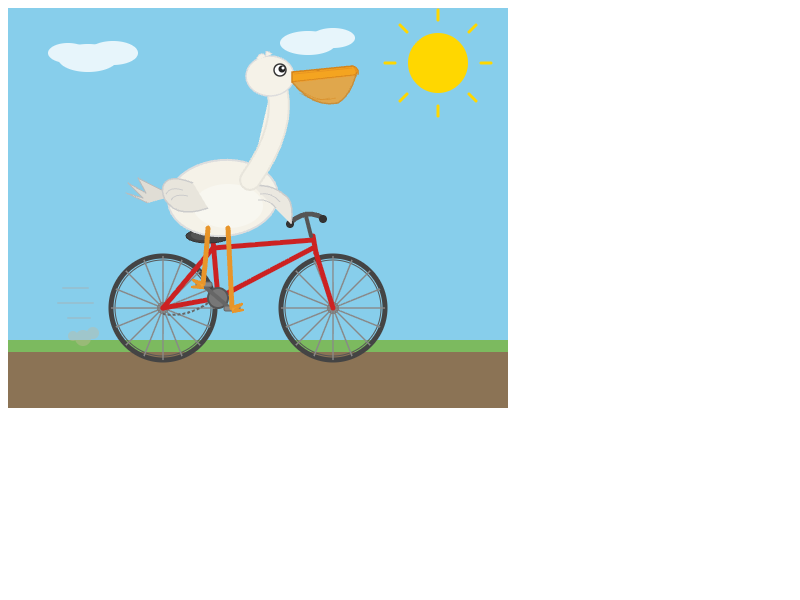
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
GPT-5.6 Terra
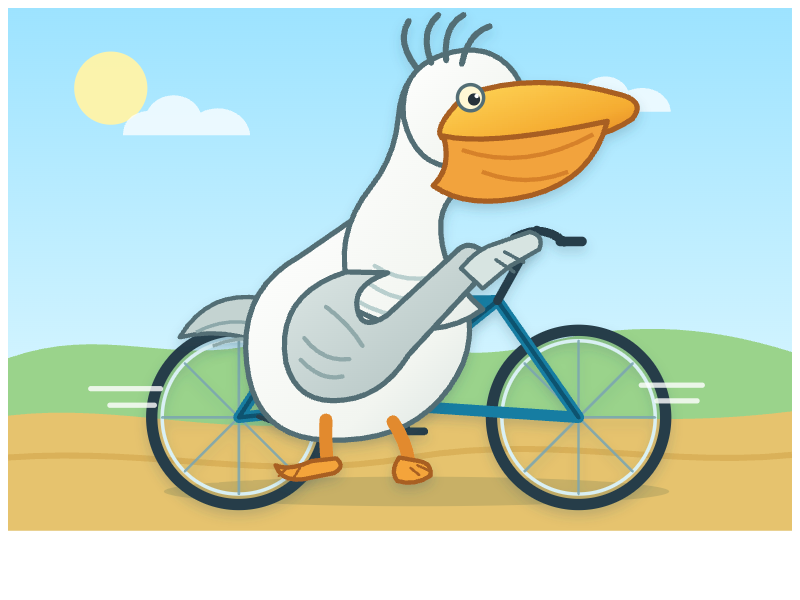
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)So liest du den Vergleich
Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.
Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.
Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.
Weitere Duelle
Vergleiche Claude Opus 4.6 und GPT-5.6 Terra mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.