Zum Hauptinhalt springen

Fireworks ResearchSprachmodellForschungsvorschau

Ember-1

Für Ember-1 gibt es noch keinen Wert im Gesamtindex, weil zu wenige unabhängige Benchmark-Ergebnisse vorliegen. Aus den Herstellerangaben schätzen wir rund 102,5 Punkte (95-%-Bereich 81,4 bis 123,5). Das ist keine unabhängige Messung.

Leistungvorläufig, nur eine Quelle

100,6Gesamtindexhöher ist besser

Nur Messreihen von Vals AI, ohne Platz.

Temponicht gemessen

k. A.noch keine Messung

Preiskein API-Preis

k. A.je 1 Mio. Tokenniedriger ist besser

Kontextk. A.

k. A.Token im Kontextfenster

Beliebtheitnoch keine Daten

k. A.ohne Such- oder Nutzungsdaten

Zusammenfassung

Ember-1 soll das lange Reasoning von Kimi K3 gezielt verkürzen. Fireworks hat den Checkpoint anhand von Aufgabenfeedback nachtrainiert und berichtet für sieben Benchmarks und zwei Kunden-A/B-Tests von 35-50 % kürzeren Denkprozessen ohne Genauigkeitsverlust. Fireworks stellt Ember-1 als zeitlich begrenzte Forschungsvorschau über die eigene API bereit.

Ember-1 im eigenen Test

SVG-Kurztest

Ein SVG-Auftrag mit denselben festen Einstellungen für alle Modelle, ohne verdecktes Nachdenken.

Ember-1

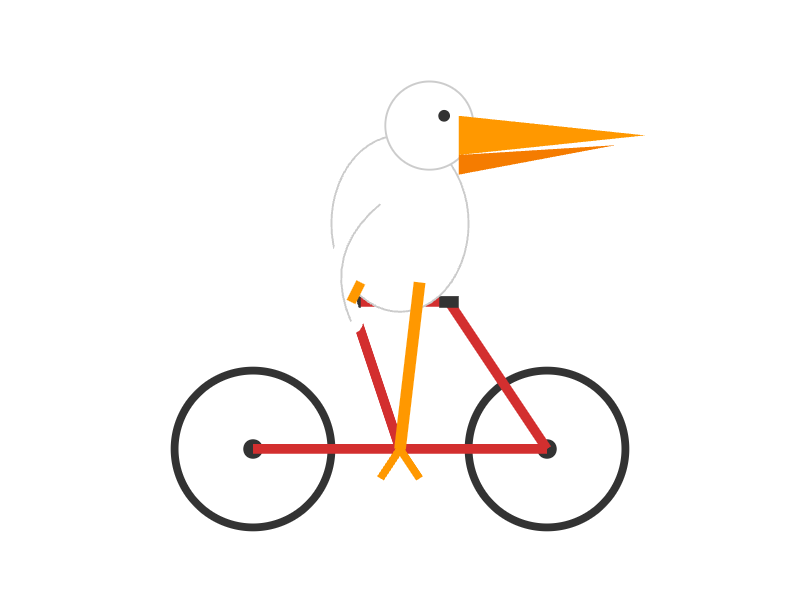
Ember-1: SVG-Kurztest

Auftrag

Gib nur ein eigenständiges SVG eines Pelikans zurück, der Fahrrad fährt. Verwende viewBox „0 0 800 600“, einfache Formen, zwei deutlich sichtbare Räder und einen erkennbaren Pelikan mit langem Schnabel. Höchstens 30 SVG-Elemente und 1.800 Zeichen. Kein Markdown, keine Erklärungen, Kommentare, Skripte, Animationen, CSS oder externen Ressourcen.

Englischer Original-Auftrag

Return only one standalone SVG of a pelican riding a bicycle. Use viewBox="0 0 800 600", simple shapes, two clearly visible wheels and a recognizable pelican with a long beak. At most 30 SVG elements and 1800 characters. No Markdown, explanations, comments, scripts, animation, CSS or external resources.

14.10.2026 · 0,0079 $

Testdetails
Testlauf
14.10.2026
Anbieter
fireworks
API-Modell
fireworks/ember-1
Ausgabe
511 Token
Reasoning
API meldet 0 Reasoning-Tokens
Kosten des Versuchs
0,0079 $
Testrunde
43b8c5c46830
Frühere Tests

Die Antwort hat das Tokenlimit erreicht. Es liegt keine vollständige Aufzeichnung vor.

Pelikan auf dem Fahrrad

Auftrag (englisches Original)

Generate an SVG of a pelican riding a bicycle

06.10.2026 · 108 s · 0,12 $

Visuell noch nicht bewertet. Eine erfolgreiche Aufzeichnung bestätigt weder korrekte Physik noch die vollständige Umsetzung des Prompts.

Testdetails
Datum des Testlaufs
06.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
fireworks/ember-1
Reasoning-Einstellung
high
Tokenlimit inklusive Reasoning
8.192 Token
Ausgabe-Token
8.192 Token
Kosten des Versuchs
0,1232 $
Antwortzeit
107,5 s
API-Modell laut Antwort
fireworks/ember-1
Festgelegter Endpunkt
Fireworks | fireworks/ember-1-20260923
Temperatur
Anbieterstandard
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Nicht bestanden
Ursprung der Aufgabe: Simon Willison

Alle Benchmark-Werte

Jeder veröffentlichte Messwert mit Quelle, Testbedingungen und Vergleichsmodellen.

Alle 311 veröffentlichten Benchmark-Werte anzeigen

Seite 1 von 26

Messungen ohne passende Vergleichswerte

Für diese Messungen fehlen passende Vergleichswerte unter gleichen Testbedingungen. Die Originalwerte und Quellen bleiben hier nachlesbar.

BioMysteryBench: Hard (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
29,412
Messgröße
Genauigkeit
Einheit
%
Benchmark-Version
1
Kategorie
general
Aufgabe
human_difficult
Aufgabenbezeichnung
Hard
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-07
Methodik
Kennung des Quellmodells: fireworks/ember-1. Name des Quellmodells: Ember-1. Anbieter laut Quelle: Fireworks AI. Evaluator: Vals AI. Datensatztyp: public. Stand der Rangliste: 2026-11-05. Harness: Terminus 2. Maximale Ausgabetoken: 131072. Latenz in Sekunden: 794.874. Standardfehler: 6.792. Kosten je Aufgabe in USD: 1.359207. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-biomysterybench-2026-11-07-c2992129e13e. Prüfsumme der Quelldaten: c2992129e13e1455796b51fe354f18fa049ad9dcfe02fd66196230a60aeea9df. Parserversion: vals-astro-v4. Importiert am: 2026-11-07. Quellenkohorte: vals-biomysterybench:1:human_difficult
Quelle Vals AI
BioMysteryBench: Human-solvable (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
75,799
Messgröße
Genauigkeit
Einheit
%
Benchmark-Version
1
Kategorie
general
Aufgabe
human_solvable
Aufgabenbezeichnung
Human-solvable
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-07
Methodik
Kennung des Quellmodells: fireworks/ember-1. Name des Quellmodells: Ember-1. Anbieter laut Quelle: Fireworks AI. Evaluator: Vals AI. Datensatztyp: public. Stand der Rangliste: 2026-11-05. Harness: Terminus 2. Maximale Ausgabetoken: 131072. Latenz in Sekunden: 512.907. Standardfehler: 2.283. Kosten je Aufgabe in USD: 0.801772. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-biomysterybench-2026-11-07-c2992129e13e. Prüfsumme der Quelldaten: c2992129e13e1455796b51fe354f18fa049ad9dcfe02fd66196230a60aeea9df. Parserversion: vals-astro-v4. Importiert am: 2026-11-07. Quellenkohorte: vals-biomysterybench:1:human_solvable
Quelle Vals AI
BioMysteryBench: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
67,037
Messgröße
Genauigkeit
Einheit
%
Benchmark-Version
1
Kategorie
general
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-07
Methodik
Kennung des Quellmodells: fireworks/ember-1. Name des Quellmodells: Ember-1. Anbieter laut Quelle: Fireworks AI. Evaluator: Vals AI. Datensatztyp: public. Stand der Rangliste: 2026-11-05. Harness: Terminus 2. Maximale Ausgabetoken: 131072. Latenz in Sekunden: 566.167. Standardfehler: 3.032. Kosten je Aufgabe in USD: 0.907066. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-biomysterybench-2026-11-07-c2992129e13e. Prüfsumme der Quelldaten: c2992129e13e1455796b51fe354f18fa049ad9dcfe02fd66196230a60aeea9df. Parserversion: vals-astro-v4. Importiert am: 2026-11-07. Quellenkohorte: vals-biomysterybench:1:overall
Quelle Vals AI
Code Migration: CLI (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
23,344
Messgröße
Genauigkeit
Einheit
%
Benchmark-Version
1
Kategorie
coding
Aufgabe
cli
Aufgabenbezeichnung
CLI
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-07
Methodik
Kennung des Quellmodells: fireworks/ember-1. Name des Quellmodells: Ember-1. Anbieter laut Quelle: Fireworks AI. Evaluator: Vals AI. Datensatztyp: private. Stand der Rangliste: 2026-10-29. Maximale Ausgabetoken: 131072. Latenz in Sekunden: 18009.163. Standardfehler: 2.901. Kosten je Aufgabe in USD: 65.083706. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-code-migration-2026-11-07-23c368426e3e. Prüfsumme der Quelldaten: 23c368426e3e145dbba17219be86d157ba6ebf3b5c25c8f7ba2d5723986fb9b1. Parserversion: vals-astro-v4. Importiert am: 2026-11-07. Quellenkohorte: vals-code-migration:1:cli
Quelle Vals AI
Code Migration: COBOL (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
60
Messgröße
Genauigkeit
Einheit
%
Benchmark-Version
1
Kategorie
coding
Aufgabe
cobol
Aufgabenbezeichnung
COBOL
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-07
Methodik
Kennung des Quellmodells: fireworks/ember-1. Name des Quellmodells: Ember-1. Anbieter laut Quelle: Fireworks AI. Evaluator: Vals AI. Datensatztyp: private. Stand der Rangliste: 2026-10-29. Maximale Ausgabetoken: 131072. Latenz in Sekunden: 5638.286. Standardfehler: 16.33. Kosten je Aufgabe in USD: 9.192215. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-code-migration-2026-11-07-23c368426e3e. Prüfsumme der Quelldaten: 23c368426e3e145dbba17219be86d157ba6ebf3b5c25c8f7ba2d5723986fb9b1. Parserversion: vals-astro-v4. Importiert am: 2026-11-07. Quellenkohorte: vals-code-migration:1:cobol
Quelle Vals AI
Code Migration: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
32,508
Messgröße
Genauigkeit
Einheit
%
Benchmark-Version
1
Kategorie
coding
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-07
Methodik
Kennung des Quellmodells: fireworks/ember-1. Name des Quellmodells: Ember-1. Anbieter laut Quelle: Fireworks AI. Evaluator: Vals AI. Datensatztyp: private. Stand der Rangliste: 2026-10-29. Maximale Ausgabetoken: 131072. Latenz in Sekunden: 14916.444. Standardfehler: 4.626. Kosten je Aufgabe in USD: 51.110833. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-code-migration-2026-11-07-23c368426e3e. Prüfsumme der Quelldaten: 23c368426e3e145dbba17219be86d157ba6ebf3b5c25c8f7ba2d5723986fb9b1. Parserversion: vals-astro-v4. Importiert am: 2026-11-07. Quellenkohorte: vals-code-migration:1:overall
Quelle Vals AI
CyberBench v1.1: Overall (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
69,524
Messgröße
Genauigkeit
Einheit
%
Benchmark-Version
1.1
Kategorie
cybersecurity
Aufgabe
overall
Aufgabenbezeichnung
Overall
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-07
Methodik
Kennung des Quellmodells: fireworks/ember-1. Name des Quellmodells: Ember-1. Anbieter laut Quelle: Fireworks AI. Evaluator: Vals AI. Datensatztyp: private. Stand der Rangliste: 2026-11-05. Maximale Ausgabetoken: 131072. Latenz in Sekunden: 1322.414. Standardfehler: 5.558. Kosten je Aufgabe in USD: 2.426078. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-cyber-2026-11-07-cc5fe09bf1f8. Prüfsumme der Quelldaten: cc5fe09bf1f8c926613f8893f823a902fb33f219303590d6a2794e43708d67a5. Parserversion: vals-astro-v4. Importiert am: 2026-11-07. Quellenkohorte: vals-cyberbench:1.1:overall
Quelle Vals AI
CyberBench v1.1: Patch (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
85,714
Messgröße
Genauigkeit
Einheit
%
Benchmark-Version
1.1
Kategorie
cybersecurity
Aufgabe
patch
Aufgabenbezeichnung
Patch
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-07
Methodik
Kennung des Quellmodells: fireworks/ember-1. Name des Quellmodells: Ember-1. Anbieter laut Quelle: Fireworks AI. Evaluator: Vals AI. Datensatztyp: private. Stand der Rangliste: 2026-11-05. Maximale Ausgabetoken: 131072. Latenz in Sekunden: 749.952. Standardfehler: 4.676. Kosten je Aufgabe in USD: 0.997885. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-cyber-2026-11-07-cc5fe09bf1f8. Prüfsumme der Quelldaten: cc5fe09bf1f8c926613f8893f823a902fb33f219303590d6a2794e43708d67a5. Parserversion: vals-astro-v4. Importiert am: 2026-11-07. Quellenkohorte: vals-cyberbench:1.1:patch
Quelle Vals AI
CyberBench v1.1: PoC (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
53,333
Messgröße
Genauigkeit
Einheit
%
Benchmark-Version
1.1
Kategorie
cybersecurity
Aufgabe
poc
Aufgabenbezeichnung
PoC
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-07
Methodik
Kennung des Quellmodells: fireworks/ember-1. Name des Quellmodells: Ember-1. Anbieter laut Quelle: Fireworks AI. Evaluator: Vals AI. Datensatztyp: private. Stand der Rangliste: 2026-11-05. Maximale Ausgabetoken: 131072. Latenz in Sekunden: 1894.876. Standardfehler: 6.441. Kosten je Aufgabe in USD: 3.854271. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-cyber-2026-11-07-cc5fe09bf1f8. Prüfsumme der Quelldaten: cc5fe09bf1f8c926613f8893f823a902fb33f219303590d6a2794e43708d67a5. Parserversion: vals-astro-v4. Importiert am: 2026-11-07. Quellenkohorte: vals-cyberbench:1.1:poc
Quelle Vals AI
EMB: Comps (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
60,496
Messgröße
Genauigkeit
Einheit
%
Benchmark-Version
1
Kategorie
finance
Aufgabe
comps
Aufgabenbezeichnung
Comps
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-07
Methodik
Kennung des Quellmodells: fireworks/ember-1. Name des Quellmodells: Ember-1. Anbieter laut Quelle: Fireworks AI. Evaluator: Vals AI. Datensatztyp: private. Stand der Rangliste: 2026-10-20. Maximale Ausgabetoken: 131072. Latenz in Sekunden: 1860.074. Standardfehler: 8.4. Kosten je Aufgabe in USD: 3.11394. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-emb-2026-11-07-58c3d75f6221. Prüfsumme der Quelldaten: 58c3d75f62214d43f193221a41ce1ca96c1531cd447eb361f50467eb94485fed. Parserversion: vals-astro-v4. Importiert am: 2026-11-07. Quellenkohorte: vals-emb:1:comps
Quelle Vals AI
EMB: Dataroom (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
81,195
Messgröße
Genauigkeit
Einheit
%
Benchmark-Version
1
Kategorie
finance
Aufgabe
dataroom
Aufgabenbezeichnung
Dataroom
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-07
Methodik
Kennung des Quellmodells: fireworks/ember-1. Name des Quellmodells: Ember-1. Anbieter laut Quelle: Fireworks AI. Evaluator: Vals AI. Datensatztyp: private. Stand der Rangliste: 2026-10-20. Maximale Ausgabetoken: 131072. Latenz in Sekunden: 1365.657. Standardfehler: 5.386. Kosten je Aufgabe in USD: 1.491495. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-emb-2026-11-07-58c3d75f6221. Prüfsumme der Quelldaten: 58c3d75f62214d43f193221a41ce1ca96c1531cd447eb361f50467eb94485fed. Parserversion: vals-astro-v4. Importiert am: 2026-11-07. Quellenkohorte: vals-emb:1:dataroom
Quelle Vals AI
EMB: DCF (Messwert, Testbedingungen und Quelle anzeigen)
Originalwert
50,289
Messgröße
Genauigkeit
Einheit
%
Benchmark-Version
1
Kategorie
finance
Aufgabe
dcf
Aufgabenbezeichnung
DCF
Richtung
Mehr ist besser
Quellentyp
independent-evaluator
Auswertung
Vals AI
Status
active
Abrufdatum
2026-11-07
Methodik
Kennung des Quellmodells: fireworks/ember-1. Name des Quellmodells: Ember-1. Anbieter laut Quelle: Fireworks AI. Evaluator: Vals AI. Datensatztyp: private. Stand der Rangliste: 2026-10-20. Maximale Ausgabetoken: 131072. Latenz in Sekunden: 1789.304. Standardfehler: 10.058. Kosten je Aufgabe in USD: 2.118596. Quellenkennung: vals-ai. Kennung der Evidenzaufnahme: vals-emb-2026-11-07-58c3d75f6221. Prüfsumme der Quelldaten: 58c3d75f62214d43f193221a41ce1ca96c1531cd447eb361f50467eb94485fed. Parserversion: vals-astro-v4. Importiert am: 2026-11-07. Quellenkohorte: vals-emb:1:dcf
Quelle Vals AI

Seite 1 von 26

Alle technischen Daten

Architektur

Modellklasse
Spezialisiertes Sprachmodell
Quelle: Modellklasse

Wasserzeichen und Herkunft

KI-Wasserzeichen meint unsichtbare Signale in der Ausgabe. Sichtbare Zeichen und Herkunftsmetadaten sind getrennt aufgeführt. Unbekannt bedeutet, dass für die jeweilige Angabe kein ausreichender Beleg vorliegt.

KI-Wasserzeichen
Unbekannt
ohne Quelle
Wasserzeichen-Technik
Nicht bekannt
ohne Quelle

Lizenz und Zugang

Zugang
Fireworks API, Forschungsvorschau mit begrenzter Laufzeit
Quelle: Zugang
Abschaltung
Keine angekündigt
ohne Quelle

API

Modellkennung
Ember-1
Quelle: Modellkennung

Weitere Angaben

Ausgangspunkt
Aus Kimi K3 nachtrainiert
Quelle: Ausgangspunkt

Preise

Kein Abozugang in Deutschland erfasst.

Alle Tarife im KI-Abo-Vergleich

Häufige Fragen zu Ember-1

Wie gut ist Ember-1 in Benchmarks?

Unabhängige Ergebnisse reichen noch nicht für den Gesamtindex. Eine Schätzung aus 3 Herstellerangaben (DeepSWE v1.1 75,2 %, SWE-bench Verified 92,2 %, Terminal-Bench 2.1 82 %) ergibt rund 102,5 Punkte, mit einem 95-%-Bereich von 81,4 bis 123,5. Die Schätzung ist an Modellen geeicht, für die es sowohl Herstellerangaben als auch unabhängige Messungen gibt. Herstellerangaben liegen bei einigen Tests deutlich über unabhängigen Messungen; die Eichung gleicht das im Mittel aus.

Herstellerschätzung, kein Wert des Gesamtindex

Kann ich Ember-1 lokal nutzen?

Nein. Fireworks Research veröffentlicht die Gewichte nicht.

Angaben von Fireworks Research

Offene Gewichte
nein
Lizenz
k. A.
Parameter
k. A.
davon aktiv je Token
k. A.

Quellen und Datenstand

Alle 23 Quellen anzeigen

Benchmarkquellen im Überblick

Welche unabhängigen Auswerter dieses Modell getestet haben. Das ist Abdeckung, keine Qualitätsrangliste.

AuswerterTestreihenGesamtindizesErfasste aktive Messwerte
Vals AI171144

Ohne Herstellerangaben sowie historische oder strittige Ergebnisse; diese stehen gekennzeichnet bei den Einzelwerten.

ArtNachweis und Datenstand
RecherchestandRecherchestand 4. Oktober 2026. 5 Quellen-URLs geprüft. Das dokumentiert die geprüften Quellen, nicht sämtliche Veröffentlichungen zu diesem Modell.
Nicht veröffentlicht

Vals Science Index component results and scored denominator

Hinweis

Das aktuelle Leaderboard nennt den Gesamtwert und die Gleichgewichtung, aber weder Komponentenwerte von Ember-1 noch Fallzahl oder KI.

Weitere QuelleFireworks Ember-1 announcement (abgerufen 3. Oktober 2026; 4. Oktober 2026) · Fireworks Ember-1 announcement · Redaktionelle Beschreibung geprüft am 4. Oktober 2026
Weitere QuelleVals AI (abgerufen 7. November 2026)123456789101112131415
Weitere QuelleVals AI (abgerufen 16. Oktober 2026)12
Weitere QuelleVals AI (abgerufen 16. Oktober 2026; 31. Oktober 2026; 7. November 2026)
Weitere QuelleVals AI (abgerufen 17. Oktober 2026; 7. November 2026)
Weitere QuelleDuelLab GameBench 2 model results (abgerufen 28. Oktober 2026; 2. November 2026; 5. November 2026; 9. November 2026; 11. November 2026; 12. November 2026; 15. November 2026)
Weitere QuelleParallel Search Capability Leaderboard (abgerufen 28. Oktober 2026; 5. November 2026)
Weitere QuelleParallel Search Capability Leaderboard (abgerufen 5. November 2026)