Löschst du einen Chat, verschwindet dann auch die Datei daraus? Und was passiert mit einer Erinnerung, die ChatGPT daraus gespeichert hat?
Nicht automatisch. ChatGPT behandelt Chatverlauf, Memory, Library-Dateien, App-Freigaben und API-Objekte als unterschiedliche Dinge. Auch Training, Speicherung und Löschung beantworten verschiedene Fragen. Welche Regeln für deine Eingabe gelten, hängt außerdem davon ab, ob du ein persönliches Konto, einen verwalteten Workspace, die API oder Codex nutzt.
Ich teste ChatGPT seit November 2022 systematisch und habe damit inzwischen mehr als 300 Stunden verbracht.
- Training, Speicherung, Memory, Aufbewahrung und Löschung sind verschiedene Fragen. Keine einzelne Einstellung beantwortet sie alle.
- Persönliches Konto, Business, Edu, API und Codex haben unterschiedliche Vertrags- und Datenwege. Einen AVV (DPA) gibt es für Business, Enterprise und die API, nicht für Plus oder Pro.
- Prüfe für Chat, Datei, App oder Aufgabe den jeweiligen Empfänger und Löschweg. Teste Grenzen mit erfundenen Daten statt mit echten Kundendaten.
Was die Datenschutzantwort für deinen ChatGPT-Zugang bedeutet
Prüfe zuerst, mit welchem ChatGPT-Zugang du arbeitest. Ein persönliches Konto, ein Unternehmens-Workspace, Edu, die API und Codex greifen auf unterschiedliche Verträge und Einstellungen zurück. Das OpenAI-Datenschutzangebot für Organisationen nennt das Standard-DPA für Business, Enterprise und die API. Für Edu verweist OpenAI auf eine eigene Student Data Privacy Agreement.
| Funktion | Persönliches Konto | Business / Enterprise | Edu | API | Codex |
|---|---|---|---|---|---|
| Training | Free, Plus, Pro standardmäßig an; Go-Standard offen | standardmäßig aus | standardmäßig aus | standardmäßig aus | folgt Anmeldeweg und Aufgabe |
| Vertrag | kein öffentliches Standard-DPA | DPA | Student Data Privacy Agreement | DPA verfügbar | folgt Konto oder API |
| Aufbewahrung | Chats bis zur Löschung; Library getrennt | Workspace-Regeln und Funktion | Workspace-Regeln und Funktion | Abuse-Logs und API-Objekte getrennt | Chat, lokale Dateien, VM und API getrennt |
| Datenresidenz | keine persönliche Workspace-Option | Enterprise nach Freigabe; Business nicht gelistet | berechtigter Workspace | freigegebenes Projekt und Endpoint | App, CLI, Web oder API prüfen |
| Erster Prüfpunkt | Datenkontrollen und Memory | Vertrag und Admin-Regeln | Student-Vereinbarung und Order Form | Endpoint und Datenkontrollen | lokal oder Cloud, ChatGPT oder API |
Die Tabelle ist eine Orientierung. Ob eine Funktion verfügbar ist, hängt von Konto, Region, Workspace-Rolle und Produktfreigabe ab. Auch zwei Dienste mit einer 30-Tage-Angabe können völlig andere Inhalte und Anlässe meinen. Die API-Frist betrifft standardmäßige Protokolle zur Missbrauchsüberwachung.
Sie beschreibt weder jede ChatGPT-Unterhaltung noch gespeicherte API-Objekte oder den Zustand einer Codex-Cloud-VM.
Wenn du ChatGPT privat nutzt, prüfst du zuerst Training, Verlauf, Memory und Library. Verwaltet deine Organisation das Konto, kommen Adminrechte, Vertragsunterlagen und Workspace-Aufbewahrung hinzu. Bei der API prüfst du Endpoints, gespeicherte Objekte und Organisationsfreigaben. Und bei Codex fragst du zusätzlich, wo Befehle laufen und ob deine Eingabe ChatGPT oder einen API-Anbieter erreicht.
Persönliches Konto, Business, Edu und Enterprise trennen
Ein Data Processing Addendum (DPA) ist OpenAIs Bezeichnung für den Auftragsverarbeitungsvertrag, kurz AVV. Er regelt die Verarbeitung personenbezogener Daten in deinem Auftrag. Die API ist eine Programmierschnittstelle, über die du Modelle in eigene Software einbindest; sie hat einen eigenen Vertrags- und Abrechnungsweg.
Ein bezahltes Privatkonto ist nicht automatisch ein Unternehmensvertrag. OpenAI veröffentlicht sein Standard-DPA für ChatGPT Business, ChatGPT Enterprise und die API. Das DPA ergänzt das Services Agreement und betrifft die Verarbeitung von Kundendaten im Auftrag. Es wird nicht allein dadurch Vertragsbestandteil, dass du für ein Plus- oder Pro-Abo bezahlst.
Den aktuellen Vertrag und die Vereinbarung, die deine Organisation tatsächlich angenommen hat, musst du zusammen prüfen.
Für Kundinnen und Kunden mit Sitz im EWR oder in der Schweiz nennt das aktuelle Standard-DPA OpenAI Ireland Ltd als OpenAI-Vertragspartei, wie das Standard-DPA festhält. Für andere Kundinnen und Kunden nennt es OpenAI OpCo, LLC. Edu läuft über einen eigenen Vertragsweg. OpenAI verlinkt dafür die Student Data Privacy Agreement.
Die aktuell veröffentlichte Student Data Privacy Agreement nennt OpenAI, LLC und bindet den Vertrag an das jeweilige Services Agreement beziehungsweise die Order Form. Sie zeigt keine entsprechende EWR- oder Schweiz-Ausnahme. Daraus folgt aber nicht, dass eine Hochschule niemals eine zusätzliche Vereinbarung nach Artikel 28 DSGVO schließen kann. Die Institution sollte Student-Vereinbarung, Order Form und mögliche Ergänzungen gemeinsam prüfen.
Was Admins sehen und behalten können
Ein verwaltetes Konto bringt außerdem eine andere Admin-Ebene mit. Die Hilfe zu verwalteten Konten beschreibt mögliche Adminzugriffe auf Chats, Exporte und Löschung abhängig von Rolle, Workspace-Regeln und anwendbarem Recht. In Business können andere Mitglieder private Chats nicht automatisch sehen. Usage Analytics zeigt keine vollständigen Transkripte.
Die Business-Datenschutzhilfe trennt diese Mitgliederansicht vom Adminzugriff.
Enterprise und Edu können Compliance-Protokolle für unterstützte ChatGPT- und Work-Ereignisse bereitstellen. Die Logs haben eine eigene Aufbewahrung und bilden nicht automatisch jede Dateioperation, jeden Browseraufruf oder jeden Agent-Schritt ab. In Business bleiben Chats, Dateien und Canvas-Dokumente eines entfernten Mitglieds laut OpenAIs Aufbewahrungshinweis unter Umständen unbegrenzt gespeichert und können bei einer erneuten Aufnahme wiederhergestellt werden.
Enterprise und Edu können dagegen Workspace-Aufbewahrungsregeln konfigurieren. Frage deshalb vor dem Upload, welche Admins was sehen können und welche Richtlinie für genau diese Datenart gilt.
Bei einem privaten persönlichen Konto hast du nicht dieselbe Workspace-Verwaltung. Wenn deine Organisation ein bestehendes Konto beansprucht oder in ein verwaltetes Konto umwandelt, lies die Meldung genau. Entscheidend ist, mit welchem Konto du gerade angemeldet bist. Ein zweites persönliches Profil im Browser ist keine zuverlässige Grenze, wenn du tatsächlich im Organisations-Workspace arbeitest.
Was die Trainingseinstellung und Feedback ändern
„Nicht fürs Training“ bedeutet nicht „nicht verarbeitet“ und auch nicht „nicht gespeichert“. ChatGPT muss deine Eingabe verarbeiten, um eine Antwort zu erzeugen. Die Trainingseinstellung betrifft einen anderen Zweck. Wenn du ein persönliches Konto nutzt, findest du sie üblicherweise unter Einstellungen > Datenkontrollen > Das Modell für alle verbessern.
Die Bezeichnungen können je nach Konto, App und Rollout abweichen. OpenAI beschreibt die Optionen in der Hilfe zu ChatGPT-Datenkontrollen.
Die englische Browseransicht zeigt den ausgeschalteten Schalter „Improve the model for everyone“ unter Settings > Data controls:
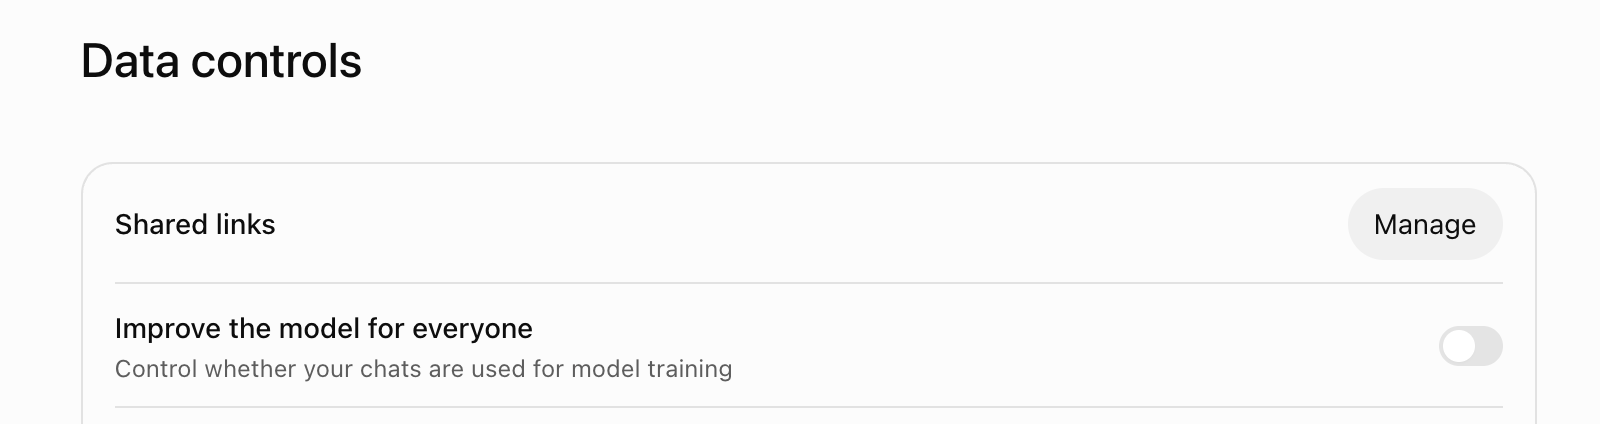
OpenAI nennt Free-, Plus- und Pro-Workspaces als standardmäßig freigegeben, damit ihre Inhalte zur Modellverbesserung verwendet werden können. Du kannst die Einstellung ausschalten. Dann werden neue Unterhaltungen im normalen Ablauf nicht für die Modellverbesserung genutzt. Das löscht weder ältere Chats noch bereits de-identifizierte Inhalte und stoppt keine Verarbeitung, die zur Bereitstellung oder Absicherung des Dienstes nötig ist.
Für Go ist ein Opt-out dokumentiert, aber OpenAI nennt in der eigenen Default-Erklärung nicht eindeutig, ob dieser Tarif standardmäßig ein- oder ausgeschaltet ist.
Feedback und App-Inhalte
Eine Ausnahme betrifft freiwilliges Feedback. Wenn du eine Antwort bewertest, kann OpenAI die Unterhaltung, zu der die Bewertung gehört, zur Verbesserung verwenden, selbst wenn der allgemeine Schalter aus ist. Bei Business und Enterprise gilt der Standard, dass Workspace-Inhalte nicht zum Modelltraining verwendet werden. Das gilt auch für Edu und API-Inhalte.
Die verfügbaren Freigaben unterscheiden sich aber je Produkt. API-Organisationsadmins können bestimmte Daten für Feedback, Auswertung, Fine-Tuning oder Input- und Output-Verbesserung freigeben, sofern die Organisation dafür berechtigt ist. Nicht jede Organisation sieht dieselben Optionen.
Auch verbundene Apps brauchen eine Einzelfallprüfung. Bei persönlichen Konten können ihre Inhalte entsprechend der Trainingseinstellung verwendet werden. Für direkt angebundene Google-Daten veröffentlicht OpenAI eine engere Ausnahme mit eigenen Grenzen. Sie betrifft nicht automatisch Feedback, manuell kopierte oder hochgeladene Inhalte oder Informationen, die in eine Modellantwort eingehen.
Übertrage die Google-Regel nicht auf jede andere verbundene App.
OpenAI beschreibt Schritte, um personenbezogene Informationen in geeigneten Trainingsdaten zu reduzieren. Das ist keine Zusage, dass jeder Eintrag anonymisiert wird. Trenne deshalb die Frage nach Modellverbesserung weiterhin von Chatlöschung, Memory, Aufbewahrung und Empfängern.
Temporary Chat, Archiv und Löschen nicht gleichsetzen
Temporary Chat blendet den Verlauf aus, begrenzt die Personalisierung je nach gewählter Einstellung und nimmt den Chat laut OpenAI-Beschreibung nicht in die Modellverbesserung auf, solange er temporär bleibt. Trotzdem ist es kein Nullspeicher-Modus. OpenAI kann eine Kopie bis zu 30 Tage aus Sicherheitsgründen behalten.
Außerdem gelten für Daten, die du an eine App, ein GPT oder eine Action sendest, die Regeln des jeweiligen Empfängers.
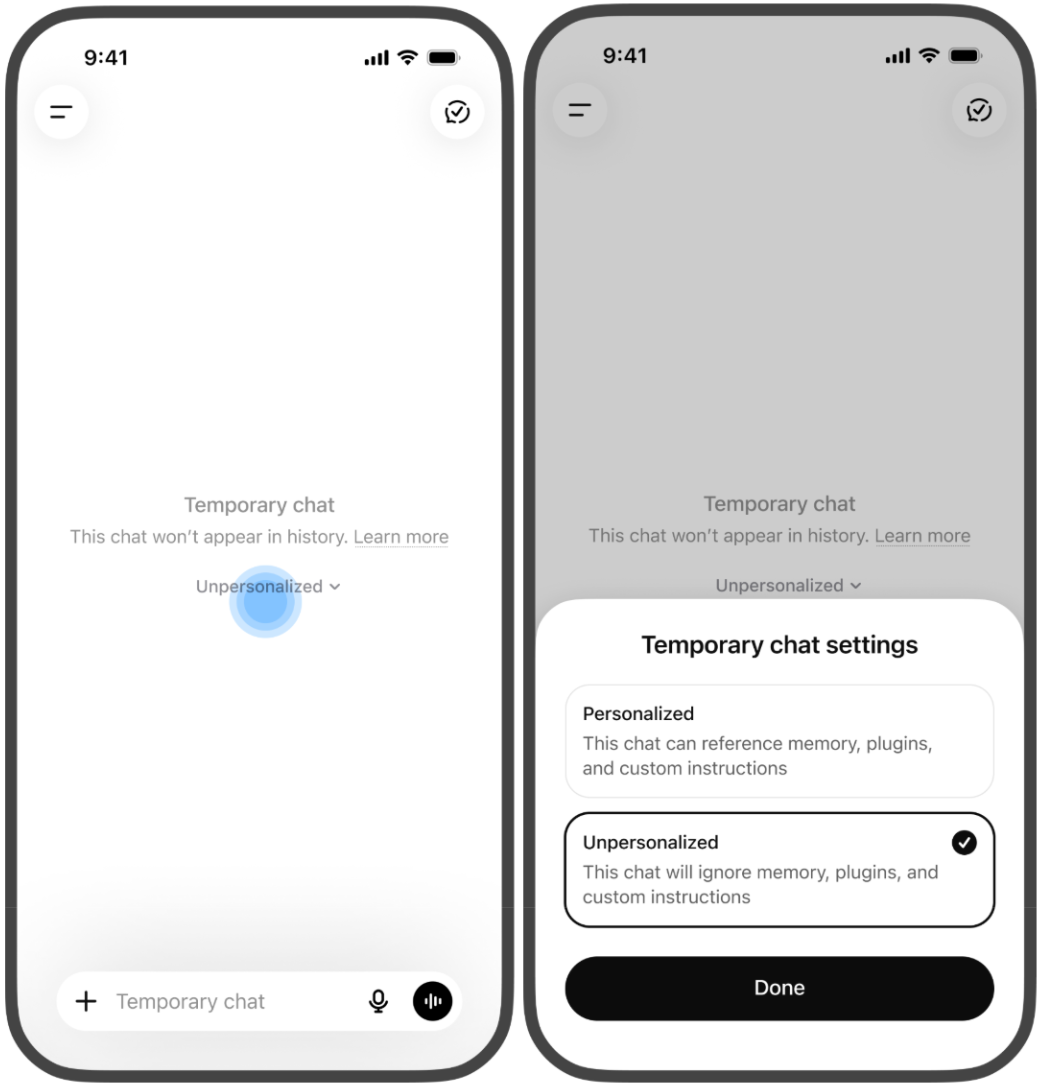
In der aktuellen Produktbeschreibung kannst du zwischen Personalisiert und Nicht personalisiert wählen. Die personalisierte Variante kann vorhandene Memory, eigene Anweisungen und Plugins verwenden. Sie legt aber keine neuen Erinnerungen an und aktualisiert sie auch nicht. In der nicht personalisierten Variante greift ChatGPT nicht auf diese Personalisierungsquellen zurück.
Die OpenAI-Hilfe zeigt die Auswahl in der mobilen Oberfläche. In dieser englischen Herstellerabbildung ist „Unpersonalized“ ausgewählt. Je nach Konto und Plattform kann die Ansicht abweichen:
Für berechtigte Enterprise-Kunden sind Temporary Chats 30 Tage über die Compliance API verfügbar, auch wenn der Workspace eine andere eigene Aufbewahrungsfrist festlegt. OpenAI beschreibt außerdem seltene Sicherheitsfälle, in denen begrenzter Kontext aus früheren Gesprächen auch bei deaktivierter Memory-Funktion genutzt werden kann. Die Temporary-Chat-Hilfe nennt diese Grenzen.
Archiv, Löschung und Export
Archiviere einen Chat, wenn du ihn aus der Seitenleiste entfernen möchtest. Er bleibt dabei gespeichert und durchsuchbar. OpenAI beschreibt Archivieren und Löschen als getrennte Aktionen. Beim Löschen verschwindet der Chat sofort aus deiner Ansicht.
Die dauerhafte Löschung ist normalerweise innerhalb von 30 Tagen vorgesehen. Rechtliche oder sicherheitsbezogene Pflichten und bereits de-identifizierte oder vom Konto getrennte Inhalte sind veröffentlichte Ausnahmen. Ein gelöschter Chat lässt sich über die Oberfläche nicht wiederherstellen.
Eine Kontolöschung ist ein eigener Schritt. Sie ist endgültig und nimmt dir den Zugang zu den OpenAI-Diensten. OpenAI sagt in der Kontolöschhilfe, Kontodaten normalerweise innerhalb von 30 Tagen zu löschen, soweit keine rechtlichen oder Sicherheitsgründe eine begrenzte längere Speicherung erlauben. Ein direkt über ChatGPT abgerechnetes Abo wird dabei beendet.
Wenn Apple oder Google dein Abo abrechnet, musst du es zuerst im jeweiligen Store kündigen.
Für einen Export kannst du deine Chat-Historie und weitere Kontodaten anfordern. OpenAI nennt bis zu sieben Tage für die Bereitstellung; der Download-Link läuft nach 24 Stunden ab. Ein Export gibt dir eine Kopie. Er stellt keine bereits gelöschten Chats wieder her.
Eine Grenze der öffentlichen Angaben bleibt offen. Die Temporary-Chat-Hilfe verspricht kein Training, während die allgemeine Datenkontrollen-Hilfe für freiwilliges Feedback eine Ausnahme beschreibt. Sie klären nicht ausdrücklich, wie beides zusammenspielt. Gib deshalb aus einem vertraulichen Temporary Chat kein Feedback mit Gesprächsinhalten weiter.
Memory und Chatverlauf getrennt verwalten
ChatGPT kann für spätere Antworten Informationen aus früheren Chats, gespeicherten Erinnerungen, eigenen Anweisungen, Library-Dateien und verbundenen Apps nutzen. Die Memory-Hilfe beschreibt je nach Konto eine Erinnerungsübersicht (Memory-Zusammenfassung) oder die bisherigen Einstellungen für gespeicherte Erinnerungen und Chatverlauf. Eine Zusammenfassung zeigt nicht alle gespeicherten Details und Quellen.
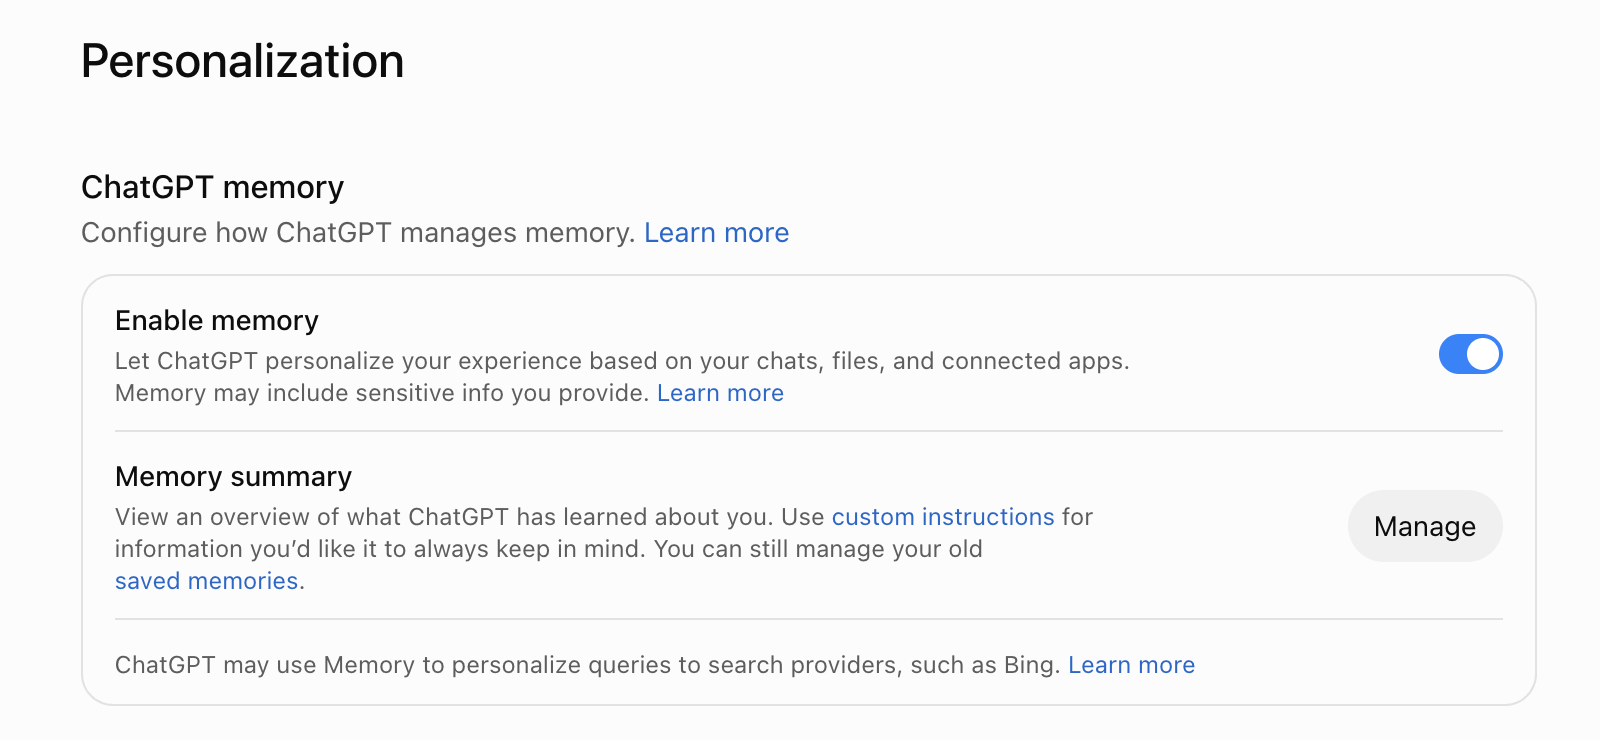
In der englischen Browseransicht liegt „Enable memory“ unter Settings > Personalization. Memory ist hier eingeschaltet. Darunter liegt die Schaltfläche „Manage“ für die Erinnerungsübersicht:
Prüfe unter Einstellungen > Personalisierung > Erinnerung, welche Kontrollen dein Konto anbietet. Bei den bisherigen Kontrollen löscht das Ausschalten von „Chatverlauf berücksichtigen“ daraus abgeleitete Informationen innerhalb von 30 Tagen, nicht die ursprünglichen Chats. Das Ausschalten der Referenz auf gespeicherte Erinnerungen schaltet zugleich die Chatverlauf-Referenz aus, löscht aber keine gespeicherten Erinnerungen.
Wenn dein Konto eine Erinnerungsübersicht anbietet, entfernt „Löschen und Erinnerung deaktivieren“ die darin dargestellten erinnerten Informationen. Die Quellchats bleiben bestehen. „Nicht noch einmal erwähnen“ ist keine Löschfunktion.
So sieht die Korrektur eines markierten Texts in der mobilen Erinnerungsübersicht aus. Die englische Beispielaufnahme stammt aus der OpenAI-Hilfe:
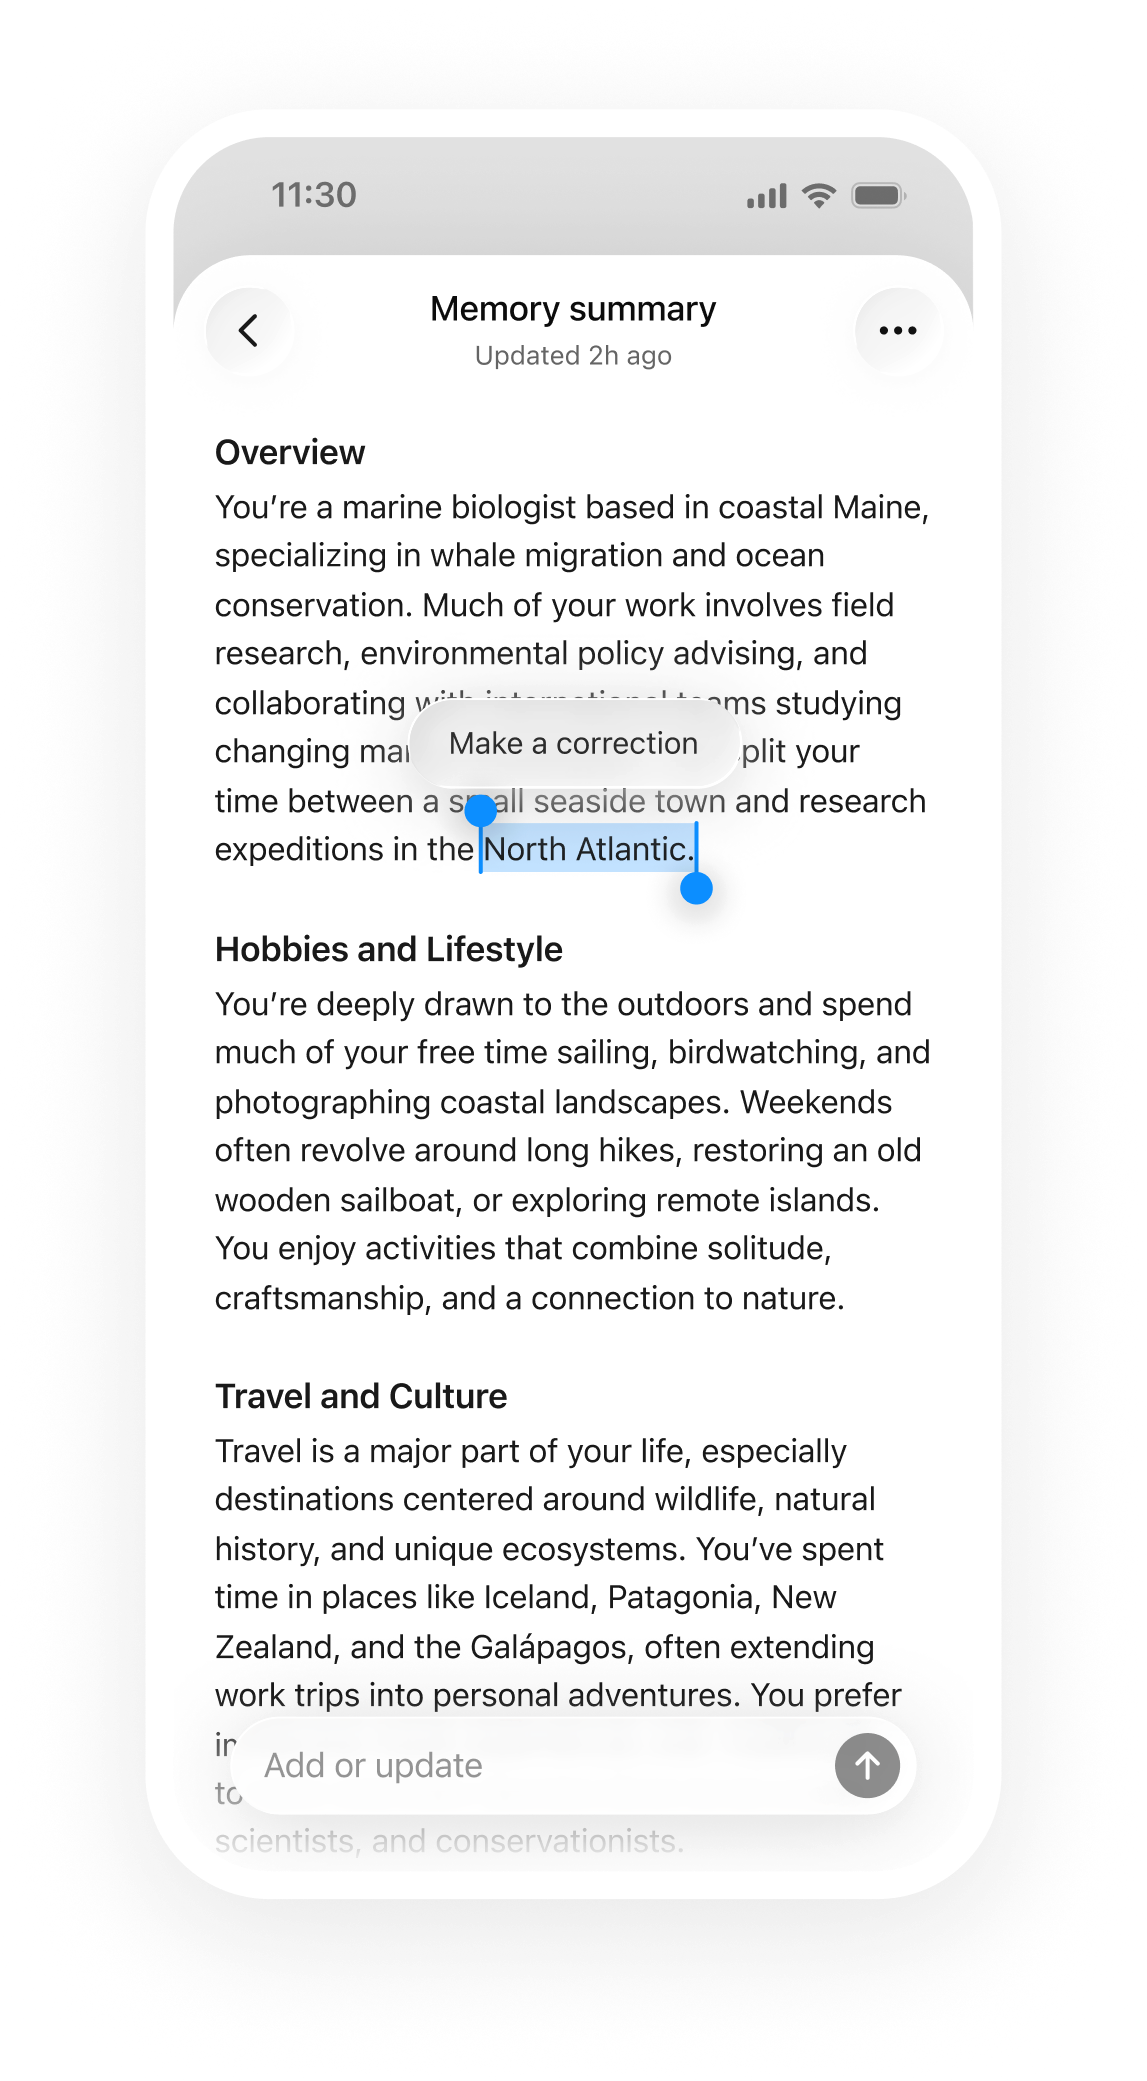
Die einzelnen Optionen hängen von Tarif, Region und Workspace ab.
Für eine möglichst vollständige Entfernung musst du die Information aus allen relevanten Quellen entfernen. Dazu gehören, soweit vorhanden, die Memory-Zusammenfassung, gespeicherte Erinnerungen, normale und archivierte Quellchats, Library-Dateien, eigene Anweisungen und verbundene Apps. Ein gelöschter Chat entfernt einen separat gespeicherten Memory-Eintrag nicht automatisch. Das Trennen einer App verhindert künftigen Zugriff, löscht aber keine bereits übernommenen Inhalte.
Bereits in alten Antworten erwähnte Inhalte verschwinden dadurch nicht aus einer Kopie, die du schon exportiert oder geteilt hast. OpenAI kann für gelöschte Erinnerungen bis zu 30 Tage ein Sicherheits- oder Debugging-Protokoll behalten.
Dasselbe Prinzip gilt bei Temporary Chat. Im personalisierten Modus können bestehende Erinnerungen und Anweisungen einfließen. Der temporäre Dialog erzeugt selbst keine neue Erinnerung. Suchst du nur nach einem Chat, den du verborgen hast, schau zuerst im Archiv.
Suchst du nach einer Information, die ChatGPT wieder aufgreift, prüfe Memory und die Chatverlauf-Referenz separat.
Dateien, Library, Voice und verbundene Apps
Ein Chat kann mehr als einen Speicherort berühren. Eine hochgeladene Datei kann zum Gespräch gehören und zusätzlich in der ChatGPT-Library liegen. In der Library verwaltest du gespeicherte Dateien getrennt vom Chat. Wenn du nur den Chat löschst, verschwindet die Library-Kopie nicht automatisch.
Öffne die Bibliothek, wähle die Datei und lösche sie dort ebenfalls. Die Systemlöschung ist normalerweise innerhalb von 30 Tagen vorgesehen, mit den genannten rechtlichen, sicherheitsbezogenen und De-Identifizierungs-Ausnahmen.
Dateien aus einem Temporary Chat werden nicht automatisch in deinem Konto oder der Library abgelegt. Speicherst du einen temporären Chat, können geeignete Dateien anschließend in der Library erscheinen. Eine Datei, die ChatGPT über ein verbundenes Google Drive oder einen anderen Dienst abruft, ist dagegen nicht zwingend eine Library-Kopie. Lösche oder entziehe sie beim Quellanbieter, wenn du sie dort entfernen willst.
Die Voice-Hilfe trennt Audiodateien vom Text. Bei Standard Voice wird Audio nach der Transkription gelöscht, außer du hast Audiotraining erlaubt. Live-/Advanced-Audioclips und Advanced-Videoclips werden für 30 Tage aufbewahrt; das Transkript folgt dem Chatverlauf. Beim Löschen eines Chats sollen auch seine Clips innerhalb von 30 Tagen verschwinden.
Sicherheits- und Rechtspflichten sowie zuvor fürs Training freigegebene, bereits vom Konto getrennte Clips sind Ausnahmen. Audio- und Videotraining erfordern eine eigene Freigabe. Transkripte können dagegen dem allgemeinen Trainingsschalter folgen. Die Clip-Freigabe ist für persönliche Free-, Plus- und Pro-Workspaces dokumentiert, für Business, Enterprise und Edu ausgeschlossen.
ChatGPT Record ist laut Hilfe in der macOS-App für Plus, Pro, Business, Enterprise und Edu verfügbar. Die Rohaufnahme wird nach der Transkription gelöscht und nicht fürs Training verwendet. Transkripte und Canvas-Dokumente folgen der Gesprächsaufbewahrung. Die separate Trainings-FAQ nennt Free, Plus und Pro für ihre mögliche Nutzung bei eingeschaltetem Trainingsschalter; daraus folgt keine Record-Verfügbarkeit für Free.
Business, Enterprise und Edu sind standardmäßig vom Training ausgeschlossen. Go wird in diesen Angaben nicht genannt.
Apps und Connectors
Eine verbundene App kann je nach Dienst suchen, Inhalte lesen, Daten für Deep Research liefern, vorher ausgewählte Inhalte synchronisieren oder Aktionen ausführen. OpenAI beschreibt diese App-Funktionen und Berechtigungen pro Verbindung. Dafür kann sie relevante Teile deiner Eingabe oder des Chat-Kontexts an einen Drittanbieter senden. Das ist ein zusätzlicher Empfänger mit eigenen Bedingungen und Speicherregeln.
App-Zugriff, Freigabe einer Aktion, Training, Memory und Löschung sind getrennte Kontrollen. Eine Verbindung zu trennen verhindert künftigen Zugriff, löscht aber keine bereits gespeicherte Unterhaltung oder Erinnerung.
Eine vom Admin verwaltete Synchronisierung ist nicht dasselbe wie eine Live-Verbindung mit deinem App-Konto. Sie indexiert ausgewählte Inhalte eines unterstützten Dienstes im Workspace, damit sie dort durchsucht werden können. Dafür gelten Plan-, Rollen-, Quellen- und Regionsgrenzen. Änderungen und Zugriffsrechte aus der Quell-App können verzögert im Index ankommen.
Prüfe also sowohl die Verbindung als auch die Regel, nach der gespeicherte Workspace-Daten gelöscht werden.
GPTs, Actions und geteilte Chats
Die OpenAI-Hilfe zu GPTs sagt, dass GPT-Ersteller einzelne Unterhaltungen anderer Nutzer nicht sehen können. Das beantwortet aber nicht, wohin Eingaben bei einer Action fließen. Ruft ein GPT einen externen Dienst auf, kann es passende Teile deiner Eingabe dorthin übertragen. OpenAI kontrolliert nicht, wie der Drittanbieter diese Daten anschließend speichert oder verwendet.
Temporary Chat ändert die Bedingungen beim Empfänger nicht.
Ein persönlicher Chat-Link ist für alle zugänglich, die ihn erhalten oder weiterleiten. Workspace-Links folgen anderen Regeln, die OpenAI in der Hilfe zu geteilten Unterhaltungen beschreibt. Links in einem Workspace bleiben auf berechtigte Mitglieder desselben Workspace beschränkt. Einen Ablaufzeitpunkt kannst du für den Link nicht einstellen.
Wenn du ihn löschst, endet der Zugriff über diesen Link. Kopien, die Empfänger bereits gespeichert haben, bleiben davon unberührt. Das Veröffentlichen eines GPTs ist wiederum eine andere Freigabe als das Teilen eines Gesprächs.
Agent, Browser und Computer Use
OpenAI bezeichnet ChatGPT Agent inzwischen als nicht mehr verfügbare Funktion und verweist auf ChatGPT Work. Dieselbe Hilfeseite enthält weiterhin frühere Tarif- und Bedienhinweise. Daraus lässt sich keine aktuelle Verfügbarkeit für jeden Zugang ableiten.
Für den früheren Agent beschreibt OpenAI cloudgestützte App- und Browserbedienung, Admin-Kontrollen in Enterprise und Edu sowie Protokolle der Unterhaltungen, aber nicht einzelner Aktionen. Ein administrativ synchronisierter App-Index war dort nicht direkt durchsuchbar. Über Chat oder Deep Research konnte dieselbe Quelle dennoch erreichbar sein. Diese Angaben gelten nicht automatisch für Work.
Die Agent-Hilfe nennt für frühere Agent-Chats, den zugehörigen Browserverlauf und Screenshots eine Aufbewahrung bis zur Löschung. Gelöschte Chats und Screenshots werden demnach innerhalb von 90 Tagen aus OpenAIs Systemen entfernt. Übertrage diese Frist nicht auf Work oder gewöhnliche ChatGPT-Unterhaltungen.
Der Cloud-Browser in ChatGPT Work läuft auf einem entfernten Rechner mit eigenen Cookies und Sitzungen. Er übernimmt nicht deine lokalen Tabs, gespeicherten Kennwörter oder Anmeldungen. Eine Website für die Nutzung freizugeben ist außerdem nicht dasselbe wie eine Buchung, Übermittlung oder Zahlung zu bestätigen. Die Sitzung bleibt laut Hilfe bestehen, bis sie abläuft oder du sie löschst.
Website-Inhalte, die ChatGPT verarbeitet, folgen den ChatGPT-Datenkontrollen.
Computer Use in der Desktop-App kann den lokalen Bildschirm lesen und Apps bedienen. So können sichtbare Website-Texte, App-Inhalte, Dateien und Screenshots Teil des ChatGPT-Kontexts werden. Auf macOS braucht die App dafür Screen-Recording- und Bedienungshilfen-Rechte. Unter Windows muss das Zielfenster sichtbar bleiben.
Ein lokaler Bildschirmzugriff bedeutet nicht, dass auch das Modell lokal rechnet. Die verarbeiteten Inhalte und Screenshots folgen den Datenkontrollen des verwendeten ChatGPT-Zugangs.
Die Browser-Erweiterung nutzt dagegen deinen ausgewählten, angemeldeten Browser. Sie ist weder der entfernte Cloud-Browser noch Codex Cloud. OpenAI sagt, dass nicht zusätzlich ein vollständiger Verlauf aller Browseraktionen gespeichert wird. Texte, Screenshots, Werkzeugaufrufe oder Zusammenfassungen, die in den Chat-Kontext gelangen, sind trotzdem ChatGPT-Inhalte.
Atlas hat eigene Datenkontrollen
OpenAI kündigte eine Atlas-Umstellung mit geplantem Enddatum 9. August 2026 an. Die Enterprise-Hilfe beschreibt Atlas weiterhin als Early Access. Diese Angaben bestätigen weder einen einheitlichen aktuellen Zugang noch die Abschaltung jeder Installation.
Falls du Atlas noch verwendest, prüfe seine eigenen Datenkontrollen. Browser Memory ist unabhängig von ChatGPT Memory. „Include web browsing“ betrifft die Trainingsfreigabe von besuchten Seiten. Bei eingeschalteter allgemeiner Modellverbesserung können jedoch weiterhin Atlas-Chats einschließlich angehängter Seiteninhalte fürs Training genutzt werden. „Help improve browsing & search“ betrifft Diagnoseprotokolle und ist eine separate Einstellung.
Für den beschriebenen Enterprise-Early-Access gelten Workspace-Aufbewahrung, Compliance API und regionale Zusagen nicht pauschal für alle Atlas-Daten. Die Enterprise-Hilfe nennt etwa Browserverlauf, Browser Memory und Agent-Aktivität als Daten mit abweichendem Schutzumfang. Übertrage daher keine allgemeine Enterprise-Zusage ungeprüft auf Atlas.
Deep Research und Work
Deep Research kann öffentliche Webseiten, Uploads und unterstützte verbundene Apps als Quellen verwenden. Die App-Integration nutzt lesende Aktionen, keine Schreibaktionen. Welche Quelle erscheint, hängt von Tarif, Region, Workspace-Rolle, Adminfreigabe und den Rechten beim Quellanbieter ab. Eine Research-Unterhaltung in ChatGPT folgt den Chat-Kontrollen.
Bei Work Cloud mit lokalem Computerzugriff bleibt die Aufgabe cloudgestützt koordiniert. Diese Betriebsart bietet keine strikte Zero Data Retention. Eine Aufgabe kann bei nicht verfügbarem Rechner in einer Cloud-Umgebung fortgesetzt werden; lokale Ausführungsregeln werden dabei nicht automatisch übernommen.
Work-Unterhaltungen folgen den Workspace-Aufbewahrungsregeln. Ausführungszustände und Snapshots haben einen eigenen Lebenszyklus. Das Beenden einer Aufgabe oder Löschen ihres Chats löscht nicht sofort alle Artefakte. Auch Work-Auditprotokolle erfassen nicht jede einzelne Aktion. Prüfe Cloud-Browser, Netzwerkzugriff, Apps und regionale Zusagen jeweils für die aktivierte Funktion.
Work- und Codex-Aufgaben haben eigene Kontrollpfade. Ein Skill allein ist zunächst eine Sammlung aus Anweisungen und Dateien. Ein Plugin kann zusätzlich einen MCP-Server, ein Skript oder Werkzeuge mit eigenem Betreiber enthalten. Lies deshalb die Beschreibung jeder Erweiterung, bevor du vertrauliche Eingaben damit kombinierst.
Bei einer Remote-Verbindung kann ein angebundener Rechner Dateien, Programme, MCP-Server oder Zugangsdaten bereitstellen. Der Ausführungsort kann lokal sein, während ChatGPT weiterhin Anfrage und Kontext verarbeitet. Eine Codex-Sandbox für Terminalbefehle begrenzt weder Browser- oder Computersteuerung noch Apps und Cloud-Aufgaben. Die wichtigsten Prüfungen lauten daher: Was kann die Funktion sehen, welche Teile sendet sie, wer erhält sie und wo gilt dessen Aufbewahrungsregel?
API-Aufbewahrung und Datenresidenz separat prüfen
Ein ChatGPT-Abo enthält keine API-Nutzung. ChatGPT und API sind getrennte Angebote mit eigenen Vertragsunterlagen und getrennter Abrechnung. Du kannst dafür dieselbe OpenAI-Anmeldung verwenden. Für die API bietet OpenAI ein DPA an.
API-Inhalte werden standardmäßig nicht fürs Modelltraining verwendet. Berechtigte Organisationsadmins können eigene Freigaben für Feedback, Auswertung oder Modellverbesserung aktivieren. Prüfe diese im API-Organisationskonto.
30 Tage gelten nicht für jedes API-Objekt
Die oft genannte 30-Tage-Angabe betrifft standardmäßige Protokolle zur Missbrauchsüberwachung, nicht jeden gespeicherten API-Zustand. OpenAI beschreibt sie in den API-Datenkontrollen. Sie können Prompts, Antworten und abgeleitete Sicherheitsmerkmale enthalten. Gesetzliche Pflichten oder begründete Sicherheitsinteressen können eine längere Aufbewahrung rechtfertigen.
Davon getrennt speichert die API bestimmte Anwendungsobjekte. Responses bleiben bei gespeichertem Zustand standardmäßig mindestens 30 Tage gespeichert; mit store=false schaltest du diese Response-Speicherung aus. Conversation-Objekte haben dagegen kein allgemeines 30-Tage-Ablaufdatum. Die Doku zu Conversation State beschreibt die getrennte Aufbewahrung.
Files, Vector Stores und Batch-Objekte können bestehen bleiben, bis du sie löschst oder eine konfigurierte Ablauffrist greift.
Zero Data Retention (ZDR, eingeschränkte Inhaltsspeicherung) und Modified Abuse Monitoring (MAM, geänderte Missbrauchsüberwachung) brauchen OpenAIs Genehmigung. ZDR schließt Customer Content im normalen Ablauf aus den Protokollen zur Missbrauchsüberwachung aus. Die Dokumentation nennt aber Sicherheits- und Modell-Ausnahmen, bei denen Inhalte doch gespeichert oder geprüft werden können. Außerdem schaltet ZDR nicht bei jeder API-Funktion gespeicherte Objekte ab.
Files, Vector Stores und nicht zugelassene Endpoints können eigenen Zustand behalten. Prüfe die Speicherregeln für Endpunkte, Modelle und Sicherheitsprüfungen für deine Anfrage.
Welche Grenzen hat die API-Region Europa?
Die API-Dokumentation nennt einen Europe-Endpunkt unter eu.api.openai.com. Europa bedeutet hier EWR und Schweiz. Ein freigegebenes regionales Projekt kann unterstützte Inhalte in dieser Region speichern. Mit einem globalen Projekt lässt sich regionale Verarbeitung für eine Anfrage wählen, ohne damit dessen Speicherregion zu ändern.
Für Nicht-US-Regionen sind zusätzliche Freigaben zu Kontrollen zur Missbrauchsüberwachung und ein Modified Retention Amendment erforderlich. Die API-Residenzdokumentation beschreibt die Voraussetzungen. Modell, Endpoint, Tool und Feature müssen einzeln unterstützt werden.
ChatGPT-Workspace-Residenz ist eine andere Funktion. OpenAI listet dafür berechtigte neue Enterprise- und Edu-Workspaces. Business steht nicht in der aktuellen Liste. Inference Residency kann für unterstützte Enterprise- und Edu-Inhalte zusätzlich GPU-Ausführung in der gewählten Region abdecken.
Die Zusagen gelten nur für ausdrücklich aufgeführte Daten und Funktionen. CPU-Schritte wie Textextraktion, Routing und Koordination, Kontometadaten, externe Apps, MCP, Websuche und Drittanbieter können außerhalb der Region verarbeitet werden.
Wenn dein Vertrag eine regionale Verarbeitung verlangt, lies die Live-Matrix vor der Auswahl erneut. Eine Region im Projektnamen oder ein europäischer Firmensitz beweist weder eine bestimmte Speicherregion noch eine vollständige Verarbeitung innerhalb der EU.
Was du selbst nach der DSGVO prüfen musst
Ein DPA und ausgeschaltetes Training helfen, entscheiden aber nicht über deinen gesamten Einsatz. Lege vor einem Upload fest, welche Daten du für welchen Zweck verarbeiten willst. Für berufliche oder geschäftliche Abläufe prüfst du insbesondere diese Punkte:
- Rechtsgrundlage: Für personenbezogene Daten brauchst du eine Grundlage nach Art. 6 DSGVO. Bei Gesundheitsdaten und anderen besonderen Kategorien kommt eine Ausnahme nach Art. 9 hinzu. Der Anbieter-Vertrag allein erlaubt solche Daten nicht.
- Rollen und AVV: Wer Zweck und wesentliche Mittel bestimmt, ist verantwortlich. Verarbeitung im Auftrag braucht einen passenden Vertrag nach Art. 28. Arbeitest du selbst im Auftrag, prüfe die schriftliche Genehmigung weiterer Unterauftragsverarbeiter. Eigene Zwecke eines Anbieters beurteilst du gesondert.
- Information und Rechte: Informiere Betroffene nach Art. 13 oder 14, soweit erforderlich. Lege Auskunft, Berichtigung und Löschung fest und führe ein Verarbeitungsverzeichnis nach Art. 30, soweit die Pflicht gilt.
- Minimierung und Schutz: Übertrage nur benötigte Angaben. Begrenze Zugriffe und Speicherdauer und setze angemessene Maßnahmen nach Art. 25 und 32 um. Ein Trainings-Opt-out ersetzt diese Grenzen nicht.
- Drittlandtransfer: Prüfe Empfänger und Fernzugriffe außerhalb des EWR. Eine europäische Speicherregion schließt solche Zugriffe nicht aus. Du brauchst eine passende Übermittlungsgrundlage. Bei Standardvertragsklauseln prüfst du das Schutzniveau und erforderliche Zusatzmaßnahmen.
- Hohes Risiko: Prüfe vorab die Notwendigkeit einer Datenschutz-Folgenabschätzung nach Art. 35, einschließlich gesetzlicher Fälle und Muss-Listen der Aufsicht. Bleibt ein nicht ausreichend begrenzbares hohes Risiko, ist vor der Verarbeitung die Konsultation nach Art. 36 erforderlich.
Art. 22 betrifft ausschließlich automatisierte Entscheidungen mit rechtlicher oder ähnlich erheblicher Wirkung. Eine menschliche Prüfung muss tatsächlich wirksam sein und Änderungen ermöglichen. Rein persönliche oder familiäre Verarbeitung kann unter die Haushaltsausnahme fallen; sie nimmt OpenAI nicht automatisch aus eigenen Anbieterpflichten heraus.
Die DSGVO, die KI-Orientierungshilfe der Datenschutzkonferenz und die EDSA-Empfehlungen zu Drittlandtransfers liefern die Grundlagen. Kläre deinen konkreten Fall mit Datenschutzbeauftragten oder Rechtsberatung. Dieser Ratgeber ersetzt keine Einzelfallprüfung.
Codex: Dateien, Werkzeuge und Cloud-Aufgaben
Ein Fehlerlog kann mehr verraten als dein Prompt. Ein Coding-Agent soll einen Test reparieren, liest die Ausgabe und findet darin versehentlich echte Kundenadressen aus einer Staging-Datenbank. Das Beispiel ist hypothetisch. Es zeigt, warum Dateizugriff und Testdaten beim Coding-Agenten dazugehören.
Ich arbeite seit Mitte 2025 mit Claude Code und habe damit über 800 Stunden programmiert. Die Frage, was ein Coding-Agent mit solchen Dateien macht, stellt sich bei jedem dieser Werkzeuge.
Codex-Datenschutz auf einen Blick
Codex verwendet je nach Anmeldung und Aufgabe unterschiedliche Datenwege. Lokale CLI-, App- und IDE-Aufgaben können ChatGPT-Anmeldung oder einen API-Key nutzen. Cloud-Aufgaben erfordern ChatGPT-Anmeldung. Ein Business- oder Enterprise-Zugriffstoken ist ein eigener Workspace-Zugang für vertrauenswürdige lokale Automationen, kein allgemeiner API-Key.
| Funktion | Persönliches Konto | Business / Enterprise | Edu | API-Key |
|---|---|---|---|---|
| Vertrag | kein Standard-DPA für Geschäftskunden | DPA, konkreten Vertrag prüfen | Student Data Privacy Agreement | DPA verfügbar, Vertrag prüfen |
| Training | Free, Plus, Pro standardmäßig an; Go-Standard offen | standardmäßig aus | standardmäßig aus | standardmäßig aus; Freigabe je Organisation |
| AufbewahrungGetrennte Daten und Funktionen | Chats und Funktionen getrennt | Workspace-Regeln und Funktion | Workspace-Regeln und Funktion | Abuse-Logs bis 30 Tage; API-Objekte je Endpoint |
| Zero Data Retention | Nein | keine allgemeine ChatGPT-Zusage | keine allgemeine ChatGPT-Zusage | nur nach Freigabe, Endpoint-Grenzen |
| Region | keine Workspace-Option | berechtigte Enterprise-Konfiguration | berechtigte Edu-Konfiguration | freigegebenes Projekt und Endpoint |
| Cloud-Aufgaben | je Tarif und Zugriff | ChatGPT-Anmeldung; Sitzberechtigung prüfen | ChatGPT-Anmeldung; Freigabe prüfen | Nein |
Seit dem 24. Juni 2026 können neue ChatGPT-Business-Pläne und Business-Workspaces, die vor diesem Datum noch nie einen Codex-Sitz hinzugefügt hatten, keine neuen Codex-Sitze hinzufügen. Workspaces mit einem zuvor hinzugefügten Sitz, einschließlich der zum Stichtag noch offenen Einladungen, können Sitze weiter verwalten und nutzungsbasierte Sitze ergänzen. Prüfe die konkrete Berechtigung anhand der Business-Hilfe.
Die Preisübersicht nennt für Business 20 $ pro Person und Monat bei Jahreszahlung. Bei Monatszahlung sind es 25 $, jeweils ab zwei Personen. Diese Preise beweisen keine Codex-Sitzberechtigung. API-Nutzung wird separat abgerechnet.
Die Tabelle ist eine Kurzorientierung. DPA, Aufbewahrung und regionale Verarbeitung setzen jeweils den passenden Vertrag, die Kontoberechtigung und unterstützte Funktionen voraus. API-Abuse-Logs, gespeicherte API-Objekte, ChatGPT-Verlauf und Codex-VM-Zustand haben unterschiedliche Fristen.
1. Welcher Codex-Tarif hat einen AVV?
Ein bezahltes Privatkonto ist nicht automatisch ein Unternehmensvertrag. Free, Go, Plus und Pro sind persönliche Tarife. Business und Enterprise nutzen das geschäftliche Services Agreement mit dem Standard-DPA, wenn die konkrete Organisation den Vertrag angenommen hat. Für Edu nennt OpenAI eine eigene Student Data Privacy Agreement.
Die Organisationsübersicht zeigt diese Produktgruppen, entscheidet aber nicht allein, welche Vereinbarung für deinen konkreten Zugang gilt:
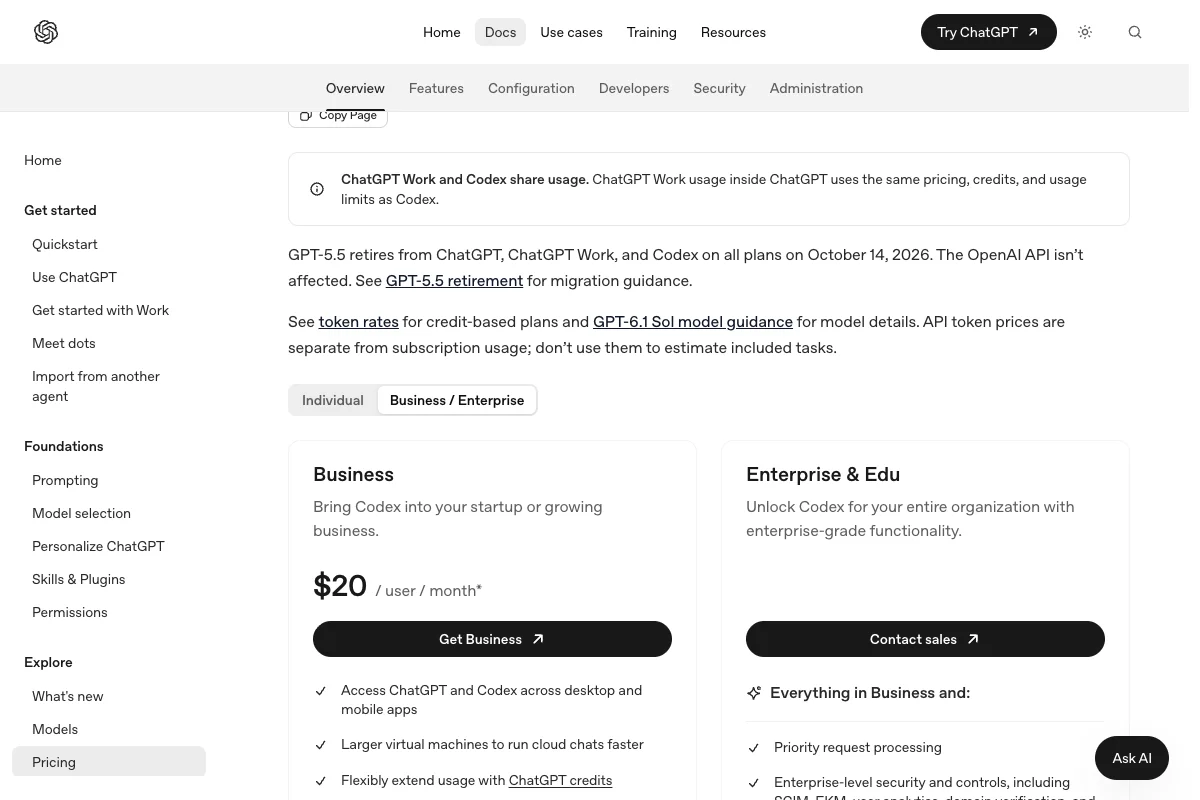
Business-, Enterprise- und Edu-Inhalte werden standardmäßig nicht zum Modelltraining genutzt. Workspace-Aufbewahrung und Datenresidenz sind eigene Funktionen mit unterschiedlichen Produkt- und Eligibility-Grenzen.
Das Data Processing Addendum ergänzt das jeweils einschlägige Services Agreement und regelt die Verarbeitung erfasster Kundendaten im Auftrag. Prüfe, welche Vereinbarung deine Organisation tatsächlich angenommen hat. Das aktuelle Standard-DPA nennt OpenAI Ireland Ltd für Kunden im EWR und in der Schweiz, sonst OpenAI OpCo, LLC. Die Edu-Student-Vereinbarung nennt OpenAI, LLC.
Eine Hochschule sollte SDPA, Order Form und mögliche institutionelle Ergänzungen gemeinsam prüfen. Eine Liste der Unterauftragsverarbeiter gehört zur jeweiligen Serviceprüfung.
Ein DPA entscheidet nicht automatisch, ob du Verantwortlicher oder Auftragsverarbeiter bist. Das richtet sich nach dem konkreten Zweck und Auftrag. Die allgemeinen Grundlagen stehen im Datenschutzratgeber zu Claude; den OpenAI-Vertrag musst du für den eigenen Zugang prüfen.
Bei einem persönlichen Konto steuerst du die freiwillige Modellverbesserung in den ChatGPT-Datenkontrollen. Für Codex-Aufgaben gibt es zusätzlich eine Einstellung für den Kontext aus Codex-Umgebungen.
Bei verwalteten oder mit Eltern beziehungsweise Sorgeberechtigten verknüpften Konten können deren Vorgaben die Änderung der Trainingseinstellung begrenzen. Die Datenkontrollen-Hilfe nennt diese zusätzlichen Grenzen.
2. Wie schaltest du Training bei Codex aus?
Bei persönlichen ChatGPT-Plänen gilt „Das Modell für alle verbessern“ auch für neue Codex-Aufgaben. Du kannst die Einstellung in ChatGPT unter Einstellungen > Datenkontrollen ausschalten oder dich über das Privacy Portal abmelden. Eine dieser Optionen genügt für neue reguläre Unterhaltungen und Codex-Aufgaben, wie OpenAI in der Codex-Datenkontrollhilfe erklärt.
„Include environments“ steuert zusätzlichen Kontext aus Codex-Umgebungen. Der allgemeine Opt-out ändert diese eigene Einstellung nicht. Wenn du auch diesen Umgebungskontext vom Training ausschließen willst, schalte beide Optionen aus. Keine davon löscht Inhalte, die bereits gespeichert wurden.
Sendest du Feedback mit Daumen hoch oder runter, kann die gesamte zugehörige Unterhaltung trotz Opt-out zur Modellverbesserung verwendet werden. Behandle diese Bewertung daher als separate Freigabe.
Business-, Enterprise- und Edu-Inhalte werden standardmäßig nicht fürs Training verwendet. Auch API-Daten werden standardmäßig nicht fürs Modelltraining genutzt. Eine API-Organisation kann Datenfreigaben ausdrücklich aktivieren, wenn diese Möglichkeit für sie verfügbar ist; die Optionen gelten nicht für jede Organisation und jeden Endpunkt.
Diese Kontrollen begrenzen die Trainingsnutzung. Sie verhindern weder die Verarbeitung zur Antworterzeugung noch jede Speicherung. Lokale Codex-Daten und serverseitige Aufbewahrung haben eigene Schalter und Regeln.
3. Was speichert Codex auf deinem Rechner?
Die Codex-CLI und die anderen lokalen Clients lesen ihre Einstellungen aus der Datei ~/.codex/config.toml. Drei Einträge darin betreffen den Datenschutz direkt. Ergänze sie, und lege vorhandene Abschnitte nicht doppelt an:
[analytics]
enabled = false

[feedback]
enabled = false

[history]
persistence = "none"
analytics schaltet Codex-Nutzungs- und Zustandsmetriken dieses Rechners aus. feedback stoppt lokale Übermittlungen über /feedback. history.persistence = "none" verhindert neue Einträge in history.jsonl, aber nicht alle Sitzungsprotokolle. Separat konfigurierte OpenTelemetry-Logs und -Traces werden davon nicht ausgeschaltet; ihr Export ist standardmäßig aus und kann Metadaten oder Auszüge aus Werkzeugergebnissen enthalten. Die Schlüssel stehen in der Konfigurationsreferenz.
Allerdings:
Die Datei steuert lokale Clients. Sie ändert keine serverseitige Aufbewahrung, löscht keine bestehenden Daten und verhindert nicht weitere lokale Sitzungsdateien. Prüfe auch deren Zugriffsschutz und Löschung. Mehr zur Konfiguration steht in meiner Übersicht der Codex-Befehle.
Bleibt das größte Risiko, nämlich dass Codex beim Arbeiten Dateien liest, die gar nicht zum Auftrag gehören.
4. Wie sperrst du .env-Dateien und alles außerhalb des Projekts?
Der Projektordner allein ist noch keine Grenze. Ohne Profil können die Befehle, die Codex ausführt, auch Dateien außerhalb lesen.
Ein Berechtigungsprofil legt fest, welche Dateien diese Befehle lesen und schreiben dürfen und ob sie ins Netz kommen. OpenAI führt die Berechtigungsprofile noch als Beta-Funktion:
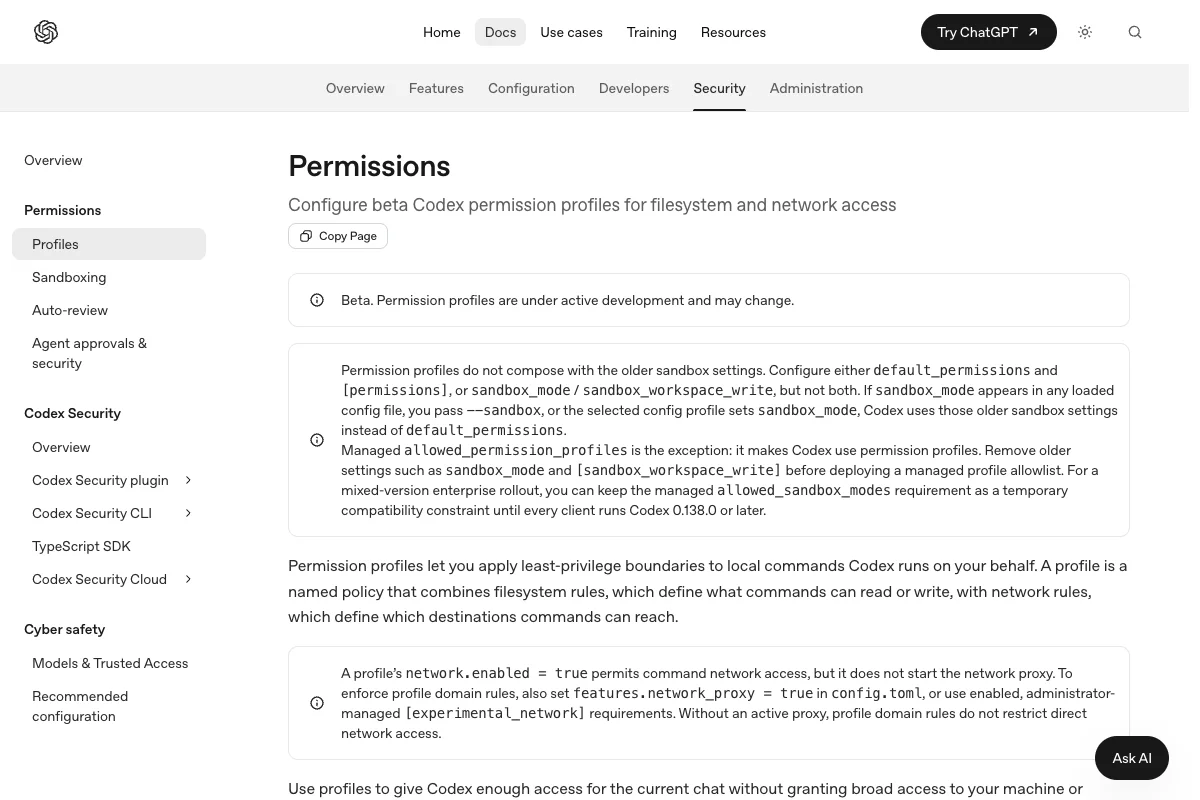
Das Profil erlaubt Arbeit in den Workspace-Ordnern und nötige Laufzeit-Lesezugriffe über :minimal. Es sperrt die übrigen Pfade, temporäre Ordner und erfasste .env-Dateien für sandboxierte Befehle. Das Befehlsnetz ist aus. Die beiden Zeilen ganz oben gehören vor alle Abschnitte in ~/.codex/config.toml.
Plattform- und Glob-Grenzen erklären die Absätze danach.
approval_policy = "on-request"
default_permissions = "projekt"

[permissions.projekt]
extends = ":workspace"

[permissions.projekt.filesystem]
glob_scan_max_depth = 3
":root" = "deny"
":minimal" = "read"
":tmpdir" = "deny"
":slash_tmp" = "deny"

[permissions.projekt.filesystem.":workspace_roots"]
"**/.env" = "deny"
"**/.env.*" = "deny"

[permissions.projekt.network]
enabled = false
Starte Codex danach ohne --sandbox.
Steht in einer geladenen Konfiguration noch sandbox_mode oder sandbox_workspace_write, nimmt Codex die alte Sandbox statt deines Profils, deshalb fliegen diese Zeilen raus. Die approval_policy on-request sorgt dafür, dass Codex fragt, bevor ein Befehl außerhalb der Sandbox läuft.
:minimal gibt Codex Lesezugriff auf die Pfade, die übliche Werkzeuge brauchen. Welche das sind, legt Codex je Plattform selbst fest. Blockiert das Profil trotzdem dein Build-Werkzeug, gibst du genau den fehlenden Pfad frei und nicht gleich den ganzen Rechner.
Auf Linux, WSL und Windows sucht Codex die .env-Dateien vor dem Start bis zur Ordnertiefe 3. Liegen deine tiefer, erhöhst du glob_scan_max_depth. Eine Datei, die erst während der Sitzung entsteht, ist bis zum nächsten Start nicht sicher gesperrt.
.env-Datei mit einem erfundenen Wert an und bitte Codex, sie anzuzeigen. Bekommst du den Wert zu sehen, greift das Profil nicht.Profile im Team zentral vorgeben
Im Team willst du dich nicht darauf verlassen, dass jeder seine config.toml richtig pflegt. Als Admin legst du die erlaubten Profile deshalb in einer requirements.toml fest, auf Mac und Linux unter /etc/codex/requirements.toml oder in Enterprise-Arbeitsbereichen über die Cloud-Verwaltung:
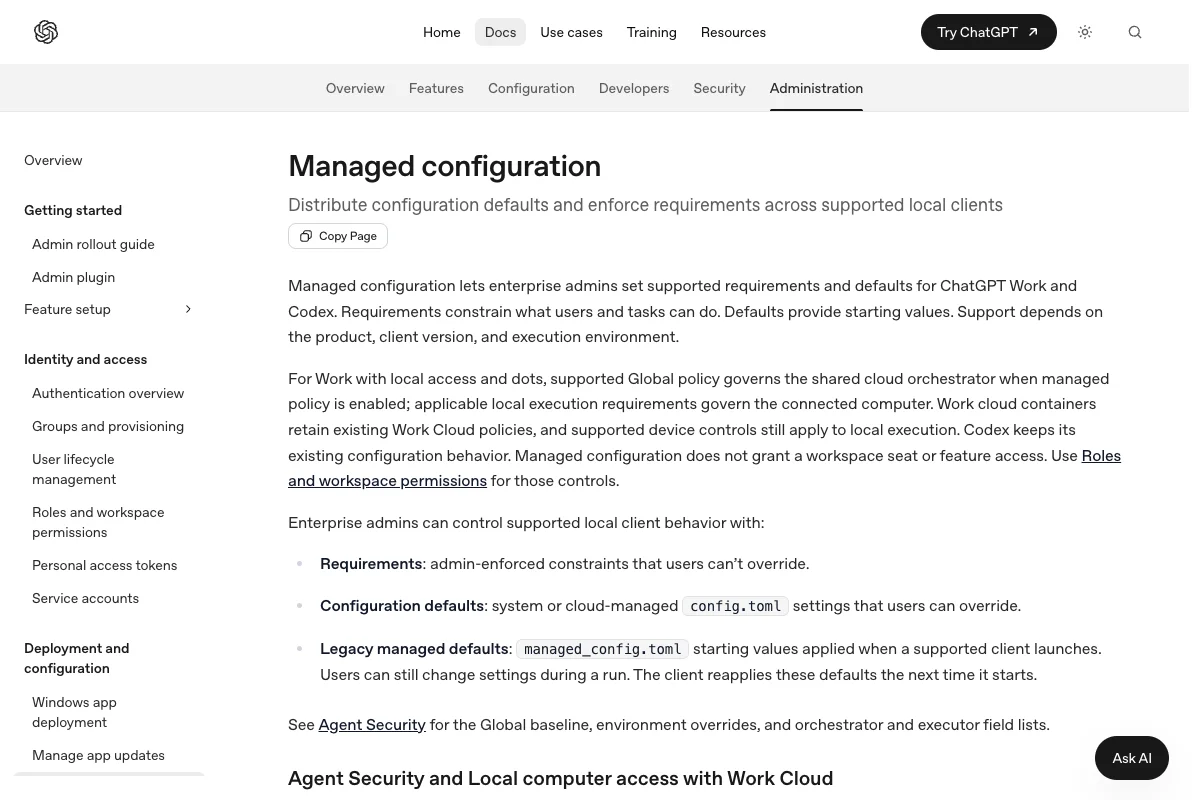
Mit allowed_permission_profiles beschränkst du auswählbare Profilnamen. Definiere auch die eigenen Profile und default_permissions in der verwalteten requirements.toml, damit ihre Grenzen zentral feststehen. Die Doku zur verwalteten Konfiguration verlangt Codex 0.138.0 oder neuer; ältere Clients dürfen diese Richtlinie nicht übernehmen. Die Einordnung zur KI-Kompetenzpflicht hilft bei der Schulung.
Das alles schützt deinen Rechner. Schickst du eine Aufgabe in die Cloud, arbeitet Codex dagegen auf OpenAIs Rechnern weiter.
5. Was landet bei einer Cloud-Aufgabe bei OpenAI?
Dort läuft Codex in einer virtuellen Maschine, auch wenn dein Laptop längst zugeklappt ist.
Die Cloud-Umgebung legt verbundene Repositories, Abhängigkeiten, Werkzeuge und Zugriffseinstellungen fest. Jede Aufgabe erhält einen eigenen isolierten Arbeitsbereich. Dein lokaler Rechner, seine Dateien, laufenden Prozesse, Browser-Anmeldungen und VPN-Verbindungen werden nicht automatisch übertragen:
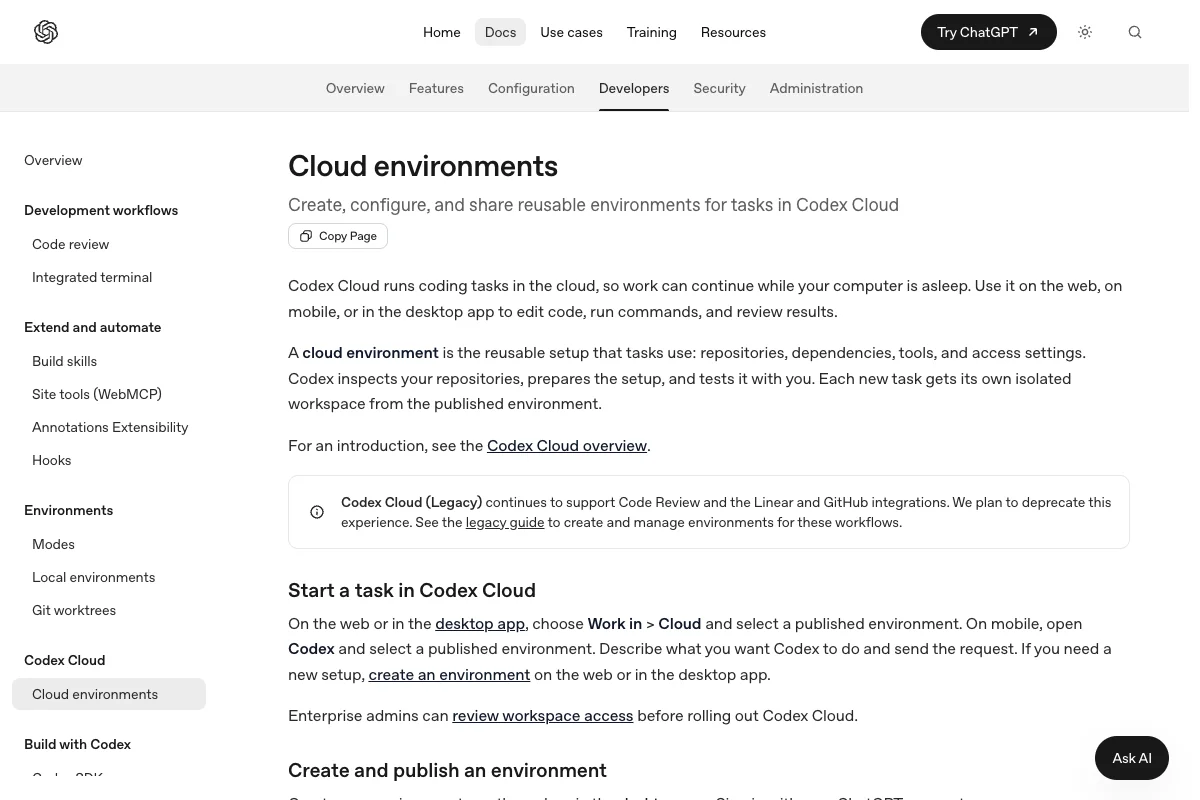
Persönliche Werte gelangen nur in eine Aufgabe, wenn die Umgebung sie ausdrücklich anfordert. Direkt gesetzte Umgebungsvariablen sind für den Task sichtbar. Netzwerk-Geheimnisse können stattdessen über einen Proxy nur für freigegebene HTTPS-Ziele eingesetzt werden. Der gespeicherte VM-Zustand ist bis zu sieben Tage nach dem letzten gestarteten Turn oder der Wiederaufnahme wiederherstellbar.
Das ist keine allgemeine Aufbewahrungs- oder Löschfrist. Angemeldete Codex-Chats bleiben im Konto, bis du sie löschst; OpenAI nennt dafür in der Aufbewahrungshilfe die endgültige Löschung normalerweise innerhalb von 30 Tagen mit den veröffentlichten Ausnahmen. API-Abuse-Logs, API-Anwendungszustand und Compliance-Logs haben eigene Regeln.
Deine lokale config.toml und Berechtigungsprofile begrenzen Cloud-Aufgaben nicht. Beschränke verbundene Repositories und konfiguriere Netzwerk sowie Workspace-Zugriff separat. Ein API-Key unterstützt keine Codex-Cloud-Aufgaben.
Nutzt dein Team auch Cursor, gilt für dessen Cloud Agents dasselbe Prinzip mit anderen Fristen. Die stehen in meiner Anleitung zum Cursor-Datenschutz.
Offen ist jetzt nur noch, in welchem Land all das passiert.
6. Kann Codex deine Daten in der EU verarbeiten?
Ja, aber nicht mit jedem Tarif. Ich sehe vier Wege, vom Enterprise-Vertrag bis zum Modell auf deinem eigenen Rechner.
Enterprise und Edu mit Datenresidenz
Berechtigte neue Enterprise- und Edu-Workspaces können Datenresidenz für unterstützte Inhalte im Ruhezustand aktivieren. Inference Residency erweitert dies für unterstützte Inhalte um GPU-Ausführung in der gewählten Region. „Europa“ umfasst hier EWR und Schweiz, also mehr als nur die EU. Business steht nicht in der aktuellen Liste für ChatGPT-Workspace-Residenz.
Laut Hilfeseite zur Datenresidenz sind Codex App und CLI als Client-Wege aufgeführt, Codex Web nicht. Lass Workspace-Region und die zusätzlich nötige Inference Residency vom Admin bestätigen. CPU-Verarbeitung, Systemdaten, Routing und externe Apps, MCP-Server oder Websuche können außerhalb der Region liegen.
API-Key mit EU-Projekt oder Azure
Für regionale Speicherung brauchst du nach Freigabe ein regionales API-Projekt und den Europe-Endpoint eu.api.openai.com. Nur unterstützte Inhalte, Modelle und Endpoints fallen darunter. Die Doku zu API-Datenkontrollen erklärt die Grenzen. Bei einem Global-Projekt kann regionale Inferenz für eine Anfrage gewählt werden; das verschiebt nicht automatisch die Speicherregion des Projekts.
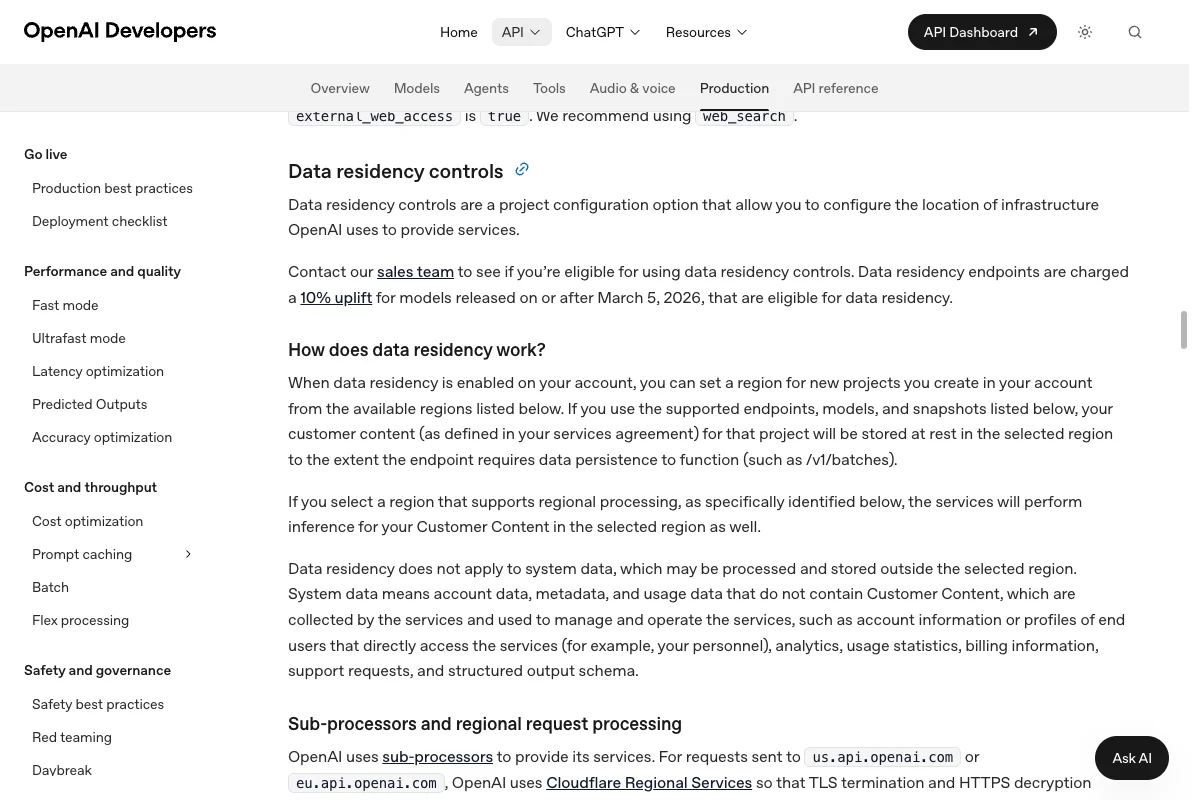
Für Nicht-US-Regionen verlangt OpenAI genehmigte Kontrollen zur Missbrauchsüberwachung und ein unterzeichnetes Modified Retention Amendment. Die Europe-URL allein genügt nicht. Systemdaten und externe Dienste fallen nicht unter die Residenzzusage. Verfügbarkeit und mögliche Zusatzbedingungen unterscheiden sich nach Modell und Endpoint und sollten vor dem Einsatz in der aktuellen Dokumentation geprüft werden.
Standardmäßig können Protokolle zur Missbrauchsüberwachung Prompts und Antworten bis zu 30 Tage enthalten, bei rechtlicher Verpflichtung auch länger. Funktionsabhängiger Anwendungsspeicher folgt eigenen Regeln. ZDR oder Modified Abuse Monitoring sind keine pauschale Löschzusage für sämtliche Funktionen.
Die lokale Codex-CLI kann Modellanfragen über die Providerkonfiguration an deinen Azure-Anbieter senden. Zeigt der Endpunkt auf deine Azure-OpenAI-Bereitstellung oder ein Foundry Model sold by Azure, verarbeitet dieser Azure-Dienst die dorthin gesendeten Anfragen. Für diese Strecke gelten die Vereinbarung, Product Terms und das DPA deines konkreten Azure-Angebots.
Das macht Microsoft nicht pauschal zum Vertragspartner für Codex-Konto, Telemetrie, Browser, Suche, MCP oder andere Tools.
Der Bereitstellungstyp entscheidet über die Modellregion. Global kann in jeder Azure-Region rechnen, Data Zone bleibt in der Microsoft-Datenzone und Standard beziehungsweise Regional Provisioned in der gewählten Geografie. Bei Global und Data Zone bleibt gespeicherter Inhalt in der ausgewählten Azure-Geografie. Microsoft beschreibt im Datenschutzhinweis und im Überblick zur Missbrauchsüberwachung gespeicherte, markierte Prompts und Antworten für menschliche Missbrauchsprüfung.
Diese Seiten nennen keine allgemeine Speicherfrist. Übertrage OpenAIs API-Angabe von 30 Tagen deshalb nicht auf Azure.
Lokal mit Ollama
Nur die Inferenz eines ausgewählten lokalen Modells läuft auf deinem Rechner. Ollama bringt eine eigene Codex-Integration mit, über die du lokale oder Cloud-Modelle einrichten kannst:
ollama launch codexWähle ausdrücklich ein lokales Modell. Die Modellliste kann auch Cloud-Modelle enthalten, und selbst --oss beweist allein keine lokale Inferenz. Ollamas Websuche läuft über einen eigenen Online-Dienst. Du kannst sie für das Codex-Profil ausschalten:
codex --profile ollama-launch -c 'web_search="disabled"'Ollamas Cloud-Modelle und Ollama-Websuche schaltest du laut Ollama-FAQ mit OLLAMA_NO_CLOUD=1 beim Serverstart oder mit "disable_ollama_cloud": true in ~/.ollama/server.json aus. Starte Ollama danach neu. Diese Einstellung schaltet nicht Codex-Telemetrie, andere MCP-Server oder separat konfigurierte Werkzeuge aus. [analytics].enabled = false deaktiviert Codex-Nutzungsmetriken auf diesem Rechner; OpenTelemetry bleibt ein eigener, standardmäßig ausgeschalteter Exportweg.
Wie schlägt sich Codex damit gegen die beiden anderen großen Coding-Agenten?
Claude Code, Codex und Cursor im Vergleich
Zu allen drei Werkzeugen gibt es hier eine eigene Datenschutz-Anleitung. Die wichtigsten Werte nebeneinander:
| Funktion | Claude Code | Codex | Cursor |
|---|---|---|---|
| AVV / DPA ab Zugang | Team, Enterprise, API | Business, Enterprise, API | Teams, Enterprise |
| Kein Training im FirmentarifAusnahmen möglich | standardmäßig | standardmäßig | mit Privacy Mode |
| Kein Training im Einzeltarif | nach Opt-out | nach Opt-out | mit Privacy Mode |
| AufbewahrungJe Datenart und Funktion | Code-/API-Regeln separat | API-Logs bis 30 Tage; VM bis 7 Tage | Editor und Cloud getrennt |
| Europäische OptionenBegrenzter Umfang | z. B. AWS oder Google | berechtigte Enterprise-, Edu-, API-Konfiguration | Inferenz auf Anfrage |
| Wichtigster Schalter | Help improve our AI models | Improve the model for everyone | Privacy Mode |
Für Edu nennt OpenAI eine eigene Student Data Privacy Agreement. Prüfe die Vereinbarung deiner Institution samt Order Form und Ergänzungen. Die Speicherwerte in der Tabelle gelten nur für die benannte Datenart, mit Sicherheits- und Rechtsausnahmen; gespeicherte Chats haben einen eigenen Löschweg.
OpenAI bietet berechtigten Enterprise- und Edu-Kunden sowie freigeschalteten API-Kunden regionale Optionen mit unterschiedlichem Umfang. Sie erfassen nicht alle Verarbeitungsschritte. Cursor bietet auf Anfrage regionale Modellinferenz. Mehr steht in den Datenschutzgrundlagen zu Claude und im Cursor-Datenschutzratgeber.
Beim Vergleich der Coding-Werkzeuge hilft mein Vergleich von Claude Code und Codex.
Prüfe die Codex-Dateigrenzen
Für personenbezogene Daten, die du im Auftrag verarbeiten lässt, prüfst du zuerst den für deinen Zugang angenommenen Vertrag. Business und Enterprise nutzen das Standard-DPA, Edu verweist auf eine Student Data Privacy Agreement, und für die API steht ein DPA zur Verfügung. Ein Trainings-Opt-out im Privatkonto ersetzt keine passende Vereinbarung.
Prüfe Einstellungen nach Client-Updates und bei Änderungen an Modellen, Funktionen oder Organisationsvorgaben erneut. Den Dateizugriff kannst du zunächst mit erfundenen Daten testen.
Leg ein leeres Testprojekt mit einer erfundenen .env-Datei an und trage das Profil aus Schritt 4 ein. Eine abgelehnte Leseanfrage bestätigt nur die Sperre für diesen getesteten Zugriff, keine vollständige Schutzwirkung. Verweigere dabei Freigaben außerhalb der Sandbox. Prüfe außerdem:
- mit welchem Konto und welchem Profil Codex gerade läuft,
- ob ein Befehl außerhalb des Projektordners scheitert,
- ob ein Netzwerkaufruf aus dem Terminal blockiert wird,
- ob nach der Sitzung eine
history.jsonlentstanden ist.
Was du freigibst, dokumentierst du am besten in einer KI-Richtlinie für dein Unternehmen. Die konkrete DSGVO-Bewertung hängt von Zweck, Daten, Rollen und Vertrag ab. Bei einer Rechtsentscheidung beziehst du Datenschutzbeauftragte oder Rechtsberatung ein.
Dein nächster Schritt
Finde zuerst heraus, ob die konkrete Eingabe über ein persönliches Konto, einen verwalteten Workspace, die API oder Codex läuft. Prüfe danach das jeweilige Objekt. Ein Chat, eine Erinnerung, eine Library-Datei, eine verbundene App und ein API-Response verschwinden nicht alle über dieselbe Schaltfläche.
Für vertrauliche Inhalte zählt der ganze Ablauf, nicht nur eine Trainingsoption. Prüfe den Empfänger, die Admin- und App-Rechte, den angenommenen Vertrag und die passende Löschregel. Teste Dateigrenzen mit erfundenen Daten. Übertrage nicht versehentlich echte Kundendaten in einen Testprompt.
Wähle nur die Funktion, die du für deinen Zweck wirklich brauchst.
Ob dein konkreter Einsatz die DSGVO erfüllt, kann keine einzelne Produkteinstellung beantworten. Wenn du dafür eine verbindliche Entscheidung brauchst, beziehe deine Datenschutzbeauftragten oder Rechtsberatung ein.