Open-Source-LLMs sind einer der wichtigsten KI-Trends 2026.
Und das nicht zu Unrecht:
Open-Source-Modelle waren lange Zeit deutlich schwächer als proprietäre Modelle. Bis zum Herbst 2026 haben sie aber fast vollständig aufgeholt, vor allem dank chinesischer Labs:
DeepSeek V4 Pro, GLM-5.3 von Z.ai und Kimi K3 von Moonshot AI liegen auf SWE-bench Verified nur noch wenige Punkte hinter Claude Opus 5, dem stärksten Modell in der unabhängigen Messung von Vals AI. Das kleine Qwen3.8 27B schlägt dort sogar GPT-5.5.
In diesem Artikel findest du ein sortier- und filterbares Verzeichnis mit 211 Open-Source-LLMs, inklusive Benchmark-Scores, Lizenzen, API-Preisen, Kontextfenstern und Capabilities.
Wenn du auch proprietäre Spitzenmodelle einbeziehen möchtest, findest du im LLM-Vergleich 55 aktuelle Modelle mit gemeinsamen Benchmarks, Preisen und direkten Duellen.
Mit dem Hardware-Check findest du außerdem heraus, welche dieser Modelle auf deinem PC oder Mac laufen und wie schnell sie dort antworten.
Zudem zeige ich dir, wie du freie LLMs einfach und kostenlos auf deinem Rechner nutzen kannst (ohne programmieren oder das Terminal nutzen zu müssen).
- DeepSeek V4 Pro 0813, GLM-5.3 und Kimi K3 liegen auf SWE-bench Verified weniger als 4 Punkte hinter Claude Opus 5, gemessen von Vals AI
- Das beste kleine Modell ist Qwen3.8 27B unter Apache 2.0. Es passt auf eine 24-GB-Grafikkarte und schlägt auf SWE-bench Verified sogar GPT-5.5
- 211 Open-Source-LLMs im filter- und sortierbaren Verzeichnis, von MIT und Apache 2.0 bis zu eingeschränkten Research-Lizenzen. Spalten wie Preise, Kontext und Capabilities lassen sich einzeln ein- und ausblenden
- Lies die Lizenzen genau. GLM-5.3, Kimi K3 und MiniMax M3 haben eigene Lizenzen mit Auflagen, MiniMax M2.7 ist nur nicht-kommerziell nutzbar
- Lokale Nutzung mit Tools wie Ollama, LM Studio oder GPT4All möglich, die neuen Top-Modelle brauchen aber ernsthafte Hardware. Der Hardware-Check zeigt dir, welche Modelle auf deinem PC oder Mac laufen und wie viele Token pro Sekunde du erwarten kannst
Alle Open-Source-LLMs im Überblick
Das Verzeichnis enthält alle Open-Weights-Modelle aus dem models.dev-Katalog plus kuratierte Klassiker, standardmäßig sortiert nach Release-Datum. Über „Spalten“ blendest du weitere Daten ein, etwa Modalitäten, Wissensstand, Max. Output oder die Zahl der API-Anbieter:
50 von 211 Treffern angezeigt (211 Modelle insgesamt)
136 von 211 Modellen mit Benchmarkwert. Die Werte stammen aus unterschiedlichen Tests und Testbedingungen. Werte in derselben Spalte sind deshalb nicht direkt vergleichbar und nicht gemeinsam sortierbar.
| Wissen | Mathe / Naturwissenschaften | Code | ||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Xiaomi | 309B (15B aktiv) | 1M | – | – | 28,8 %Terminal-Bench | MIT | 0,14 $ | 0,28 $ | Sept. 2026 | |||
| Xiaomi | 1T (42B aktiv) | 1M | – | – | 34,9 %Terminal-Bench | MIT | 0,44 $ | 0,87 $ | Sept. 2026 | |||
| Xiaomi | 1T (42B aktiv) | 1M | – | – | – | MIT | 4,35 $ | 8,70 $ | Sept. 2026 | |||
| DeepSeek | 552B (16B aktiv) | 1M | – | – | 90,6 %Terminal-Bench | MIT | 0,13 $ | 0,28 $ | Sept. 2026 | |||
| OpenBMB | 2B | 128K | – | – | – | Apache 2.0 | 0,12 $ | 0,74 $ | Sept. 2026 | |||
| Tencent | 770B (49B aktiv) | 1M | – | – | – | Apache 2.0 | 0,67 $ | 2,00 $ | Aug. 2026 | |||
| Alibaba | 125B (6B aktiv) | 256K | – | – | 62,5 %SWE-Bench Pro | Qwen Community License 1.0 | 0,15 $ | 0,47 $ | Aug. 2026 | |||
| Z.ai | 320B (18B aktiv) | 1M | – | – | 63,4 %DeepSWE | MIT | 0,015 $ | 0,025 $ | Aug. 2026 | |||
| DeepSeek | 305B | 1M | – | – | 83,9 %Terminal-Bench | MIT | 0,080 $ | 0,20 $ | Aug. 2026 | |||
| DeepReinforce | 35B (3B aktiv) | 256K | – | – | – | MIT | 0,10 $ | 0,40 $ | Aug. 2026 | |||
| Alibaba | 27B | 256K | – | – | 61,7 %SWE-bench Pro | Apache 2.0 | 0,080 $ | 0,35 $ | Aug. 2026 | |||
| Z.ai | 753B | 1M | – | – | 88,2 %Terminal-Bench | GLM-5.3 License | 0,38 $ | 1,19 $ | Aug. 2026 | |||
| Alibaba | 2,4T (95B aktiv) | 256K | – | – | – | Qwen3.8-Max License | 1,95 $ | 5,95 $ | Aug. 2026 | |||
| DeepSeek | 1,6T (49B aktiv) | 1M | – | – | 87,9 %Terminal-Bench | MIT | 0,26 $ | 0,79 $ | Aug. 2026 | |||
Nemotron 3.5 Lightning 30B A3B | NVIDIA | 30B (3B aktiv) | 256K | – | – | 51,6 %SWE-Bench Verified | NVIDIA Open Model License | 0,050 $ | 0,15 $ | Aug. 2026 | ||
| Meta | 30B | 128K | – | – | 76 %SWE-Bench Verified | Apache 2.0 | 0,20 $ | 0,80 $ | Aug. 2026 | |||
| Motif Technologies | 314B (13,2B aktiv) | 256K | – | – | – | MIT | 0,50 $ | 2,00 $ | Aug. 2026 | |||
| DeepSeek | 284B (13B aktiv) | 1M | – | – | 82,7 %Terminal-Bench | MIT | 0,021 $ | 0,070 $ | Juli 2026 | |||
| Thinking Machines Lab | 276B (12B aktiv) | 1M | – | – | – | Apache 2.0 | 0,45 $ | 1,20 $ | Juli 2026 | |||
| Poolside | 118B (8B aktiv) | 1M | – | – | – | OpenMDW-1.1 | 0,090 $ | 0,18 $ | Juli 2026 | |||
| Moonshot AI | 2,8T (104B aktiv) | 1M | – | – | 88,3 %Terminal-Bench | Kimi K3 License | 2,00 $ | 8,00 $ | Juli 2026 | |||
| Thinking Machines Lab | 975B (41B aktiv) | 1M | – | – | – | Apache 2.0 | 0,95 $ | 4,05 $ | Juli 2026 | |||
| Tencent | 295B (21B aktiv) | 250K | – | – | 78 %SWE-Bench Verified | Apache 2.0 | 0,066 $ | 0,26 $ | Juli 2026 | |||
| Poolside | 33B (3B aktiv) | 256K | – | – | 70,9 %SWE-Bench Verified | OpenMDW-1.1 | 0,060 $ | 0,12 $ | Juli 2026 | |||
Ornith 1.0 31B | DeepReinforce | 31B | 256K | – | – | – | MIT | – | – | Juni 2026 | ||
| DeepReinforce | 35B | 256K | – | – | 75,6 %SWE-Bench Verified | MIT | – | – | Juni 2026 | |||
| DeepReinforce | 397B | 256K | – | – | 82,4 %SWE-Bench Verified | MIT | – | – | Juni 2026 | |||
| DeepReinforce | 9B | 256K | – | – | 69,4 %SWE-Bench Verified | MIT | – | – | Juni 2026 | |||
| Z.ai | 753B | 1M | – | 91,2 %GPQA | 62,1 %SWE-Bench Pro | MIT | 0,30 $ | 1,05 $ | Juni 2026 | |||
| Moonshot AI | 1T (32B aktiv) | 256K | – | 89,6 %GPQA | 67,4 %Terminal-Bench | Modified MIT | 0,28 $ | 1,10 $ | Juni 2026 | |||
| Moonshot AI | 1T (32B aktiv) | 256K | – | 89,6 %GPQA | 67,4 %Terminal-Bench | Modified MIT | 1,90 $ | 8,00 $ | Juni 2026 | |||
| Cohere | 30B (3B aktiv) | 250K | – | – | 61 %SWE-Bench Verified | Apache 2.0 | – | – | Juni 2026 | |||
| 12B | 256K | – | – | – | Apache 2.0 | 0,050 $ | 0,25 $ | Juni 2026 | ||||
| Xiaomi | 1T (42B aktiv) | 1M | – | – | – | MIT | 1,31 $ | 2,61 $ | Juni 2026 | |||
Nemotron 3 Ultra 550B A55B | NVIDIA | 550B (55B aktiv) | 1M | 86,8 %MMLU-Pro | 87 %GPQA | 89 %LiveCodeBench | OpenMDW-1.1 | 0,10 $ | 0,10 $ | Juni 2026 | ||
| Nex AGI | 397B (17B aktiv) | 256K | – | – | – | Apache 2.0 | 0,50 $ | 2,50 $ | Juni 2026 | |||
| MiniMax | 428B (23B aktiv) | 1M | – | 92,9 %GPQA | 80,5 %SWE-Bench Verified | MiniMax Community License | 0,23 $ | 0,90 $ | Juni 2026 | |||
| StepFun | 198B (11B aktiv) | 250K | – | – | 76,5 %SWE-Bench Verified | Apache 2.0 | 0,19 $ | 1,11 $ | Mai 2026 | |||
Command A Plus | Cohere | 218B (25B aktiv) | 125K | – | – | – | CC BY-NC-4.0 | 0,30 $ | 1,50 $ | Mai 2026 | ||
| OpenBMB | 1B | 128K | – | – | – | Apache 2.0 | – | – | Mai 2026 | |||
| Mistral AI | 128B | 256K | – | – | 77,6 %SWE-Bench Verified | Modified MIT (Mistral) | 1,50 $ | 6,90 $ | Apr. 2026 | |||
Nemotron 3 Nano Omni 30B A3B Reasoning | NVIDIA | 30B (3B aktiv) | 250K | 77,3 %MMLU-Pro | 72,2 %GPQA | 63,2 %LiveCodeBench | NVIDIA Open Model License | 0,20 $ | 0,80 $ | Apr. 2026 | ||
| Poolside | 225B (23B aktiv) | 256K | – | – | 74,6 %SWE-Bench Verified | Apache 2.0 | – | – | Apr. 2026 | |||
| Poolside | 33B (3B aktiv) | 256K | – | – | 69,9 %SWE-Bench Verified | Apache 2.0 | – | – | Apr. 2026 | |||
| DeepSeek | 284B (13B aktiv) | 1M | 83 %MMLU-Pro | 85 %GPQA | 88 %LiveCodeBench | MIT | 0,035 $ | 0,070 $ | Apr. 2026 | |||
| DeepSeek | 1,6T (49B aktiv) | 1M | 87,5 %MMLU-Pro | 90,1 %GPQA | 93,5 %LiveCodeBench | MIT | 0,35 $ | 0,70 $ | Apr. 2026 | |||
DeepSeek V4 Pro 0423 | DeepSeek | 1,6T (49B aktiv) | 1M | – | – | – | MIT | 1,32 $ | 3,30 $ | Apr. 2026 | ||
| Alibaba | 27B | 256K | 86,2 %MMLU-Pro | 87,8 %GPQA | 77,2 %SWE-Bench Verified | Apache 2.0 | 0,20 $ | 0,60 $ | Apr. 2026 | |||
| Xiaomi | 310B (15B aktiv) | 1M | 86,3 %MMLU | – | 56,1 %SWE-Bench Pro | MIT | 0,14 $ | 0,28 $ | Apr. 2026 | |||
| Xiaomi | 1T (42B aktiv) | 1M | 89,4 %MMLU | – | 78,9 %SWE-Bench Verified | MIT | 0,40 $ | 0,80 $ | Apr. 2026 |
1. Die wichtigsten Benchmarks erklärt
Ein einzelner Score sagt wenig über ein Modell. Deshalb zeigt das Verzeichnis pro Modell bis zu drei Werte, je einen für Wissen, Mathe und Naturwissenschaften sowie Code.
Welcher Benchmark hinter einem Wert steckt, verrät das kleine Label unter dem Wert. Diese neun Benchmarks tauchen dort am häufigsten auf:
Einige ältere Tests sind inzwischen fast ausgereizt. Bei HumanEval erreicht Kimi K2.5 zum Beispiel 99 %. Aussagekräftiger sind deshalb die schweren Benchmarks wie GPQA Diamond, LiveCodeBench und SWE-bench Verified. Fehlt für ein Modell ein Wert, steht im Verzeichnis „–“.
So nah sind offene Modelle an der Spitze
Auf SWE-bench Verified ist der Abstand zu den proprietären Spitzenmodellen fast verschwunden. GLM-5.3 kommt bei Vals AI auf 95,4 % und liegt damit knapp vor Claude Fable 5. Nur Claude Opus 5, GPT-5.6 Sol und Grok 4.6 schneiden noch besser ab:
Offene und proprietäre Modelle auf SWE-bench Verified
 gradually.ai
Noch enger wird es bei der fertigen Version von DeepSeek V4 Pro. Die Fassung 0813 erreicht in derselben Messung 96,4 % und liegt nur 0,6 Punkte hinter Claude Opus 5. Im Chart fehlt sie, weil sie noch kein eigenes Modellprofil hat.
Beim Preis ist das Bild gemischter, als man denkt. GLM-5.3-Flash schafft 92 % für 0,15 $ pro Million Input-Token. OpenAIs GPT-5.6 Luna liegt mit 93 % für 0,20 $ aber fast gleichauf:


 gradually.ai
Der eigentliche Vorteil offener Modelle liegt ohnehin woanders. Du kannst sie selbst hosten, anpassen und bei jedem beliebigen Anbieter betreiben, statt an eine einzige API gebunden zu sein.
2. Die besten Open-Source-LLMs 2026
Seit Juli hat sich die Spitze komplett neu sortiert. Kimi K3, GLM-5.3 und die fertige Version von DeepSeek V4 Pro haben die Modelle aus dem Frühjahr deutlich überholt.
Die sechs wichtigsten offenen Modelle im Überblick:
| Funktion | DeepSeek V4 Pro 0813 | GLM-5.3 | Kimi K3 | GLM-5.3-Flash | MiMo-V2.6-Pro | Qwen3.8 27B |
|---|---|---|---|---|---|---|
| Entwickler | DeepSeek | Z.ai | Moonshot AI | Z.ai | Xiaomi | Alibaba |
| Erschienen | Aug. 2026 | Aug. 2026 | Juli 2026 | Aug. 2026 | Sept. 2026 | Aug. 2026 |
| LizenzAuflagen im Lizenztext prüfen | MIT | GLM-5.3 License | Kimi K3 License | MIT | MIT | Apache 2.0 |
| Parametergesamt (davon aktiv pro Token) | 1,6T (49B) | 753B | 2,8T (104B) | 320B (18B) | 1,02T (42B) | 27B |
| Kontextfenster | 1M | 1M | 1M | 1M | 1M | 262K (bis 1M) |
| Eingabe | Text | Text | Text, Bild, Video | Text, Bild, Video | Text, Bild, Video, Audio | Text, Bild, Video |
| SWE-bench Verifiedunabhängig gemessen von Vals AI | 96,4 % | 95,4 % | 93,4 % | 92,0 % | noch kein Wert | 86,0 % |
| Stärke | Agentisches Coding | Software-Engineering | Coding, Agenten, Vision | Multimodal und günstig | Omnimodal, Agenten | Passt auf 24-GB-GPU |
DeepSeek V4 Pro 0813
Mitte August hat DeepSeek die Vorschau von V4 Pro durch die fertige Version 0813 ersetzt. Die Architektur bleibt gleich, deutlich besser geworden sind laut DeepSeek vor allem die Agenten-Fähigkeiten im Produktiveinsatz.
Mit 96,4 % auf SWE-bench Verified ist es das stärkste offene Modell in der Messung von Vals AI. Dazu kommt die MIT-Lizenz ohne Zusatzauflagen.
GLM-5.3
Z.ai richtet GLM-5.3 auf Software-Engineering und lange Agenten-Aufgaben aus. Das Kontextfenster umfasst 1 Million Token, eine Antwort darf bis zu 128.000 Token lang werden.
Bei der Lizenz gibt es eine Änderung. Anders als GLM-5.2 und GLM-5.3-Flash steht GLM-5.3 nicht mehr unter MIT, sondern unter der eigenen GLM-5.3 License. Sie verlangt eine Sicherheitsprüfung durch Z.AI, wenn der Lizenznehmer oder eines seiner verbundenen Unternehmen ein Model-as-a-Service-Geschäft betreibt und der Gesamtumsatz des Lizenznehmers und seiner verbundenen Unternehmen in einem beliebigen Zeitraum von zwölf aufeinanderfolgenden Monaten 10 Milliarden US-Dollar oder den Gegenwert in anderen Währungen übersteigt. Der Lizenznehmer muss die Prüfung vor einer kommerziellen Nutzung der Software oder ihrer Ableitungen bestehen.
Kimi K3
Mit 2,8 Billionen Parametern ist Kimi K3 das größte Modell im Verzeichnis. Pro Token arbeiten davon 104 Milliarden, dazu kommt ein Vision-Encoder für Bilder und Videos.
Moonshot bleibt dabei erstaunlich zurückhaltend. Laut eigenem Blog liegt K3 noch hinter Claude Fable 5 und GPT-5.6 Sol, und die Vals-Messung bestätigt das mit 93,4 % knapp.
Die Kimi K3 License erlaubt kommerzielle Nutzung, knüpft sie für große Anbieter aber an Bedingungen. Model-as-a-Service-Anbieter und ihre verbundenen Unternehmen mit mehr als 20 Millionen US-Dollar Gesamtumsatz innerhalb von zwölf aufeinanderfolgenden Monaten brauchen vor jeder kommerziellen Nutzung der Software oder ihrer Ableitungen eine separate Vereinbarung mit Moonshot AI. Produkte oder Dienste mit mehr als 100 Millionen monatlich aktiven Nutzern oder über 20 Millionen US-Dollar Monatsumsatz müssen „Kimi K3“ prominent in der Benutzeroberfläche nennen. Beide Sonderbedingungen gelten laut Lizenz nicht für die interne Nutzung und nicht für die Nutzung über offizielle Moonshot-Produkte oder zertifizierte Inferenzpartner.
GLM-5.3-Flash
GLM-5.3-Flash ist das erste nativ multimodale Modell der GLM-5-Reihe und versteht neben Text auch Bilder und Videos. Mit 18 Milliarden aktiven Parametern arbeitet es deutlich sparsamer als GLM-5.3.
Auf SWE-bench Verified kommt es trotzdem auf 92 %. Die API kostet 0,15 $ pro Million Input-Token, und die Gewichte stehen unter der klassischen MIT-Lizenz.
MiMo-V2.6-Pro
Xiaomi hat MiMo-V2.6-Pro am 22. September vorgestellt, damit ist es das jüngste Modell der Auswahl. Es verarbeitet Text, Bilder, Videos und Audio in einem einzigen Modell und steht unter MIT-Lizenz.
Unabhängige Messungen gibt es noch nicht. Xiaomi selbst meldet 89,9 auf Terminal-Bench 2.1, allerdings mit eigenem Testaufbau.
Qwen3.8 27B
Das beste kleine Modell kommt von Alibaba. Qwen3.8 27B ist ein klassisches dichtes Modell mit 27 Milliarden Parametern und schafft auf SWE-bench Verified 86 %. Damit liegt es vor GPT-5.5 und Gemini 3.1 Pro.
In der Quantisierung Q5_K_M passt es auf eine Grafikkarte mit 24 GB, etwa eine RTX 4090. Wie schnell es dort antwortet, zeigt dir der Hardware-Check in Kapitel 4. Die Lizenz ist Apache 2.0.
Weitere starke Modelle
Diese Modelle lohnen ebenfalls einen Blick:
- DeepSeek V4.1 Flash (September, MIT): multimodales MoE mit 552 Milliarden Parametern, von denen beim Generieren 16 Milliarden aktiv sind. DeepSeek nennt es das kleinste Modell seiner neuen Architektur.
- Qwen3.8 2.4T-A95B (August, Qwen3.8-Max License): die offene Version von Alibabas Flaggschiff Qwen3.8-Max. Es versteht nur Text und arbeitet immer im Thinking-Modus.
- Tencent Hy4 preview (August, Apache 2.0): 770 Milliarden Parameter, davon 49 Milliarden aktiv, mit Fokus auf Software-Engineering und Büroarbeit.
- Inkling und Inkling Small (Juli, Apache 2.0): zwei multimodale Modelle von Thinking Machines Lab. Inkling Small schafft mit nur 12 Milliarden aktiven Parametern 82,2 % auf SWE-bench Verified.
- Qwen 3.8 Flash Next (August, Qwen Community License 1.0): die Architektur-Vorschau auf Qwen4 mit nur 6 Milliarden aktiven Parametern. Über QwenCloud läuft das Modell unter dem Namen „qwen3.8-flash“.
- MiniMax M3 (Juni, MiniMax Community License): multimodal mit 1 Million Token Kontext. Bei kommerzieller Nutzung verlangt die Lizenz den Hinweis „Built with MiniMax M3“.
- Nemotron 3 Ultra (Juni, OpenMDW 1.1): das größte Nemotron-Modell von NVIDIA mit 550 Milliarden Parametern, gebaut für lange Agenten-Läufe.
- Gemma 4 12B (Juni, Apache 2.0): Googles Modell für lokale Agenten. Laut Google läuft es auf Laptops mit 16 GB Grafik- oder Arbeitsspeicher.
Die Modelle aus dem Frühjahr wie DeepSeek V4 Pro (April), Kimi K2.6 und GPT-OSS-120B bleiben nutzbar, liegen aber klar hinter der neuen Spitze.
3. LLM-Lizenzen erklärt
Hier findest du einen Überblick über die am häufigsten verwendeten Lizenzen bei Open-Source-LLMs.
MIT License
Eine sehr freizügige Open-Source-Lizenz, ähnlich wie Apache 2.0. Sie erlaubt die uneingeschränkte Nutzung, Modifikation und Weitergabe des LLMs, auch in proprietären Programmen, solange der Urheberrechtshinweis erhalten bleibt. DeepSeek V3 verwendet MIT mit einigen Einschränkungen für militärische Nutzung.
Llama 2 Community / Llama 3 Community
Unter den Lizenzen hat Meta Llama 2 und Llama 3 veröffentlicht. Sie erlauben die kostenlose Nutzung der LLMs für Forschung und kommerzielle Anwendungen mit bis zu 700 Millionen monatlich aktiven Nutzern. Der Quellcode und die Modellgewichte sind frei verfügbar.
Qwen License / Qianwen LICENSE
Die Qwen-Modelle werden unter verschiedenen Lizenzen veröffentlicht. Während kleinere Modelle oft unter Apache 2.0 lizenziert sind, haben größere Modelle wie Qwen2.5-72B spezielle Lizenzbedingungen, die kommerzielle Nutzung mit bestimmten Einschränkungen erlauben.
Apache 2.0
Eine sehr freizügige Open-Source-Lizenz, die nur minimale Beschränkungen vorsieht. Sie erlaubt die Nutzung, Modifikation und Weitergabe des LLMs, auch in proprietären Programmen, solange der Urheberrechtshinweis erhalten bleibt. Sie enthält keine Copyleft-Klausel.
CC BY-NC-4.0
Eine Creative-Commons-Lizenz, die es erlaubt, das LLM in jeglicher Form zu bearbeiten und zu teilen, jedoch nicht für kommerzielle Zwecke. Der Name des Urhebers muss genannt werden.
CC BY-NC-SA-4.0
Ähnlich wie CC BY-NC-4.0, jedoch mit der zusätzlichen Share-Alike-Bedingung. Das bedeutet, Forks oder bearbeitete Versionen eines LLMs müssen unter den gleichen Bedingungen weitergegeben werden.
nicht-kommerziell
Hier ist die Nutzung des LLMs für kommerzielle Zwecke untersagt. Was genau als „kommerziell“ gilt, ist aber nicht immer eindeutig definiert oder eingegrenzt.
Meistens sind „nicht-kommerzielle“ Modelle nur für Forschungszwecke oder zur privaten Nutzung freigegeben.
4. Welche Open-Source-LLMs laufen auf deinem Rechner?
Das stärkste Open-Source-LLM bringt dir nichts, wenn es nicht auf deinen Rechner passt.
Und genau hier liegt bei lokalen Modellen der Knackpunkt. Ein Modell muss komplett in den Speicher deiner Grafikkarte oder deines Macs passen. Sonst startet es gar nicht oder läuft im Schneckentempo.
Mit dem folgenden Hardware-Check findest du in wenigen Sekunden heraus, welche Modelle aus dem Verzeichnis auf deiner Hardware laufen. Du wählst Gerät, Einsatzzweck und Kontextlänge und bekommst für jedes Modell die passende Quantisierung, den Speicherbedarf, das geschätzte Tempo und einen Empfehlungswert:
Nutzbar für Modelle: 11,2 GB schneller Speicher mit 504 GB/s, dazu 24 GB Arbeitsspeicher zum Auslagern.
109 von 198 Modellen laufen auf diesem Rechner, 44 davon passen zu deinen Filtern.
Modell | Passung und Speicher | Quantisierung | Tempo | Wert |
|---|---|---|---|---|
| Passt8,2 GB · 73 % belegt | Q6_K | 54 Token/sFlüssig | 90 | |
| Passt22,1 GB · 63 % belegtteils im RAM | Q4_K_M | 27 Token/sGut nutzbar | 90 | |
| Passt8,2 GB · 73 % belegt | Q6_K | 54 Token/sFlüssig | 89 | |
| Passt22,1 GB · 63 % belegtteils im RAM | Q4_K_M | 27 Token/sGut nutzbar | 89 | |
| Passt22,1 GB · 63 % belegtteils im RAM | Q4_K_M | 27 Token/sGut nutzbar | 89 | |
| Passt8,3 GB · 74 % belegt | Q4_K_M | 53 Token/sFlüssig | 89 | |
| Passt21,1 GB · 60 % belegtteils im RAM | Q4_K_M | 27 Token/sGut nutzbar | 89 | |
| Passt16,8 GB · 48 % belegtteils im RAM | Q4_K_M | 26 Token/sGut nutzbar | 89 | |
Nemotron 3.5 Lightning 30B A3BNVIDIA · 30B (3B aktiv) | Passt21 GB · 60 % belegtteils im RAM | Q4_K_M | 25 Token/sGut nutzbar | 89 |
| Passt8,2 GB · 73 % belegt | Q6_K | 54 Token/sFlüssig | 89 | |
| Passt8,7 GB · 78 % belegt | Q4_K_M | 51 Token/sFlüssig | 88 | |
| Passt21,1 GB · 60 % belegtteils im RAM | Q4_K_M | 27 Token/sGut nutzbar | 88 | |
| Passt21 GB · 60 % belegtteils im RAM | Q4_K_M | 25 Token/sGut nutzbar | 88 | |
| Passt8,1 GB · 73 % belegt | Q6_K | 57 Token/sFlüssig | 88 | |
| Passt8,2 GB · 73 % belegt | Q6_K | 57 Token/sFlüssig | 88 | |
| Passt19,7 GB · 56 % belegtteils im RAM | Q4_K_M | 28 Token/sGut nutzbar | 87 | |
| Passt19,7 GB · 56 % belegtteils im RAM | Q4_K_M | 28 Token/sGut nutzbar | 87 | |
Nemotron Cascade 2 30B A3BNVIDIA · 30B (3B aktiv) | Passt21 GB · 60 % belegtteils im RAM | Q4_K_M | 25 Token/sGut nutzbar | 87 |
| Passt19,3 GB · 55 % belegtteils im RAM | Q4_K_M | 29 Token/sGut nutzbar | 87 | |
Nemotron 3 Nano Omni 30B A3B ReasoningNVIDIA · 30B (3B aktiv) | Passt21 GB · 60 % belegtteils im RAM | Q4_K_M | 25 Token/sGut nutzbar | 87 |
| Passt16,6 GB · 47 % belegtteils im RAM | Q4_K_M | 35 Token/sFlüssig | 87 | |
| Passt13,6 GB · 39 % belegtteils im RAM | Q4_K_M | 42 Token/sFlüssig | 87 | |
Nemotron Nano 12B v2 VLNVIDIA · 12B | Passt8,7 GB · 78 % belegt | Q4_K_M | 52 Token/sFlüssig | 87 |
Nemotron 3 Nano 30B A3BNVIDIA · 30B (3B aktiv) | Passt21 GB · 60 % belegtteils im RAM | Q4_K_M | 25 Token/sGut nutzbar | 86 |
| Passt7,5 GB · 67 % belegt | Q6_K | 60 Token/sFlüssig | 86 |
Der nächste Schritt mit mehr Speicher:
Schätzung für llama.cpp-basierte Tools wie LM Studio und Ollama mit GGUF-Dateien. Die Ausgabegeschwindigkeit basiert auf dem durchschnittlichen Zustand des KV-Caches während eines Chats. Bei Full-Attention-Schichten rechnet der Check mit 50 % der verwendeten Kontextlänge, Sliding-Window-Schichten mittelt er separat. Der Wert beschreibt deshalb einen Durchschnitt, nicht das Tempo für jeden einzelnen Moment im Chat. Das Einlesen langer Prompts dauert zusätzlich. Passung, Quantisierungswahl und Empfehlungswert folgen dem Open-Source-Tool llmfit von Alex Jones.
In Chrome und Edge erkennt der Check deinen Chip oder deine Grafikkarte automatisch. Den Speicher stellst du selbst ein, weil der Browser ihn nicht verrät.
Über den kleinen Pfeil vor jedem Modell klappst du die Details auf. Dort siehst du, wie sich Speicherbedarf und Empfehlungswert zusammensetzen und worauf du achten solltest. Standardmäßig blendet der Check ältere Modelle und alles unter 10 Token pro Sekunde aus, beide Filter lassen sich abschalten.
So rechnet der Hardware-Check
Das Prinzip dahinter ist einfacher, als es klingt. Für jedes neue Token muss ein LLM seine Gewichte einmal komplett aus dem Speicher lesen. Das Tempo hängt deshalb vor allem von der Speicherbandbreite ab, also davon, wie viele Gigabyte pro Sekunde dein Chip aus dem Speicher holen kann.
Eine RTX 4090 hat laut Datenblatt 1.008 GB/s, ein Mac mit M4 kommt auf 120 GB/s. Dasselbe Modell läuft auf der Grafikkarte deshalb um ein Vielfaches schneller.
Fünf weitere Faktoren fließen in die Berechnung ein:
- Quantisierung: Die Gewichte werden mit weniger Bits gespeichert, bei Q4_K_M mit knapp 4,9 statt 16 Bit. Ein 8B-Modell schrumpft dadurch von 16 auf etwa 5 GB und wird entsprechend schneller. Je stärker die Quantisierung, desto ungenauer werden allerdings die Antworten. Der Check probiert deshalb für jedes Modell die Stufen von Q8_0 bis Q4_K_M durch und nimmt die mit dem besten Empfehlungswert. Q3_K_M und Q2_K kommen nur zum Zug, wenn sonst nichts passt.
- KV-Cache: Für jedes Token im Kontext speichert das Modell Zwischenergebnisse, die je nach Architektur sehr unterschiedlich viel Platz brauchen. Der Check berechnet das für 173 Modelle exakt aus ihrer Konfigurationsdatei auf Hugging Face. Für jedes neue Token liest das Modell seinen aktuell belegten KV-Cache. Das geschätzte Tempo basiert deshalb auf dem durchschnittlichen Zustand des Caches über einen Chat. Bei Full-Attention-Schichten rechnet der Check mit 50 % der verwendeten Kontextlänge, Sliding-Window-Schichten mittelt er separat. Ein quantisierter KV-Cache (Q8_0 oder Q4_0) halbiert bzw. viertelt Speicherbedarf und Lesezugriffe ungefähr.
- Mixture of Experts: Bei MoE-Modellen wie Qwen3.6 35B-A3B arbeiten pro Token nur 3 der 35 Milliarden Parameter. Das Modell braucht Platz für alle Gewichte, antwortet aber fast so schnell wie ein kleines Modell.
- Arbeitsspeicher als Reserve: Auf einem PC kann ein Teil des Modells in den normalen Arbeitsspeicher ausweichen. Das funktioniert, bremst aber stark, weil DDR5-Speicher nur einen Bruchteil der Bandbreite einer Grafikkarte hat. Beim Mac teilen sich CPU und GPU denselben schnellen Speicher. macOS gibt davon standardmäßig aber nur rund zwei Drittel für die Grafikeinheit frei (ab 48 GB rund drei Viertel), und genau mit diesem Wert rechnet der Check.
- Passung: Bis 60 % Speicherbelegung gilt ein Modell als „Locker“, bis 85 % als „Passt“ und bis 98 % als „Knapp“. Die letzten 2 % bleiben frei, weil ein randvoller Speicher in der Praxis nicht lädt. Reicht der Platz nicht, halbiert der Check die Kontextlänge so oft, bis das Modell passt (bis hinunter zu 2K).
So entsteht der Empfehlungswert
Der Empfehlungswert von 0 bis 100 kombiniert vier Teilnoten. Die Qualität ergibt sich aus Größe, Alter, Quantisierung und Benchmark-Ergebnissen eines Modells, dazu kommen Tempo, Passung und Kontext.
Wie stark jede Teilnote zählt, hängt vom Einsatzzweck ab:
Die Grundidee stammt aus dem Open-Source-Tool llmfit von Alex Jones. An einigen Stellen rechnet der Check feiner. Größe und Tempo bewertet er stufenlos, damit auf kleinen Rechnern nicht automatisch Mini-Modelle gewinnen, und Benchmarks zählen im Vergleich zum Median aller Modelle im Verzeichnis.
Abgeglichen ist die Formel mit 21 veröffentlichten Messungen aus den Benchmark-Threads von llama.cpp, von der RTX 3060 über verschiedene M-Chips bis zur DGX Spark. Bei klassischen Modellen liegt die Schätzung dort höchstens 15 % neben dem Messwert, bei MoE-Modellen höchstens 30 %.
Allerdings:
Es bleibt eine Schätzung. Dein echtes Tempo hängt auch vom Tool, den Treibern und der Länge deines Chats ab. Lange Prompts und Dokumente muss das Modell außerdem erst einlesen, bevor es antwortet, und diese Wartezeit steckt nicht in der Rechnung. Modelle ohne veröffentlichte Parameterzahl fehlen im Check, weil sich ihr Speicherbedarf nicht berechnen lässt.
Bei einigen MoE-Modellen nennt der Hersteller nur die Gesamtzahl der Parameter, z. B. bei MiniMax M2.5 oder GLM-5.2. Der Check rechnet dann vorsichtig so, als wären alle Parameter aktiv. In der Praxis antworten diese Modelle deshalb meist deutlich schneller, als die Tabelle anzeigt.
5. Open-Source-LLMs lokal auf dem eigenen Rechner nutzen
Open-Source-LLMs lokal auf dem eigenen Rechner zu nutzen, geht einfacher, als du vielleicht denkt:
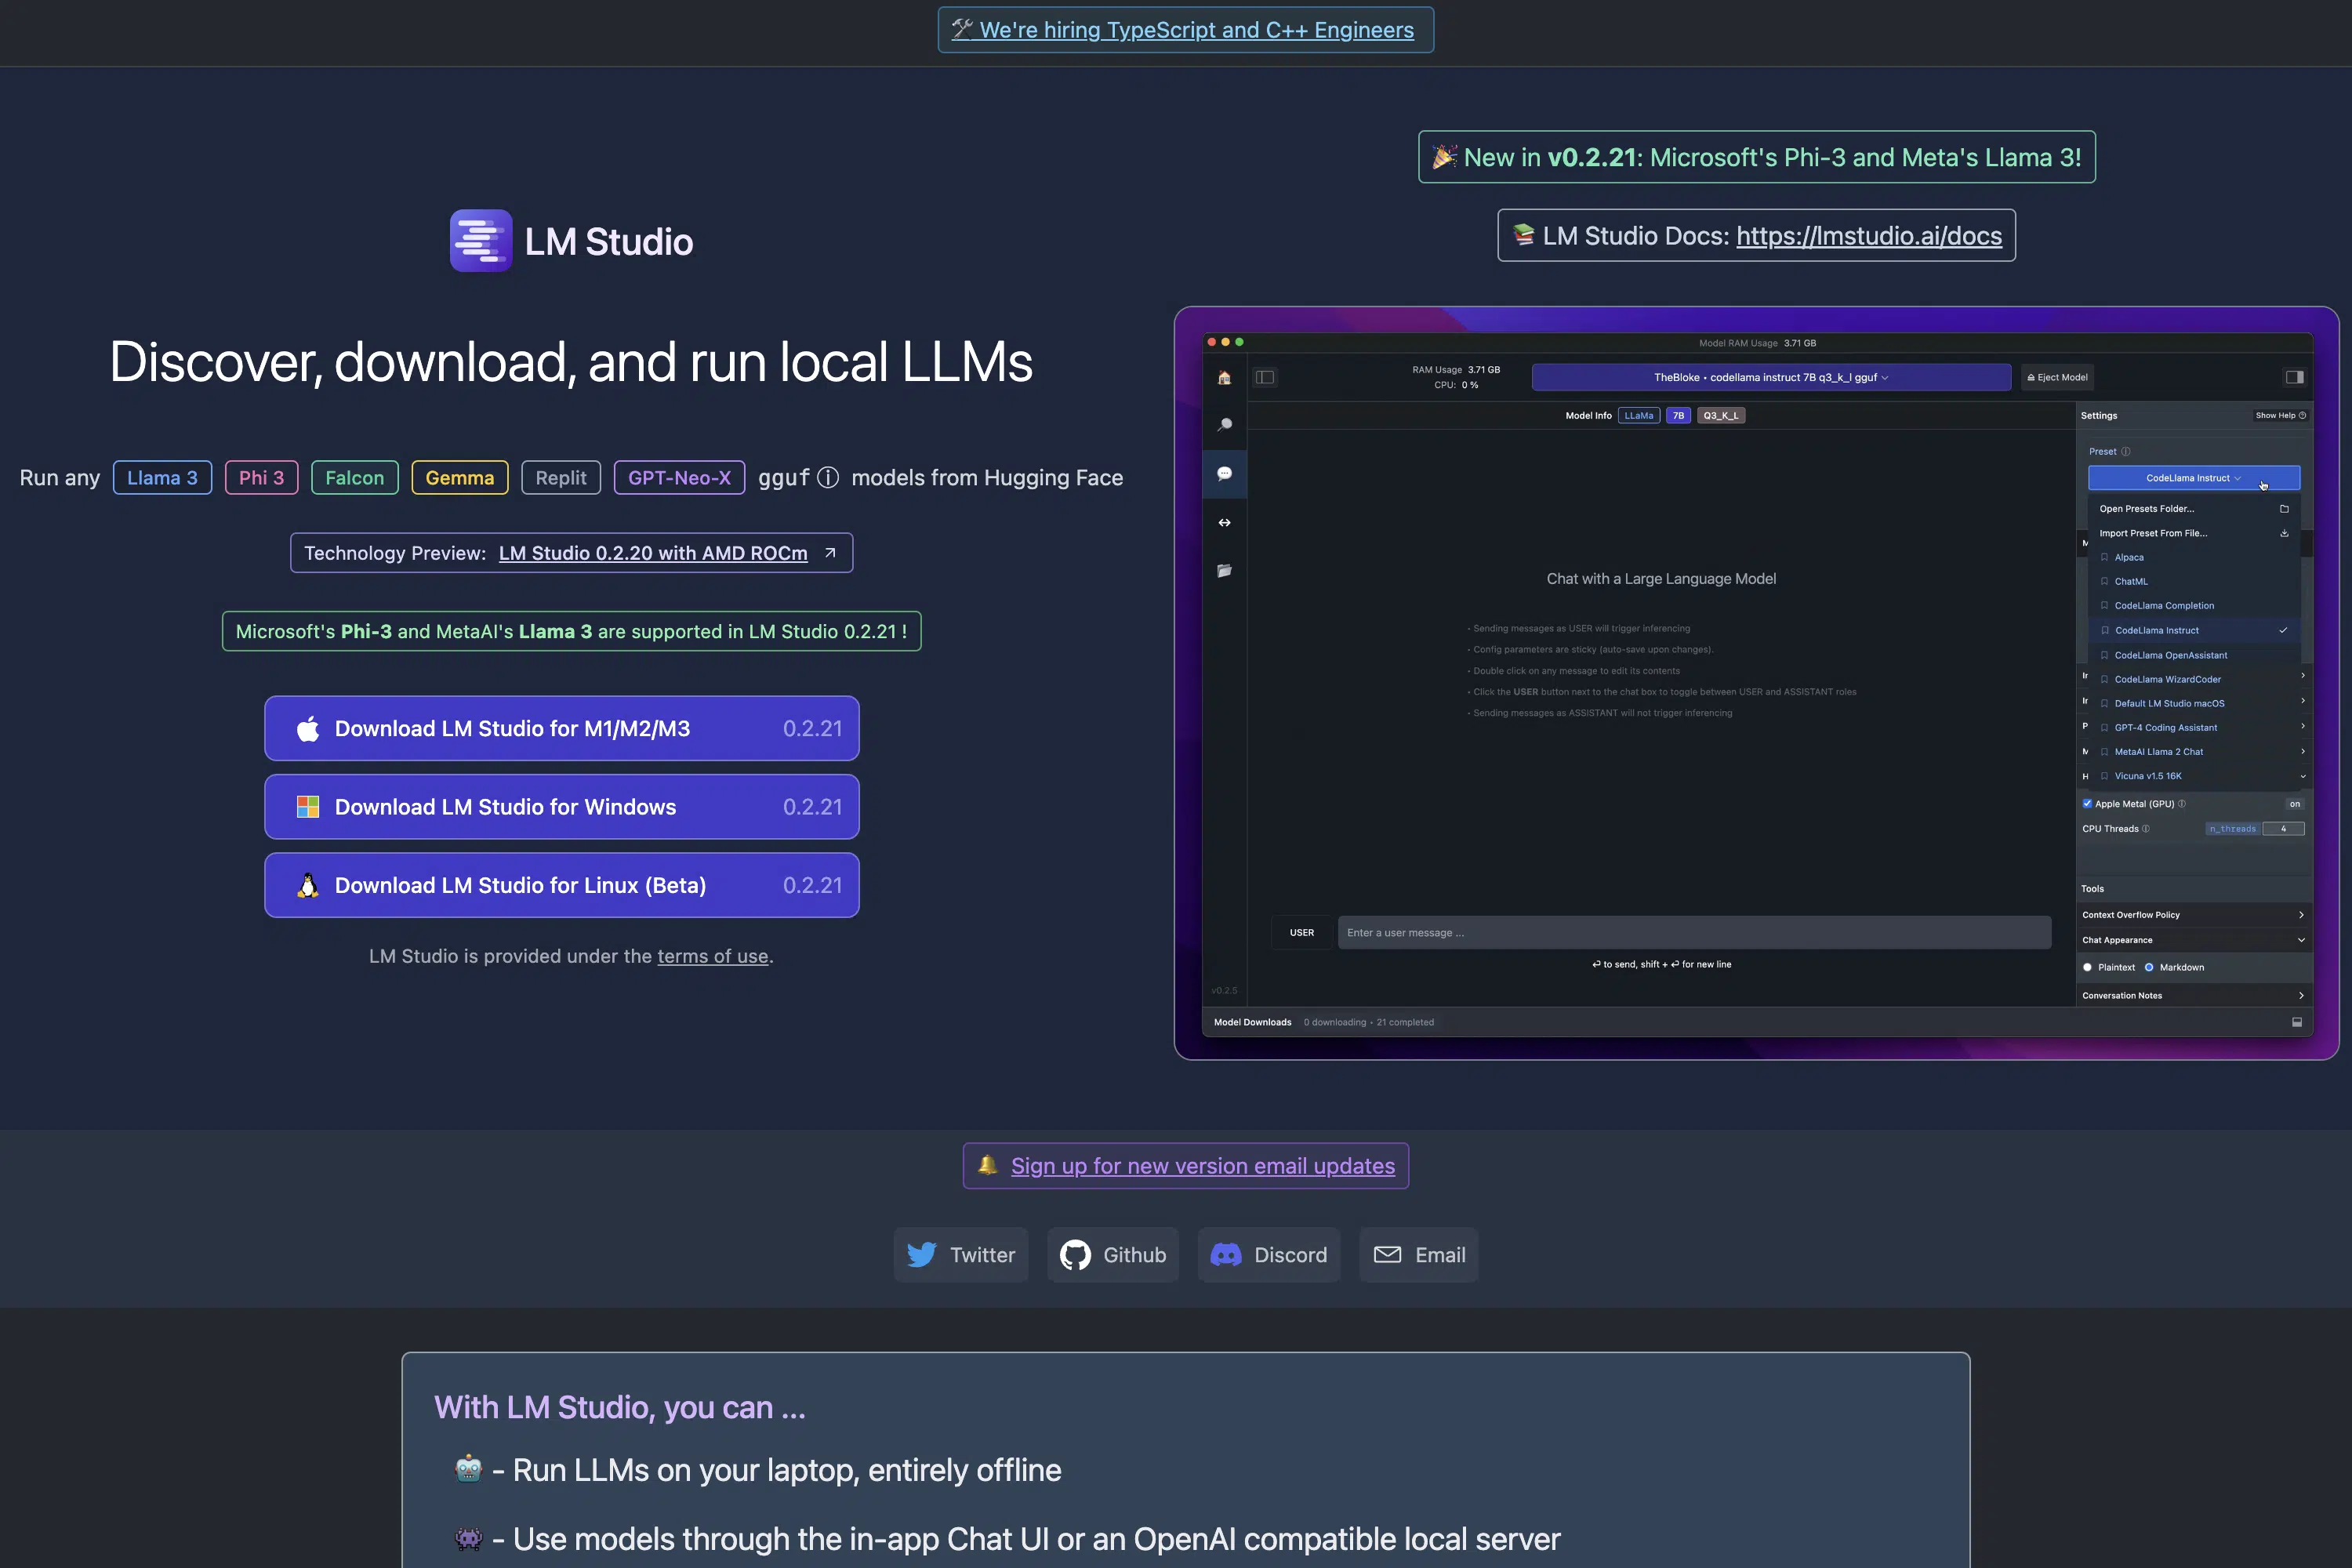
1. Lade LM Studio herunter
Lade LM Studio von der Website herunter. Es ist kostenlos und für Mac, Windows und Linux verfügbar:
2. Installiere und öffne LM Studio
Im nächsten Schritt installierst du LM Studio auf deinem Rechner und öffnest es.
3. Lade gewünschte Open-Source-LLMs herunter
Jetzt musst du die Open-Source-LLMs in LM Studio herunterladen, die du nutzen möchtest.
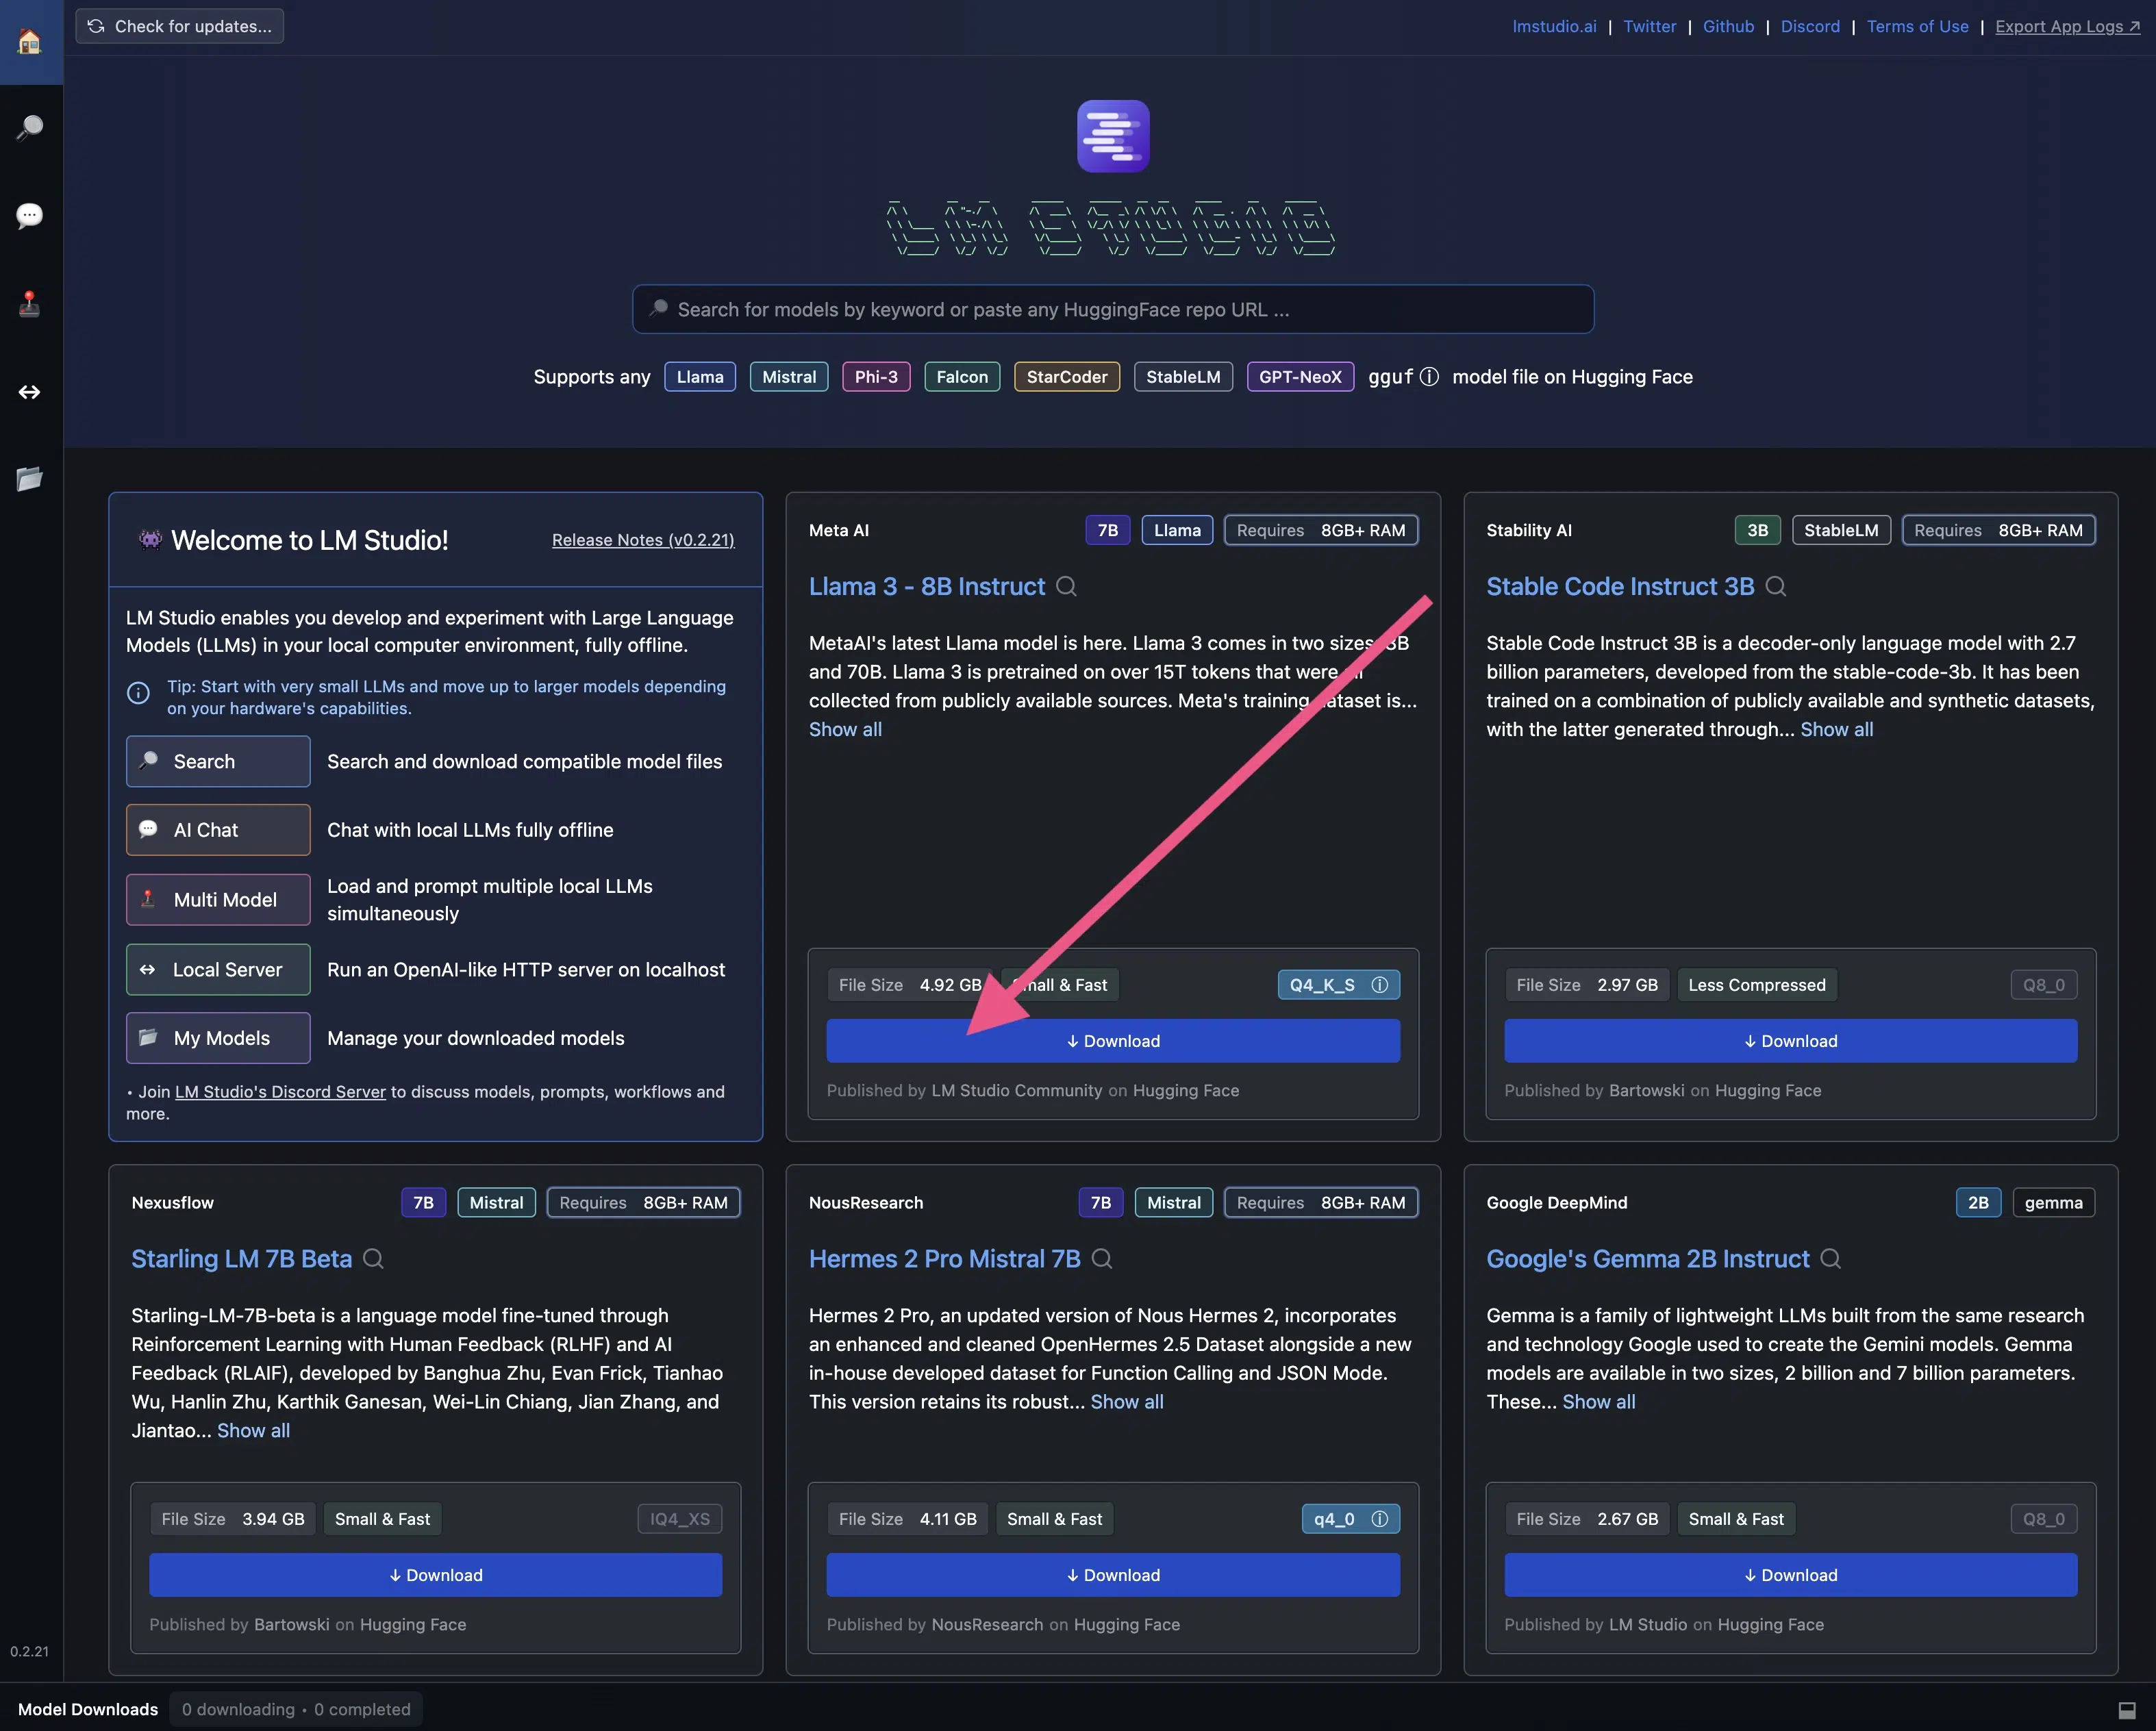
Viele beliebte LLMs findest du bereits auf dem Startbildschirm. Um ein LLM herunterzuladen, klickst du einfach auf den blauen Download-Button:
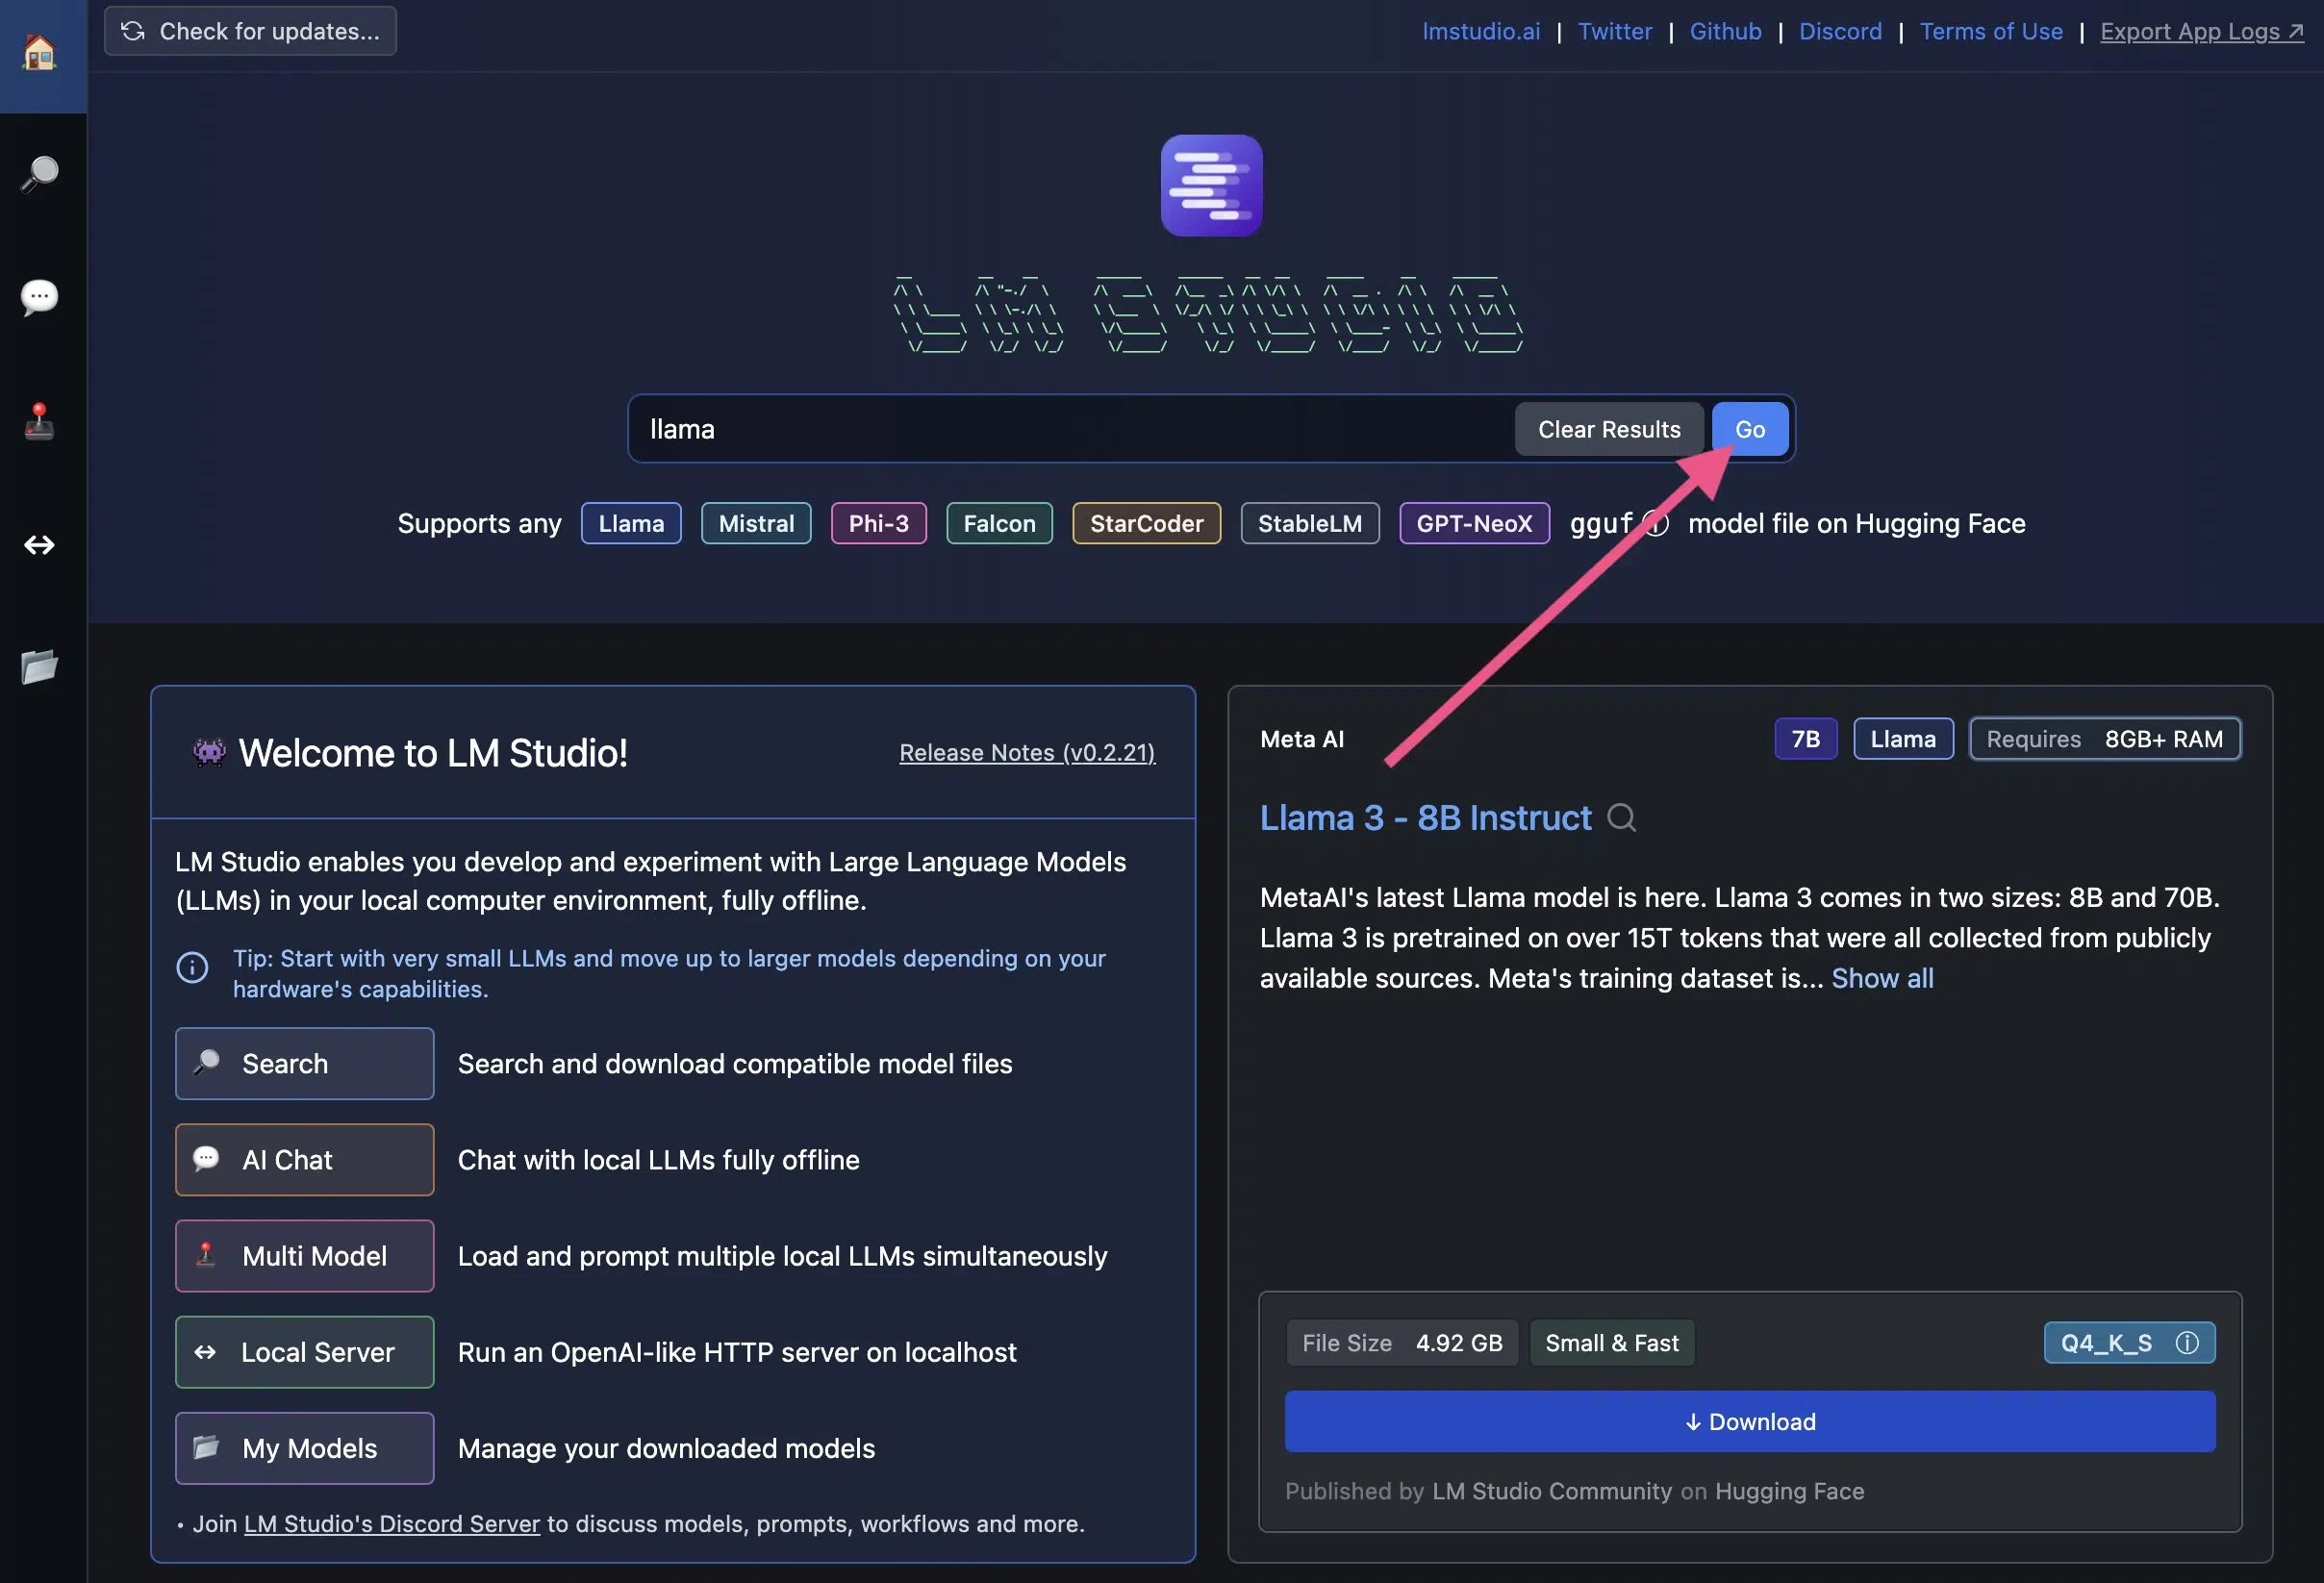
Um bestimmte Open-Source-LLMs zu finden, kannst du auch die Suchfunktion nutzen:
4. Wichtig: Vor dem Download Systemvoraussetzungen beachten
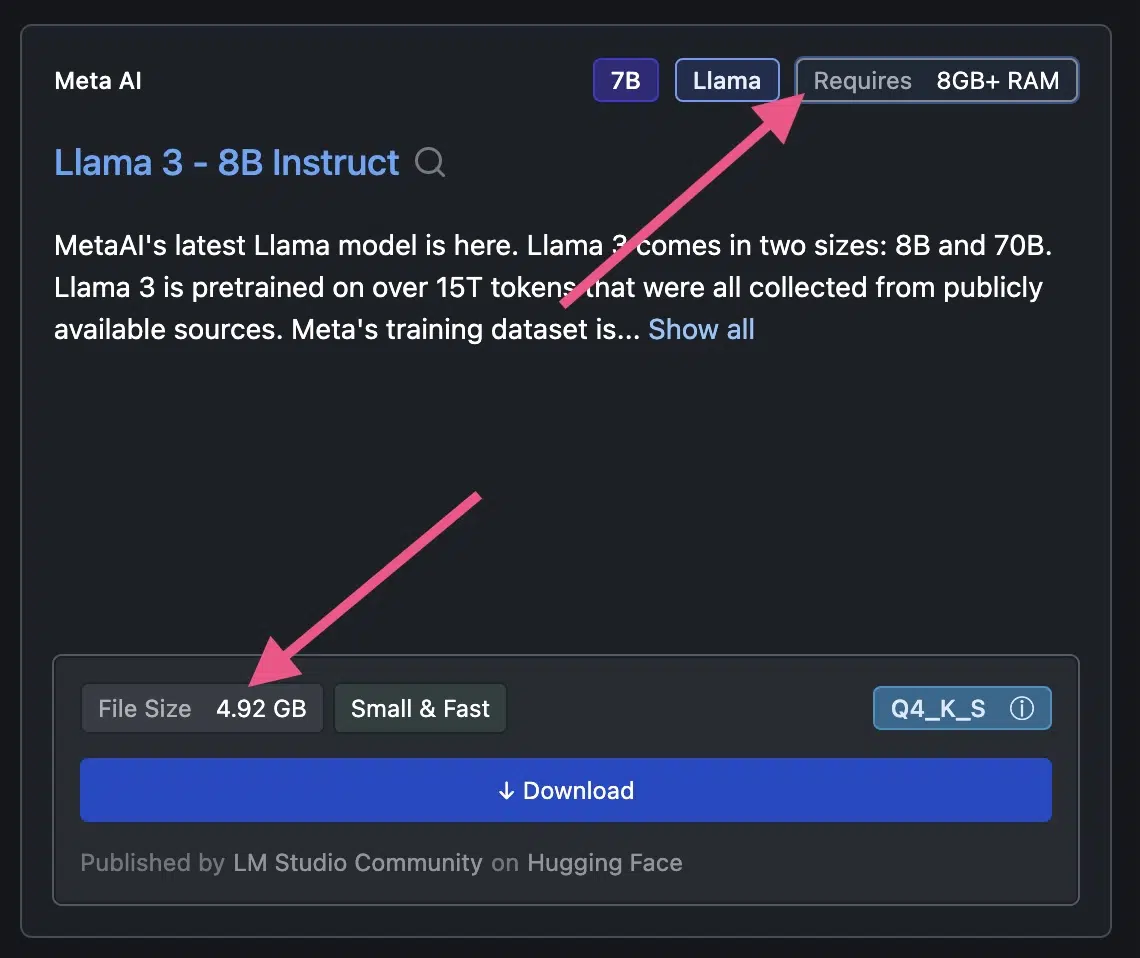
Bevor du ein LLM herunterlädst, solltest du dir die Systemvoraussetzungen anschauen.
Ob ein Modell überhaupt auf deinen Rechner passt, zeigt dir der Hardware-Check aus Kapitel 4. LM Studio blendet die Anforderungen zusätzlich direkt beim Download ein.
Llama 3 benötigt zum Beispiel mehr als 8 GB RAM und 4,92 GB freien Speicherplatz:
5. Mit dem Open-Source-LLM chatten
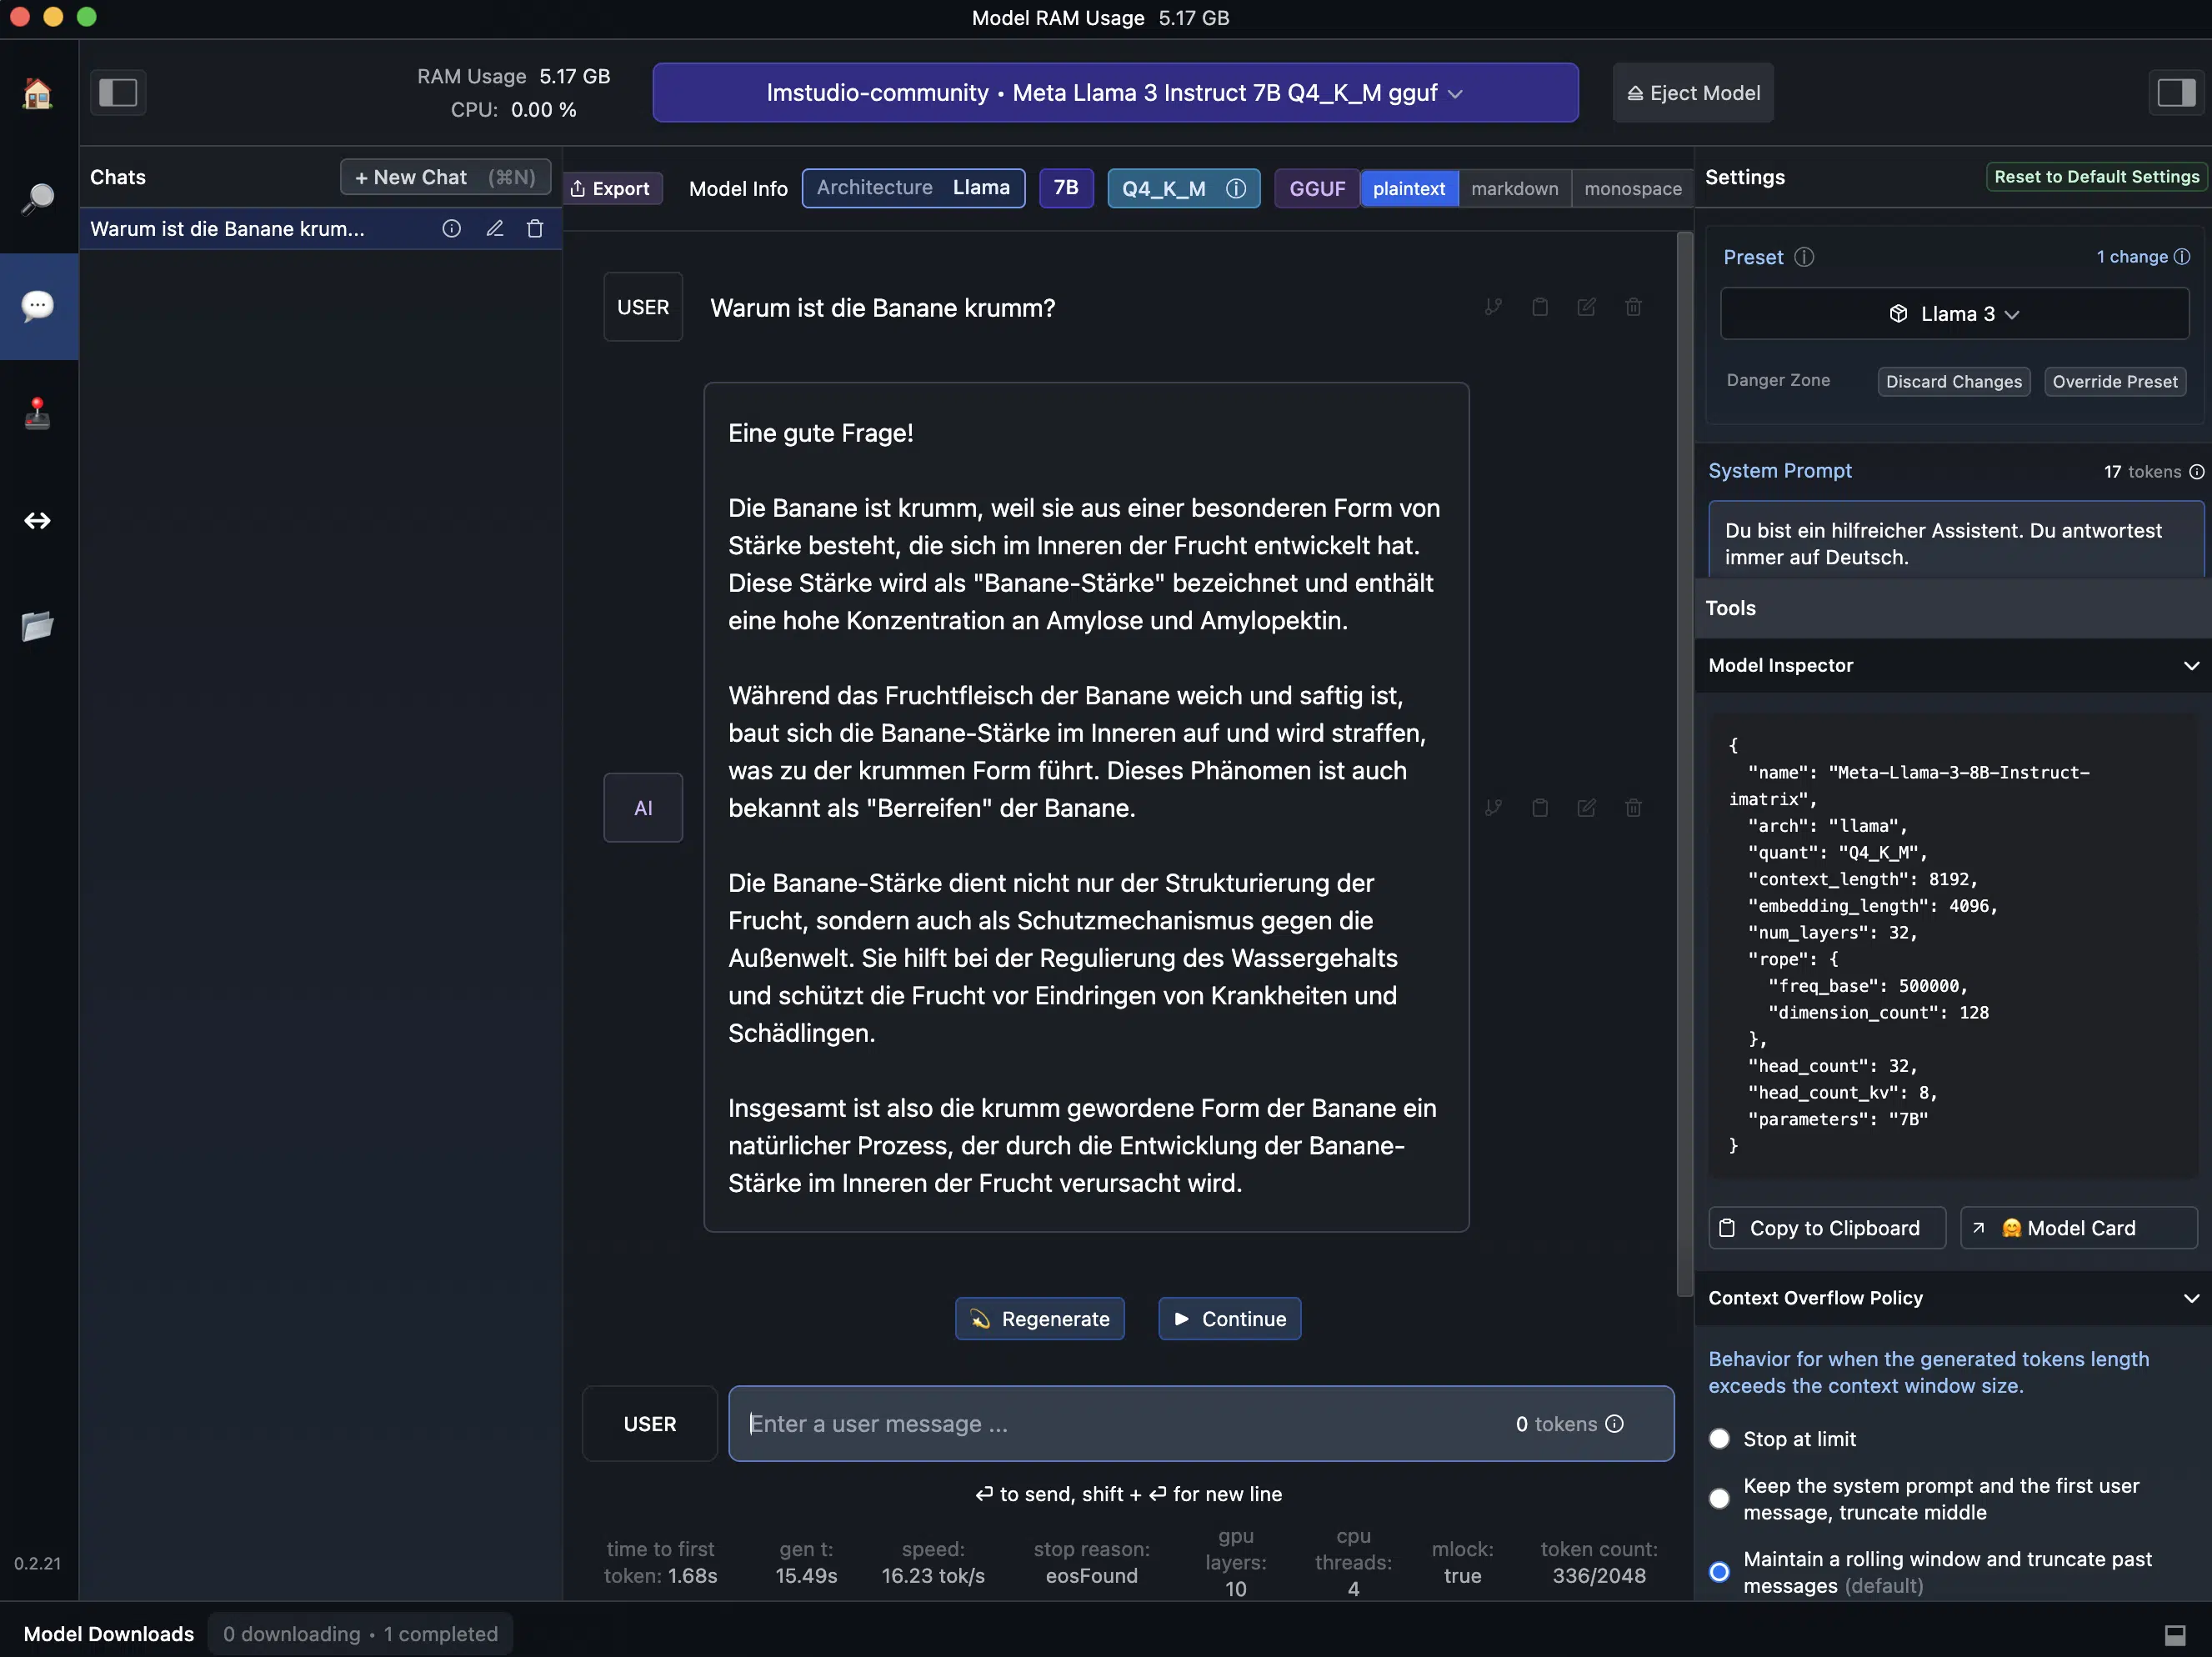
Nachdem du ein Open-Source-LLM heruntergeladen hast, kannst du es direkt in LM Studio nutzen.
Dazu klickst du einfach links in der Seitenleiste auf das Sprechblasen-Icon (?).
Die Benutzeroberfläche und die Einstellungsmöglichkeiten erinnern dabei an den OpenAI Playground:
Häufig gestellte Fragen zu Open-Source-LLMs
Als unkomplizierte Kandidaten kommen Modelle mit MIT- oder Apache-2.0-Lizenz infrage, zum Beispiel DeepSeek V4 Pro 0813, GLM-5.3-Flash, Qwen3.8 27B und Gemma 4. Die konkreten Modellversionen und Lizenzhinweise zählen.
Für GLM-5.3 muss der Lizenznehmer vor jeder kommerziellen Nutzung der Software oder ihrer Ableitungen die Sicherheitsprüfung von Z.AI bestehen. Das gilt, wenn der Lizenznehmer oder eines seiner verbundenen Unternehmen ein Model-as-a-Service-Geschäft betreibt und der Gesamtumsatz des Lizenznehmers und seiner verbundenen Unternehmen in einem beliebigen Zeitraum von zwölf aufeinanderfolgenden Monaten 10 Milliarden US-Dollar oder den Gegenwert in einer anderen Währung übersteigt.
Für Kimi K3 muss der Lizenznehmer vor jeder kommerziellen Nutzung der Software oder ihrer Ableitungen eine separate Vereinbarung mit Moonshot AI schließen. Das gilt, wenn der Lizenznehmer oder eines seiner verbundenen Unternehmen ein Model-as-a-Service-Geschäft betreibt und der Gesamtumsatz des Lizenznehmers und seiner verbundenen Unternehmen in einem beliebigen Zeitraum von zwölf aufeinanderfolgenden Monaten 20 Millionen US-Dollar oder den Gegenwert in einer anderen Währung übersteigt.
Zusätzlich muss die Benutzeroberfläche „Kimi K3“ prominent nennen, wenn die Software oder davon abgeleitete Werke in einem kommerziellen Produkt oder Dienst des Lizenznehmers mit mehr als 100 Millionen monatlich aktiven Nutzern oder mehr als 20 Millionen US-Dollar Monatsumsatz (oder dem Gegenwert in einer anderen Währung) eingesetzt werden. Beide Kimi-Bedingungen gelten nicht für die interne Nutzung, wenn Software, ihre Ergebnisse oder ihre zugrunde liegenden Fähigkeiten Dritten nicht verfügbar gemacht werden. Ebenfalls ausgenommen ist die Nutzung über offizielle Moonshot-Produkte oder zertifizierte Inferenzpartner.
MiniMax M2.7 ist nicht-kommerziell lizenziert. Kommerzielle Nutzung erfordert eine vorherige schriftliche Genehmigung und die prominente Kennzeichnung „Built with MiniMax M2.7“. Prüfe vor dem Einsatz die Lizenz des konkreten Modellstands.
Diese Programme decken unterschiedliche Teile der lokalen Nutzung ab:
- Ollama: lokaler Modell-Runner mit Kommandozeile und Modellbibliothek
- LM Studio: Desktop-Oberfläche zum Herunterladen und Ausführen unterstützter Modelle
- GPT4All und Jan: Desktop-Anwendungen für lokale Chat-Modelle
- vLLM: Server für das Bereitstellen und Ausführen unterstützter Modelle
Kein Programm unterstützt automatisch jedes Modell oder Format. Prüfe die jeweilige Modell- und Hardware-Kompatibilität.