OpenAILLM-Duell
GPT-6.2 Solvs.GPT-5.5
Lohnt sich der Aufpreis?
GPT-6.2 Sol schneidet besser als GPT-5.5 ab und ist günstiger: GPT-5.5 kostet 2,5-mal (Eingabe) und 3-mal (Ausgabe) so viel.
GPT-6.2 Sol
Platz 10
GPT-5.5
Platz 31
GPT-6.2 Sol
GPT-5.5
GPT-6.2 Sol
GPT-5.5
Bei über 272.000 Eingabe-Token kostet GPT-6.2 Sol mehr: 4 $ Eingabe und 15 $ Ausgabe je 1 Mio. Token. Bei über 272.000 Eingabe-Token kostet GPT-5.5 mehr: 10 $ Eingabe und 45 $ Ausgabe je 1 Mio. Token.
Nimm GPT-6.2 Sol für
Bei GPT-5.5 gibt es keinen klaren Vorteil.
Wo liegt der Unterschied?
Stärken im Überblick
GPT-6.2 SolGPT-5.5Median aller Modelle mit Platz
95-%-Bereich: GPT-6.2 Sol 117,0 bis 130,1, GPT-5.5 86,7 bis 103,4.
Dieselben Werte und Urteile wie die Balken darunter. Im Ausschnitt beginnt das Netz bei 90 Punkten, knapp unter dem schwächsten Wert der beiden Modelle; der Durchschnitt der Referenzgruppe liegt bei 100. Nicht im Netz, weil ein Modell dort keinen eigenen Wert hat oder die Daten zu dünn sind: Mathematik, Wissen, Multimodal, Gesundheit.
GPT-6.2 Sol liegt in 6 von 10 Bereichen vorn, GPT-5.5 in keinem.
GPT-6.2 Sol vorn: 6zu wenig Daten: 4
Die Balkenlänge zeigt den Abstand in Indexpunkten (volle Breite 15 Punkte, eine Standardabweichung der Referenzgruppe). Voll heißt sicher vorn, schraffiert noch nicht sicher, ein dünner grauer Balken gleichauf.
2 weitere Bereiche anzeigen, die nicht zum Gesamtindex zählen
Die Balkenlänge zeigt den Abstand in Indexpunkten (volle Breite 15 Punkte, eine Standardabweichung der Referenzgruppe). Voll heißt sicher vorn, schraffiert noch nicht sicher, ein dünner grauer Balken gleichauf.
Welches Modell für welche Aufgabe?
Alltagsaufgaben, übersetzt aus den Bereichswerten oben. Jede Zeile nennt die Werte, auf denen sie beruht.
GPT-6.2 Sol gegen GPT-5.5 im eigenen Test
Derselbe Prompt für beide Modelle. Gezeigt wird der neueste Versuch ohne Nachbesserung; er zählt nicht zum Gesamtindex.
Pelikan auf dem Fahrrad
Auftrag (englisches Original)
Generate an SVG of a pelican riding a bicycle
GPT-6.2 Sol
Noch nicht getestet
GPT-5.5
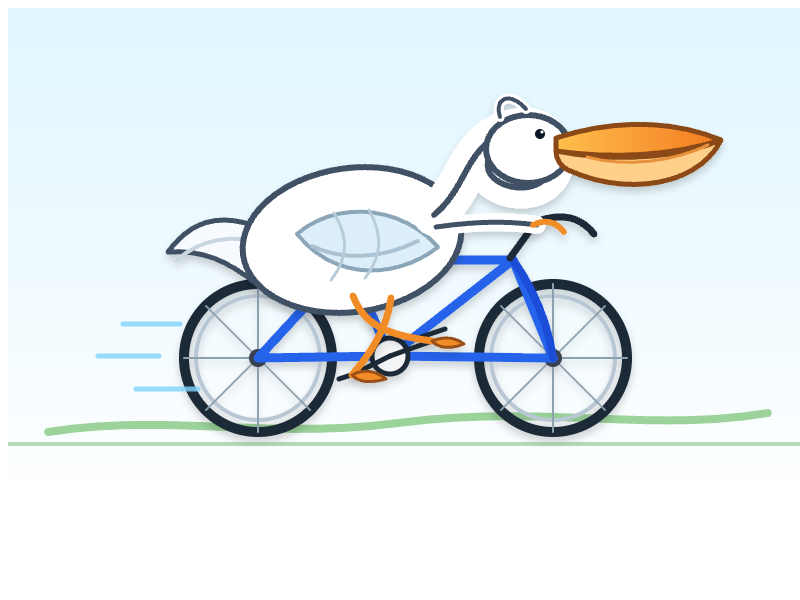
01.10.2026 · 26 s · 0,09 $
Testdetails
- Datum des Testlaufs
- 01.10.2026
- API-Anbieter
- openrouter
- Angefragtes API-Modell
- openai/gpt-5.5
- Reasoning-Einstellung
- high
- Tokenlimit inklusive Reasoning
- 8.192 Token
- Ausgabe-Token
- 3.163 Token
- Kosten des Versuchs
- 0,0950 $
- Antwortzeit
- 25,9 s
- API-Modell laut Antwort
- openai/gpt-5.5
- Festgelegter Endpunkt
- OpenAI | openai/gpt-5.5-20260423
- Temperatur
- Anbieterstandard
- Testprotokoll
- community-visual-tests-v1
- Technische Prüfung
- Bestanden, keine Qualitätsbewertung
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Frühere Versuche (1)
- 07.09.2026API-Anfrage fehlgeschlagenReasoning-Einstellung: high
SVG-Kurztest
Für diese Auswahl gibt es keine gemeinsame Testrunde. Es werden keine Ergebnisse aus verschiedenen Runden gemischt.
GPT-6.2 Sol und GPT-5.5 im Gesamtindex
Alle Modelle mit Platz im Gesamtindex, beide Modelle dieses Vergleichs hervorgehoben. Weitere Modelle kannst du dazunehmen oder ausblenden.
Gesamtindex (Gradually Meta-Score v6)
20 von 99 Modellen
Alle Daten im Vergleich
Der bessere Wert ist fett. Beim Gesamtindex nur, wenn der Abstand klar ist.
| Kennzahl | GPT-6.2 Sol | GPT-5.5 |
|---|---|---|
| Leistung | ||
| GesamtindexPunkte, 100 = Durchschnitt der Referenzgruppe, höher ist besser | 119,2 | 101,4 |
| Platz | Platz 10 von 99 | Platz 31 von 99 |
| Preis je 1 Mio. Token | ||
| Eingabewas du schickst | 2 $über 272.000 Eingabe-Token: 4 $ | 5 $über 272.000 Eingabe-Token: 10 $ |
| Ausgabewas das Modell schreibt | 10 $über 272.000 Eingabe-Token: 15 $ | 30 $über 272.000 Eingabe-Token: 45 $ |
| Tempo | ||
| Token pro Sekunde | k. A. | 69 |
| Technik | ||
| KontextfensterKontextlimit laut Quelle | 1,05 Mio. Token≈ 1.580 A4-Seiten | 1,05 Mio. Token≈ 1.580 A4-Seiten |
| Wissensstand | 01.06.2026 | 01.12.2025 |
| Veröffentlicht | 17.11.2026 | 23.04.2026 |
| Verfügbarkeit | Aktiv | Aktiv |
| Offene Gewichte | nein | nein |
- GPT-6.2 Sol, 12-Stunden-Cache-Schreibpreis: Der Tabellenpreis gilt für 30 Minuten. Für 12 Stunden berechnet OpenAI im Standardtarif 5 US-Dollar je 1 Mio. Token bis einschließlich 272.000 Eingabe-Token. Quelle
- GPT-6.2 Sol, Preise für lange Eingaben: Über 272.000 Eingabe-Token gilt für die gesamte Anfrage der höhere Tarif. Quelle
- GPT-6.2 Sol, Batch, Fast und Ultrafast: Batch kostet die Hälfte des Standardtarifs, Fast das Doppelte. Ultrafast kostet bis 28. Februar 2027 das Dreifache und ab 1. März 2027 das Sechsfache. Die Umstellung richtet sich nach US-Pazifikzeit. Quelle
Preise ohne Rabatte für Zwischenspeicher und Stapelverarbeitung · Seitenzahl als Faustregel nach Artificial Analysis
Gibt es eine bessere Wahl?
Gesamtindex 109,5, Platz 184 $ Eingabe und 20 $ Ausgabe je 1 Mio. Token
GPT-6.2 Sol vs. GPT-5.6 SolGesamtindex 127,8, Platz 22 $ Eingabe und 10 $ Ausgabe je 1 Mio. Token
GPT-6.2 Sol vs. Gemini 4 CarbonGesamtindex 130,3, Platz 18 $ Eingabe und 40 $ Ausgabe je 1 Mio. Token
GPT-6.2 Sol vs. Claude Fable 5.2Gemeinsame Benchmarks
Einzelwerte aus derselben Benchmark-Version, Aufgabe und Messgröße. Fett ist ein Wert nur bei gleichem Testaufbau und klarem Abstand.
A: GPT-6.2 SolB: GPT-5.5
Weitere Vergleiche
Vergleiche GPT-6.2 Sol und GPT-5.5 mit den Modellen, die am häufigsten mit ihnen verglichen werden.
Anderes Duell vergleichen
Vorgänger und Nachfolger
Die beliebtesten Vergleiche
- 1GPT-6.2 Astra vs. GPT-6.2 Sol
- 2Claude Opus 5.5 vs. GPT-6.2 Sol
- 3GPT-6.2 Sol vs. GLM-5.3
- 4Claude Fable 5.2 vs. GPT-6.2 Sol
- 5GPT-6.2 Sol vs. GPT-6.1 Terra
- 6Claude Opus 5.5 vs. GPT-5.5
- 7GPT-6.1 Sol vs. GPT-5.5
- 8GPT-6 Luna vs. GPT-5.5
- 9Claude Haiku 5.5 vs. GPT-5.5
Alle 22 Vergleiche zeigen
- 10GPT-5.5 vs. Gemini 3.8 Flash
- 11GPT-6.1 Terra vs. GPT-5.5
- 12Claude Sonnet 5.5 vs. GPT-5.5
- 13GPT-5.6 Luna vs. GPT-5.5
- 14GPT-5.5 vs. Qwen 3.8 27B
- 15Claude Sonnet 5 vs. GPT-5.5
- 16GPT-5.5 vs. Gemini 4 Carbon
- 17GPT-5.5 vs. DeepSeek V4.1 Flash 1017
- 18GPT-6 Sol vs. GPT-5.5
- 19Claude Sonnet 4.6 vs. GPT-5.5
- 20Claude Opus 4.8 vs. GPT-5.5
- 21Claude Haiku 4.5 vs. GPT-5.5
- 22GPT-6.2 Sol vs. Gemini 4 Neon