Claude Opus 4.6
Direktvergleich
Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.
Steckbrief
Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.
| Merkmal | Claude Opus 4.6 | GPT-5.4 mini |
|---|---|---|
| Anbieter | Anthropic | OpenAI |
| Erschienen | Feb. 2026 | 17. März 2026 |
| Verfügbarkeit | Aktiv | Aktiv |
| Modelltyp | Proprietär | Proprietär |
| Parameter | Nicht veröffentlicht | Nicht veröffentlicht |
| Architektur | Nicht veröffentlicht | Nicht veröffentlicht |
| Kontextfenster | 1.000.000 Token | 400.000 Token |
| Wissensstand | Mai 2025 | 31. August 2025 |
| Technische Quellen | Modell, Kontext | Modell |
Kosten
Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.
| Preisart | Claude Opus 4.6 | GPT-5.4 mini |
|---|---|---|
| API-Eingabe | 5 $ | 0,75 $ |
| API-Ausgabe | 25 $ | 4,5 $ |
| Cache lesen | 0,5 $ | 0,075 $ |
| Cache schreiben (5 Min.) | 6,25 $ | Nicht ausgewiesen |
| Cache schreiben (1 Std.) | 10 $ | Nicht ausgewiesen |
| Preis geprüft | 22.09.2026 Quelle | 22.09.2026 Quelle |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.
| Modell | Anbieter | Bezugsweg und Tarif | Eingabe pro 1 Mio. Token | Ausgabe pro 1 Mio. Token | Quelle |
|---|---|---|---|---|---|
| Claude Opus 4.6 | Anthropic | Direkt beim EntwicklerStandard-API | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle22.09.2026 |
| Amazon Bedrock | Über OpenRouteramazon-bedrock | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle26.10.2026 | |
| Anthropic | Über OpenRouteranthropic | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle26.10.2026 | |
| Azure | Über OpenRouterazure/global | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle26.10.2026 | |
| Claude Platform on AWS | Über OpenRouterclaude-on-aws | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle26.10.2026 | |
| Über OpenRoutergoogle-vertex/europe | 5,5 $ | 27,5 $ | Quelle26.10.2026 | ||
| Über OpenRoutergoogle-vertex/global | Günstigster erfasster Preis: 5 $ | Günstigster erfasster Preis: 25 $ | Quelle26.10.2026 | ||
| GPT-5.4 mini | OpenAI | Direkt beim EntwicklerStandard-API | 0,75 $ | 4,5 $ | Quelle22.09.2026 |
| Azure | Über OpenRouterazure | 0,75 $ | 4,5 $ | Quelle26.10.2026 | |
| Azure | Über OpenRouterazure/us | 0,825 $ | 4,95 $ | Quelle26.10.2026 | |
| OpenAI | Über OpenRouteropenai | 0,75 $ | 4,5 $ | Quelle26.10.2026 | |
| OpenAI | Über OpenRouteropenai/fast | 1,5 $ | 9 $ | Quelle26.10.2026 | |
| OpenAI | Über OpenRouteropenai/flex | Günstigster erfasster Preis: 0,375 $ | Günstigster erfasster Preis: 2,25 $ | Quelle26.10.2026 |
Benchmark-Index
Der Index fasst unabhängige Benchmarks auf einer Skala von 0 bis 100 zusammen. Ein Vorsprung zählt erst, wenn ein Modell in mindestens 95 % von 200 Neuberechnungen mit zufällig neu gezogenen Testfamilien vorn liegt. Sonst gelten beide als gleichauf.
Claude Opus 4.6 liegt in 4 von 4 gemeinsamen Bereichen vorn.
| Bereich | Claude Opus 4.6 | GPT-5.4 mini |
|---|---|---|
| Programmieren | 43,8 | 5,9 |
| Agenten | 48,0 | 4,5 |
| Finanzen | 72,9 | 3,6 |
| Recht | 71,5 | 1,2 |
Leistung
Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.
Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.
Nicht genug direkt vergleichbare Kategorien für ein belastbares Radar
Nur 2 von mindestens 5 Kategorien enthalten direkt vergleichbare Modellmessungen. Die Benchmarktabellen darunter zeigen die vorhandenen Belege, ohne fehlende Achsen aufzufüllen.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
| Benchmark und Aufgabe | Claude Opus 4.6 | GPT-5.4 mini | Quelle |
|---|---|---|---|
LMArena Code Arena WebDevOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Code Arena WebDev GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Code Arena WebDevClaude Opus 4.6: Arena-Bewertung aus 20.698 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 11.978 veröffentlichten Paarvergleichen. | Höherer Messwert1.537,258 95-%-Konfidenzintervall: ±5,345Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.397,568 95-%-Konfidenzintervall: ±6,522Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlOverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Vision, style control GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 26.853 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 25.733 veröffentlichten Paarvergleichen. | Höherer Messwert1.294,46 95-%-Konfidenzintervall: ±6,329Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.250,938 95-%-Konfidenzintervall: ±6,248Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
Vibe Code Bench v1.1OverallTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: 1.1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.6: Compute: max, Harness: OpenHands, Temperatur: 1, Ausgabegrenze: 128.000 tokens GPT-5.4 mini: Snapshot: gpt-5.4-mini-2026-03-17, Reasoning: xhigh, Harness: OpenHands, Ausgabegrenze: 128.000 tokens | Höherer Messwert57,573 % | 47,969 % | Vals AIQuellendetailsDatenstand: 12.10.2026 |
LMArena Code Arena WebDevOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Code Arena WebDev GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Code Arena WebDevClaude Opus 4.6: Arena-Bewertung aus 19.443 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 11.978 veröffentlichten Paarvergleichen. | Gewinner1.546,362 95-%-Konfidenzintervall: ±5,46Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.397,568 95-%-Konfidenzintervall: ±6,522Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlOverallTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Vision, style control GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 22.304 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 25.733 veröffentlichten Paarvergleichen. | Gewinner1.299,232 95-%-Konfidenzintervall: ±6,456Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.250,938 95-%-Konfidenzintervall: ±6,248Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Code Arena WebDevWebdevTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Code Arena WebDev GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Code Arena WebDevClaude Opus 4.6: Arena-Bewertung aus 20.698 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 11.978 veröffentlichten Paarvergleichen. | Höherer Messwert1.537,258 95-%-Konfidenzintervall: ±5,345Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.397,568 95-%-Konfidenzintervall: ±6,522Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlChineseTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Vision, style control GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 1.685 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 1.662 veröffentlichten Paarvergleichen. | Höherer Messwert1.348,115 95-%-Konfidenzintervall: ±17,347Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.285,423 95-%-Konfidenzintervall: ±17,385Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Code Arena WebDevWebdevTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Code Arena WebDev GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Code Arena WebDevClaude Opus 4.6: Arena-Bewertung aus 19.443 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 11.978 veröffentlichten Paarvergleichen. | Gewinner1.546,362 95-%-Konfidenzintervall: ±5,46Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.397,568 95-%-Konfidenzintervall: ±6,522Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlChineseTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Vision, style control GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 1.488 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 1.662 veröffentlichten Paarvergleichen. | Gewinner1.351,953 95-%-Konfidenzintervall: ±17,967Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.285,423 95-%-Konfidenzintervall: ±17,385Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Code Arena WebDevWebdev-htmlTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Code Arena WebDev GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Code Arena WebDevClaude Opus 4.6: Arena-Bewertung aus 2.623 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 1.436 veröffentlichten Paarvergleichen. | Höherer Messwert1.546,218 95-%-Konfidenzintervall: ±12,521Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.419,865 95-%-Konfidenzintervall: ±16,676Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlCreative writing visionTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Vision, style control GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 1.731 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 1.627 veröffentlichten Paarvergleichen. | Höherer Messwert1.297,75 95-%-Konfidenzintervall: ±15,034Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.226,475 95-%-Konfidenzintervall: ±15,662Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Code Arena WebDevWebdev-htmlTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Code Arena WebDev GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Code Arena WebDevClaude Opus 4.6: Arena-Bewertung aus 2.474 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 1.436 veröffentlichten Paarvergleichen. | Gewinner1.558,715 95-%-Konfidenzintervall: ±13,217Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.419,865 95-%-Konfidenzintervall: ±16,676Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlCreative writing visionTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Vision, style control GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 1.405 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 1.627 veröffentlichten Paarvergleichen. | Gewinner1.309,447 95-%-Konfidenzintervall: ±16,801Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.226,475 95-%-Konfidenzintervall: ±15,662Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Code Arena WebDevWebdev-reactTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Code Arena WebDev GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Code Arena WebDevClaude Opus 4.6: Arena-Bewertung aus 16.319 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 9.859 veröffentlichten Paarvergleichen. | Höherer Messwert1.528,416 95-%-Konfidenzintervall: ±5,908Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.386,539 95-%-Konfidenzintervall: ±7,117Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlDiagramTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Vision, style control GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 7.260 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 6.941 veröffentlichten Paarvergleichen. | Höherer Messwert1.331,371 95-%-Konfidenzintervall: ±8,825Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.283,959 95-%-Konfidenzintervall: ±8,767Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Code Arena WebDevWebdev-reactTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: webdevMessgröße: WebDev Arena Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Code Arena WebDev GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Code Arena WebDevClaude Opus 4.6: Arena-Bewertung aus 15.177 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 9.859 veröffentlichten Paarvergleichen. | Gewinner1.538,872 95-%-Konfidenzintervall: ±6,058Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.386,539 95-%-Konfidenzintervall: ±7,117Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 13.10.2026 |
LMArena Vision, Style ControlDiagramTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Vision, style control GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 5.999 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 6.941 veröffentlichten Paarvergleichen. | Gewinner1.324,675 95-%-Konfidenzintervall: ±9,238Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.283,959 95-%-Konfidenzintervall: ±8,767Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Vision, Style ControlEnglishTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Vision, style control GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 11.327 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 10.691 veröffentlichten Paarvergleichen. | Höherer Messwert1.296,058 95-%-Konfidenzintervall: ±8,463Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.248,605 95-%-Konfidenzintervall: ±8,435Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Vision, Style ControlEnglishTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Vision, style control GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 9.251 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 10.691 veröffentlichten Paarvergleichen. | Gewinner1.301,128 95-%-Konfidenzintervall: ±8,811Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.248,605 95-%-Konfidenzintervall: ±8,435Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Vision, Style ControlEntity recognitionTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Vision, style control GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 190 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 184 veröffentlichten Paarvergleichen. | Höherer Messwert1.237,39 95-%-Konfidenzintervall: ±39,346Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.195,219 95-%-Konfidenzintervall: ±40,866Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Vision, Style ControlEntity recognitionTestdetailsKein dokumentierter Unterschied im TestaufbauKein klarer VorsprungVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Vision, style control GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 125 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 184 veröffentlichten Paarvergleichen. | Kein klarer Vorsprung1.234,469 95-%-Konfidenzintervall: ±47,028Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.195,219 95-%-Konfidenzintervall: ±40,866Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Vision, Style ControlHomeworkTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Vision, style control GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 3.708 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 3.503 veröffentlichten Paarvergleichen. | Höherer Messwert1.311,92 95-%-Konfidenzintervall: ±10,944Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.291,223 95-%-Konfidenzintervall: ±11,062Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Vision, Style ControlHomeworkTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Vision, style control GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 2.849 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 3.503 veröffentlichten Paarvergleichen. | Gewinner1.324,17 95-%-Konfidenzintervall: ±12,006Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.291,223 95-%-Konfidenzintervall: ±11,062Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Vision, Style ControlHumorTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Vision, style control GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 1.025 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 869 veröffentlichten Paarvergleichen. | Höherer Messwert1.294,209 95-%-Konfidenzintervall: ±19,436Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.238,173 95-%-Konfidenzintervall: ±21,177Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Vision, Style ControlHumorTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Vision, style control GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Vision, style controlArena-Bewertung aus 869 veröffentlichten Paarvergleichen. | Gewinner1.296,35 95-%-Konfidenzintervall: ±21,068Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.238,173 95-%-Konfidenzintervall: ±21,177Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Vision, Style ControlOcrTestdetailsTestaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6, Harness: Arena Vision, style control GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 19.427 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 18.276 veröffentlichten Paarvergleichen. | Höherer Messwert1.312,247 95-%-Konfidenzintervall: ±6,33Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.262,843 95-%-Konfidenzintervall: ±6,292Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
LMArena Vision, Style ControlOcrTestdetailsKein dokumentierter Unterschied im TestaufbauVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserClaude Opus 4.6: Snapshot: claude-opus-4-6-high, Reasoning: high, Harness: Arena Vision, style control GPT-5.4 mini: Snapshot: gpt-5.4-mini-high, Reasoning: high, Harness: Arena Vision, style controlClaude Opus 4.6: Arena-Bewertung aus 15.929 veröffentlichten Paarvergleichen.GPT-5.4 mini: Arena-Bewertung aus 18.276 veröffentlichten Paarvergleichen. | Gewinner1.313,477 95-%-Konfidenzintervall: ±6,575Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | 1.262,843 95-%-Konfidenzintervall: ±6,292Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall, Arena-Bereich und Modellkonfiguration gehören zum Ergebnis. | LMArenaQuellendetailsDatenstand: 09.10.2026 |
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand | |||
Eigene Modelltests
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
Gemeinsame Testrunde: 43b8c5c46830
In dieser Runde nicht verfügbar
Community-Klassiker für eine freie SVG-Zeichnung.
Claude Opus 4.6
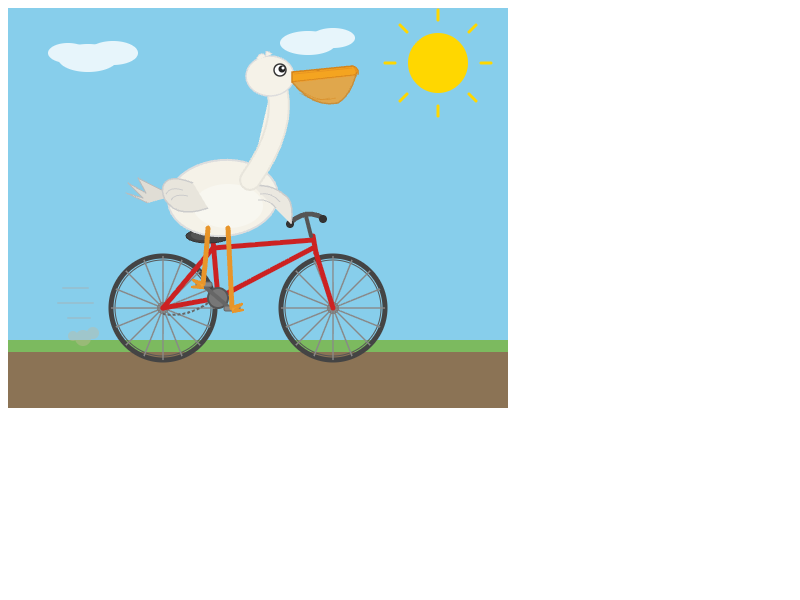
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
GPT-5.4 mini
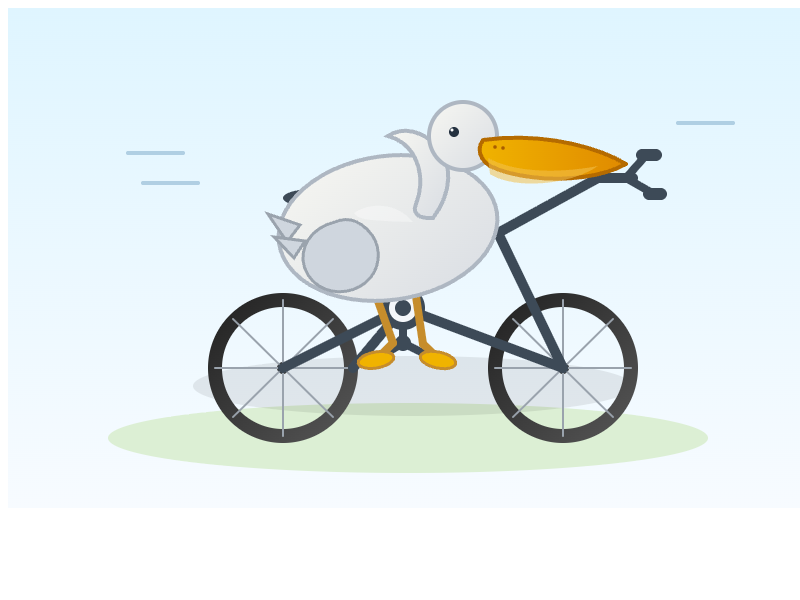
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)So liest du den Vergleich
Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.
Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.
Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.
Weitere Duelle
Vergleiche Claude Opus 4.6 und GPT-5.4 mini mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.