Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.
gemeinsame Messreihen
13
verschiedene Benchmarks
13
jüngster Abruf
29.09.2026
Modellauswahl ändern
Steckbrief
Allgemeine Daten
Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.
Allgemeine Daten von Claude Opus 4.5 und Claude Sonnet 4.5
Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.
API-Preise von Claude Opus 4.5 und Claude Sonnet 4.5
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Preise nach Anbieter
Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.
Anbieterpreise von Claude Opus 4.5 und Claude Sonnet 4.5
Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.
Fähigkeitsprofil aus vergleichbaren Benchmarks
Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.
Claude Opus 4.5
Claude Sonnet 4.5
Coding: 100 / 80 (1 Benchmarkfamilie)
Reasoning: 100 / 73,7 (1 Benchmarkfamilie)
Finanzen: 100 / 99,2 (1 Benchmarkfamilie)
Agenten-Aufgaben: 99 / 97,3 (2 Benchmarkfamilien)
Multimodal: 95,2 / 100 (1 Benchmarkfamilie)
Produktivität: 100 / 93,8 (1 Benchmarkfamilie)
Gesundheit: 99,2 / 94,9 (2 Benchmarkfamilien)
Bildung: 100 / 84,4 (2 Benchmarkfamilien)
11 passende Messreihen aus 11 Benchmarkfamilien wurden berücksichtigt. Das Radar zeigt 8 von 8 vergleichbaren Kategorien.
Claude Opus 4.5Claude Sonnet 4.5
Agent Poker BenchOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Opus 4.51.033,379 Bewertungspunkte
Claude Sonnet 4.5Gewinner1.055,504 Bewertungspunkte
BFCL v4Overall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Opus 4.5Gewinner77,47 %
Claude Sonnet 4.573,24 %
CORE-Bench HardAutomatic validation. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Opus 4.5Gewinner77,78 %
Claude Sonnet 4.562,22 %
CorpFin v2Overall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Opus 4.5Gewinner61,305 %
Claude Sonnet 4.560,8 %
MedCodeOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Opus 4.5Gewinner45,174 %
Claude Sonnet 4.540,569 %
MedScribeOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Opus 4.583,246 %
Claude Sonnet 4.5Gewinner84,515 %
MultiChallengeOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Opus 4.5Gewinner58,97 % ± 0,42
Claude Sonnet 4.555,32 % ± 1,47
MultiNRCOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Opus 4.5Gewinner48,63 % ± 3,02
Claude Sonnet 4.535,83 % ± 2,89
PRBench FinanceOverall. Mehr ist besser. Testaufbau nicht identisch dokumentiert
Claude Opus 4.5Höherer Messwert46,16 % ± 0,27
Claude Sonnet 4.543,79 % ± 0,4
PRBench LegalOverall. Mehr ist besser. Testaufbau nicht identisch dokumentiert
Claude Opus 4.5Höherer Messwert44,21 % ± 0,34
Claude Sonnet 4.540,84 % ± 0,4
SAGEOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Opus 4.5Gewinner45,002 %
Claude Sonnet 4.532,88 %
TutorBenchOverall. Mehr ist besser. Kein dokumentierter Setup-Unterschied
Claude Opus 4.5Gewinner51,2 % ± 0,99
Claude Sonnet 4.549 % ± 1,01
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Benchmarkwerte von Claude Opus 4.5 und Claude Sonnet 4.5
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: TrueSkill ratingBewertung: Mehr ist besserClaude Opus 4.5: Snapshot: claude-opus-4-5-20251101 Claude Sonnet 4.5: Snapshot: claude-sonnet-4-5-20250929
Kein dokumentierter Unterschied im TestaufbauVersion: v4, commit f7cf735Messgröße: unweighted overall accuracyBewertung: Mehr ist besserClaude Opus 4.5: Snapshot: claude-opus-4-5-20251101-fc Claude Sonnet 4.5: Snapshot: claude-sonnet-4-5-20250929-fcUngewichteter Gesamtscore aus agentischen, mehrstufigen und einzelnen Function-Calling-Tests.
Kein dokumentierter Unterschied im TestaufbauVersion: 45-paper public hard setMessgröße: automatic accuracyBewertung: Mehr ist besserEinstellungen: Agent: Claude Code, Harness: Claude CodeClaude Code auf 45 öffentlichen Paper-Reproduktionen. Kosten sind durch 45 geteilt.
Kein dokumentierter Unterschied im TestaufbauVersion: 2Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.5: Snapshot: claude-opus-4-5-20251101 Claude Sonnet 4.5: Snapshot: claude-sonnet-4-5-20250929
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.5: Snapshot: claude-opus-4-5-20251101 Claude Sonnet 4.5: Snapshot: claude-sonnet-4-5-20250929
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.5: Snapshot: claude-opus-4-5-20251101 Claude Sonnet 4.5: Snapshot: claude-sonnet-4-5-20250929
Kein dokumentierter Unterschied im TestaufbauVersion: four multi-turn challenge typesMessgröße: rubric pass rateBewertung: Mehr ist besserEinstellungen: Reasoning: thinking, Versuche: pass@1Mehrstufige Gespräche mit binären, aufgabenspezifischen Rubriken.
Kein dokumentierter Unterschied im TestaufbauVersion: French, Spanish, and Chinese releaseMessgröße: accuracyBewertung: Mehr ist besserEinstellungen: Reasoning: thinking, Versuche: pass@1Native, nicht aus dem Englischen übersetzte Reasoning-Aufgaben mit automatischer Bewertung.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: full finance setMessgröße: weighted rubric scoreBewertung: Mehr ist besserClaude Opus 4.5: Reasoning: thinking, Versuche: pass@1 Claude Sonnet 4.5: Versuche: pass@1600 Finanzaufgaben mit aufgabenspezifischen Rubriken und o4-mini als Juror.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: full legal setMessgröße: weighted rubric scoreBewertung: Mehr ist besserClaude Opus 4.5: Reasoning: thinking, Versuche: pass@1 Claude Sonnet 4.5: Versuche: pass@1500 Rechtsaufgaben mit aufgabenspezifischen Rubriken und o4-mini als Juror.
Kein dokumentierter Unterschied im TestaufbauVersion: 1Messgröße: accuracyBewertung: Mehr ist besserClaude Opus 4.5: Snapshot: claude-opus-4-5-20251101 Claude Sonnet 4.5: Snapshot: claude-sonnet-4-5-20250929
Kein dokumentierter Unterschied im TestaufbauVersion: 1,490-task releaseMessgröße: weighted rubric scoreBewertung: Mehr ist besserEinstellungen: Reasoning: thinking, Versuche: pass@11.490 Aufgaben mit gewichteten Rubriken und Claude 4 Sonnet als Juror.
Kein dokumentierter Unterschied im TestaufbauVersion: 758 private prompt-image pairsMessgröße: rubric scoreBewertung: Mehr ist besserEinstellungen: Reasoning: thinking, Versuche: pass@1758 einzelne Bild-Text-Aufgaben mit strukturierten Ja-Nein-Rubriken.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Eigene Modelltests
Unsere Tests
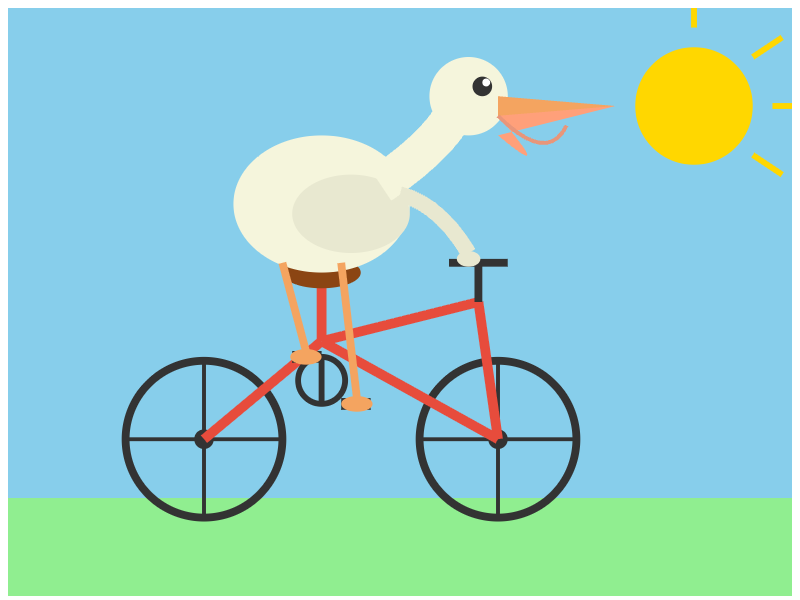
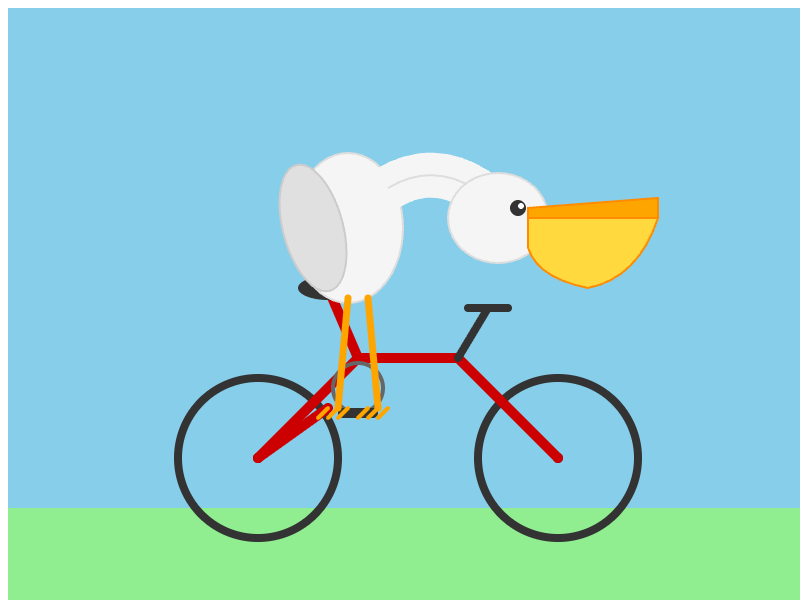
Vergleiche, wie die Modelle denselben Prompt umsetzen. Angezeigt wird jeweils der aktuellste Versuch, ohne nachträgliche Korrekturen am erzeugten Code. Frühere Läufe bleiben in den Testdetails erreichbar. Die Ergebnisse fließen nicht in einen Gesamtscore ein.
Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.
Claude Opus 4.5
Community-Klassiker für eine freie SVG-Zeichnung.
Reasoning (angefragt): high
Aktueller Versuch
Datum des Testlaufs
01.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
anthropic/claude-opus-4.5
API-Modell laut Antwort
anthropic/claude-opus-4.5
Reasoning-Einstellung
high
Festgelegter Endpunkt
Anthropic | anthropic/claude-4.5-opus-20251124
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung
Antwortzeit
21,6 s
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Claude Sonnet 4.5
Community-Klassiker für eine freie SVG-Zeichnung.
Reasoning (angefragt): high
Aktueller Versuch
Datum des Testlaufs
01.10.2026
API-Anbieter
openrouter
Angefragtes API-Modell
anthropic/claude-sonnet-4.5
API-Modell laut Antwort
anthropic/claude-sonnet-4.5
Reasoning-Einstellung
high
Festgelegter Endpunkt
Anthropic | anthropic/claude-4.5-sonnet-20250929
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung
Antwortzeit
30,2 s
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.
Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.
Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.
Weitere Duelle
Ähnliche LLM-Vergleiche
Vergleiche Claude Opus 4.5 und Claude Sonnet 4.5 mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.