Die eine Jev-Alternative gibt es nicht.
Zumindest keine, für die es mehr gibt als Versprechen der Hersteller. Für fast jede Aufgabe gibt es trotzdem eine sinnvolle Wahl.
Du nutzt Jev und suchst Ersatz, weil Datenschutz, deutscher Text oder Selbstbetrieb zählen? Die üblichen Listen sortieren nach Selbstbetrieb und GitHub-Sternen, gehostete Dienste und Deutsch fehlen fast immer. Mich hat genau das gestört, denn ich nutze Jev selbst in meinen KI-Agenten.
Jev von TypeSafe AI schreibt keinen Text. Es beantwortet Fragen zu einem Zustand, den du mitschickst, und wählt aus vorgegebenen Optionen. Mehr dazu steht in den Anwendungsfällen für Jev.
Grundlage ist eine Dokumentenrecherche zu über 50 Projekten. Keine der 37 Alternativen habe ich selbst getestet.
Nach dem Lesen weißt du, welche Alternative passt und wie du vor dem Wechsel auf eigenen Fällen testest.
- Einen Ersatz, der Jev überall schlägt, gibt es nicht.
- Der Preis allein trägt einen Wechsel selten. Die meisten gehosteten Dienste kosten zwischen 0,01 und 0,06 $ je Million Eingabetokens, Jev liegt mit 0,042 $ mittendrin.
- Teste vor dem Wechsel mit deinen eigenen Fällen, gegen höchstens drei Alternativen und ein unverändertes Basismodell.
Welche Jev-Alternative passt zu deiner Aufgabe?
Eine Alternative, die überall besser ist als Jev, kann ich dir nicht nennen.
Für jede Aufgabe ein Vertreter
Mit JevBench gibt es zwar eine unabhängige Rangliste, sie misst aber fremde Aufgaben und nicht deine. Darum bekommst du von mir keine Rangliste, dafür für jede typische Aufgabe einen Vertreter und meine Einschätzung dazu:
- Vertrauliche Daten und deutsche Texte: Privatemode Decisions. Hier würde ich zuerst hinschauen, weil der Anbieter als Einziger deutsche Zahlen und eine prüfbare Verarbeitung nennt.
- Großer Anbieter, kleiner Preis: Perplexity Decisions API, ab 0,01 $ je Million Eingabetokens.
- Azure-Vertrag und derselbe Preis wie Jev: Microsoft-Decision-1.
- Gehosteter Dienst, nah an Jev: milliseconds.ai deckt Auswahl, Bewertung und Extraktion ab.
- Schwierige Fälle mit zusätzlichem Nachdenken: Fastino GLiDE, inzwischen günstiger als Jev.
- Deine Daten liegen in Databricks: ai_decide, direkt per SQL.
- Beste Werte im unabhängigen JevBench: kettei von Sqwish.
- Gute Mischung aus Qualität, Preis und offenen Gewichten: Super Decider.
- Bildentscheidungen mit dem TypeSafe-SDK: Drex Max.
- Sehr lange Eingaben wie Protokolle oder Repositories: SubQ Snap.
- Solide Mitte ohne Warteliste: Bespoke Nimble.
- Der niedrigste Preis je Entscheidung: Myles-G von Launchables, abgerechnet in Pfund.
- Klare Datenschutzzusage und zusätzliche Fragetypen: Levanto Sage.
- Viele offene Modelle per API ausprobieren: Codiv, solange du es als Experiment behandelst.
- Günstig experimentieren, mit Einladung: Djev, mit einigen Vorbehalten.
- Schon im OpenAI-Ökosystem: die Decisions API von OpenAI, zum mehr als doppelten Jev-Preis.
- Jev-Integration behalten, gehostet und schneller: Cloudflare Clef, mit offenen Gewichten für später.
- Große GPU, Bilder und sehr langer Kontext: Surogate Rune.
- Jev-Schnittstelle behalten und selbst betreiben: Kev, wahlweise auch über OpenRouter. Das wäre mein pragmatischer Weg.
- Kleiner Jev-kompatibler Server auf einer GPU: Lev, für englische Fälle.
- Deutsche Aufgaben auf eigener Hardware: Standard One nennt Deutsch unter den Trainingssprachen.
- Entscheidungen auf Edge-Geräten: Liquid d1-3B, wenn die Lizenz zu deinem Umsatz passt.
- Viele Optionen mit gemeinsamem Kontext: Mapika Decider erlaubt bis zu 255 Optionen je Frage.
- Englisch auf einer einzelnen GPU: JevK5 mit Jev-Schnittstelle.
- Lokal auf dem Laptop experimentieren: Strands Decider 2B.
- Jev auf eigener großer GPU nachbilden: AutoTrust JEV-27B.
- Kleines offenes Modell mit Apache-Lizenz und Server: H2O-Lightning-4B.
- Kleines Modell mit dem besten JevBench-Composite: Torchcast Decision 4B.
- Große GPU, Englisch oder Vietnamesisch: Quyet-1.0-Large.
- Unverändertes Basismodell als eigener Server: Decisio.
- Mehrere Fragen über denselben Text oder dieselben Bilder: Intern-Decision.
- Prüfen, ob ein unverändertes Basismodell reicht: Cygnet. Damit würde ich jeden Test beginnen.
- Wahrscheinlichkeiten direkt aus einem Basismodell lesen: SemIf.
- Eine Entscheidung dauerhaft gleich treffen: AnyJev, wenn du geprüfte Beispiele sammelst.
- Feste deutsche Kategorien mit eigenen Beispielen: SetFit.
- Wechselnde Kategorien ohne Trainingsdaten: GLiClass.
- Felder und Entitäten statt Urteile: GLiNER2.5.
Wie unterschiedlich die 37 wirklich sind, siehst du am besten nebeneinander. Achte dabei auf die Spalte zu Deutsch. Bei den meisten steht dort „Unbekannt“.
Alle 37 Jev-Alternativen auf einen Blick
Die Tabelle hat Lücken, und die sind Absicht.
Wo der Anbieter nichts dazu sagt, steht „k. A.“ oder „Unbekannt“ in der Zelle.
Oben steht Jev als Referenz, darunter die 37 Alternativen. Du kannst nach jeder Spalte sortieren und nach Kategorie filtern.
| Jev | API | Gehostet | 0,042 $/Mio. | Englisch primär | Keine Angabe in der Quelle | Referenz | Keine Angabe in der Quelle |
| Privatemode Decisions | API + Proxy | Gehostet | 0,20 €/Mio. | Ja | MIT | Nein | Keine Angabe in der Quelle |
| Perplexity Decisions API | API + Modell | Gehostet / Selbst | ab 0,01 $/Mio. | Unbekannt | Apache-2.0 | Nein | Keine Angabe in der Quelle |
| Microsoft-Decision-1 | API | Azure / OpenRouter | 0,042 $/Mio. | Unbekannt | Kommerziell | Teilweise | Keine Angabe in der Quelle |
| milliseconds.ai | API | Gehostet | 0,04 $/Mio. | Unbekannt | Kommerziell | Teilweise | Keine Angabe in der Quelle |
| Fastino GLiDE | API | Gehostet | 0,04 $/Mio. | Unbekannt | Kommerziell | Teilweise | Keine Angabe in der Quelle |
| Databricks ai_decide | SQL + API | In Databricks | Keine Angabe in der Quelle | Unbekannt | Kommerziell | Ja | Beta |
| Sqwish kettei | API | Gehostet | ab 0,02 $/Mio. | Unbekannt | Kommerziell | Ja | Keine Angabe in der Quelle |
| Super Decider | API + Modell | Gehostet / Selbst | 0,03 $/Mio. | Unbekannt | Apache-2.0 | Ja | Keine Angabe in der Quelle |
| Drex Max | API | Gehostet | 0,06 $/Mio. | Unbekannt | Kommerziell | Ja | Keine Angabe in der Quelle |
| SubQ Snap | API | Gehostet | 0,04 $/Mio. | Unbekannt | Kommerziell | Teilweise | Preview |
| Bespoke Nimble | API + Modell | Gehostet / Selbst | 0,04 $/Mio. | Unbekannt | CC BY-NC 4.0 | Ja | Keine Angabe in der Quelle |
| Launchables Myles-G | API | Gehostet (Kanada) | ab 0,0015 £/Mio. | Unbekannt | Kommerziell | Ja | Keine Angabe in der Quelle |
| Levanto Sage | API | Gehostet | ab 0,038 $/Mio. | Unbekannt | Kommerziell | Ja | Keine Angabe in der Quelle |
| Codiv | Plattform | Gehostet | Kostenlos | Unbekannt | Apache-2.0 | Ja | Experiment |
| Djev | API | Gehostet, Einladung | 0,035 $/Mio. | Unbekannt | Apache-2.0 (Code) | Nein | Preview |
| OpenAI Decisions API | API | Gehostet | 0,10 $/Mio. | Unbekannt | Kommerziell | Nein | Keine Angabe in der Quelle |
| Cloudflare Clef | Modelle + API | Gehostet / Selbst | ab 0,038 $/Mio. | Unbekannt | Apache-2.0 | Ja | Keine Angabe in der Quelle |
| Surogate Rune | Modell | Selbst (96 GB) | Open Source | Unbekannt | Apache-2.0 | Teilweise | Keine Angabe in der Quelle |
| Kev | Modell | Selbst / OpenRouter | Open Source | Unbekannt | Apache-2.0 | Ja | Keine Angabe in der Quelle |
| Lev | Adapter | Selbst (1 GPU) | Open Source | Nein | Apache-2.0 | Ja | Keine Angabe in der Quelle |
| Standard One | Modell | Selbst (SGLang) | Open Source | Ja | Apache-2.0 | Ja | Keine Angabe in der Quelle |
| Liquid d1 | API + Modelle | Gehostet / Selbst | 0,04 $/Mio. | Ja | LFM 1.0 | Teilweise | Keine Angabe in der Quelle |
| Mapika Decider | Modelle | Selbst | Open Source | Unbekannt | Apache-2.0 | Ja | Keine Angabe in der Quelle |
| JevK5 | Modell | Selbst (1 GPU) | Open Source | Nein | Apache-2.0 | Ja | Keine Angabe in der Quelle |
| Strands Decider | Adapter | Selbst (CPU, GPU) | Open Source | Unbekannt | Apache-2.0 | Teilweise | Keine Angabe in der Quelle |
| AutoTrust JEV-27B | Modell | Selbst (große GPU) | Open Source | Unbekannt | Apache-2.0 | Nein | Keine Angabe in der Quelle |
| H2O-Lightning | Modelle | Selbst (48 GB) | Open Source | Unbekannt | Apache-2.0 | Teilweise | Keine Angabe in der Quelle |
| Torchcast Decision | Modell | Selbst (1 GPU) | Open Source | Unbekannt | Apache-2.0 | Ja | Keine Angabe in der Quelle |
| Quyet-1.0 | Modelle | Selbst (80 GB) | Open Source | Unbekannt | Apache-2.0 | Teilweise | Keine Angabe in der Quelle |
| Decisio | Server | Selbst (GPU, Mac) | Open Source | Unbekannt | Apache-2.0 | Ja | Keine Angabe in der Quelle |
| Intern-Decision | Modell | Selbst (Bibliothek) | Open Source | Unbekannt | Apache-2.0 | Nein | Keine Angabe in der Quelle |
| Cygnet | Framework | Selbst (vLLM) | Open Source | Unbekannt | MIT | Teilweise | Keine Angabe in der Quelle |
| SemIf | Framework | Selbst / Browser | Open Source | Unbekannt | MIT | Keine Angabe in der Quelle | Forschung |
| AnyJev | Bibliothek | Selbst (vLLM) | Open Source | Unbekannt | Apache-2.0 | Nein | Forschung |
| SetFit | Framework | Selbst trainieren | Open Source | Teilweise | Apache-2.0 | Nein | Keine Angabe in der Quelle |
| GLiClass | Klassifikator | Selbst | Open Source | Unbekannt | Apache-2.0 | Nein | Keine Angabe in der Quelle |
| GLiNER2.5 | Extraktion | Selbst (CPU, GPU) | Open Source | Teilweise | Apache-2.0 | Nein | Keine Angabe in der Quelle |





Was der unabhängige JevBench zeigt
JevBench von Benchmark Heaven misst Entscheidungsmodelle auf denselben Aufgaben. Capability ist der Mittelwert aus Intelligenz und Kalibrierung. Die Grafik zeigt die gehosteten Dienste aus dieser Liste, die dort gemessen sind.
 gradually.ai
Zwei Dinge fallen auf. Mehrere neue Dienste liegen klar vor Jev, und Jev 1.14 schneidet etwas schlechter ab als die Vorversion 1.13.
Bevor es an die einzelnen Alternativen geht, sage ich dir, woher meine Meinung kommt. Sie hat mit meinen eigenen Agenten zu tun.
Warum ich Jev selbst nutze, und was ich von einem Ersatz erwarte
Ich nutze Jev nicht als Entscheider, sondern als zusätzliche, beratende Einschätzung.
In meinen eigenen KI-Agenten läuft Jev an mehreren Stellen mit, zum Beispiel hier:
- Faktencheck für Content: Bei Newsletter-Entwürfen prüft zuerst ein festes Skript Zahlen und Quellenangaben. Zusätzlich vergleicht Jev eine verlinkte Behauptung mit einem lokal gespeicherten Snapshot der Quelle, aber nur, wenn die Adresse exakt passt. Gibt die Quelle zu wenig her, lautet das Ergebnis „reicht nicht für ein Urteil“ statt „stimmt nicht“.
- E-Mail-Agent: Beim Sortieren meines Postfachs bekommt Jev einen kurzen Auszug. Daraus schätzt es ein, ob eine Mail eine persönliche Antwort verlangt, eine konkrete Frist nennt oder ein allgemeiner Werbe-Pitch ist.
- Meeting-Digest: Jev prüft, ob eine Zusage aus einer Meeting-Zusammenfassung im Transkript an genau dieser Zeitmarke gedeckt ist.
- Executor-Agent: Bei der Abnahme einer Aufgabe geht Jev jedes Kriterium unter „Fertig wenn“ durch. Es prüft, ob das Kriterium erfüllt, nicht nachgewiesen oder widerlegt ist.
Überall gilt dieselbe Regel. Jev liefert einen Hinweis, entschieden wird anderswo, beim Faktencheck, im Meeting-Digest und beim Executor sogar von festen Prüfungen. Feste Konfidenzschwellen zwischen 0,75 und 0,80 bestimmen, ob ein Punkt zur Prüfung markiert wird.
Meine Maßstäbe für einen Ersatz
Daraus ergeben sich meine Maßstäbe für eine Alternative. Ich frage nicht zuerst nach dem besten Benchmark. Ich frage, ob die Schnittstelle bleibt und ob ich der Konfidenz trauen kann.
Und ich frage, ob die Kosten bei vielen kleinen Anfragen nicht ins Gewicht fallen. Für jede Alternative unten sage ich dir, wie sie bei diesen Fragen abschneidet, soweit die Anbieter etwas dazu sagen.
Mit diesem Maßstab gehe ich jetzt die 37 Alternativen durch, sortiert in vier Gruppen. Los geht es mit 17 gehosteten Diensten, bei denen du nichts betreiben musst. Nur einer davon hat deutsche Zahlen.
1. Privatemode Decisions
Privatemode Decisions kommt von Edgeless Systems und ist eine Jev-Alternative für alle, die vertrauliche Daten oder deutsche Texte verarbeiten. Die Bibliothek arbeitet mit einem lokalen Proxy, darunter läuft GLM-5.3-Flash. Ein nachtrainiertes Jev-Modell steckt nicht drin.
Die Eingabe kostet laut Anbieter 0,20 € je Million Tokens, die Ausgabe 0,65 €, jeweils zuzüglich Umsatzsteuer. Beim Datenschutz beschreibt der Anbieter Ende-zu-Ende-Verschlüsselung und eine Attestierung der Verarbeitung.
Als einziger Anbieter nennt Privatemode deutsche Zahlen, deshalb würde ich hier zuerst hinschauen. Was mich stört, ist, dass alle Zahlen vom Anbieter selbst stammen. Externe Benchmarks gibt es nicht. Ich würde sie mit meinen eigenen Fällen nachprüfen, bevor ich etwas umbaue.
- Der Anbieter veröffentlicht einen Benchmark mit fünf deutschen Datensätzen. Auf 28 gemeinsam beantwortbaren Datensätzen fand er keinen signifikanten Genauigkeitsunterschied zu Jev.
- Die Ausführung ist laut Anbieter Ende-zu-Ende verschlüsselt, und die Attestierung der Umgebung wird vor dem Senden geprüft.
- Bis zu 191 Optionen je Frage, bis zu 1 Mio. Tokens Kontext und Bilder neben dem Text sind dokumentiert.
- Der Anbieter nennt rund 150 ms je Entscheidung inklusive Netz. Ein Anbieterlauf aus Deutschland maß im Median 180 ms gegenüber 264 ms für Jev.
- Die Bibliothek nutzt einen eigenen Client und ist kein Ersatz für das unveränderte TypeSafe-SDK.
- Bei mehr als 128 auszulesenden Wahrscheinlichkeiten sind mehrere API-Anfragen nötig.
- Eine Option „keine dieser Optionen“ musst du selbst vorsehen.
- Benchmark, Latenz und Sicherheitsbeschreibung stammen alle vom Anbieter, ein unabhängiges Audit gibt es nicht.
2. Perplexity Decisions API
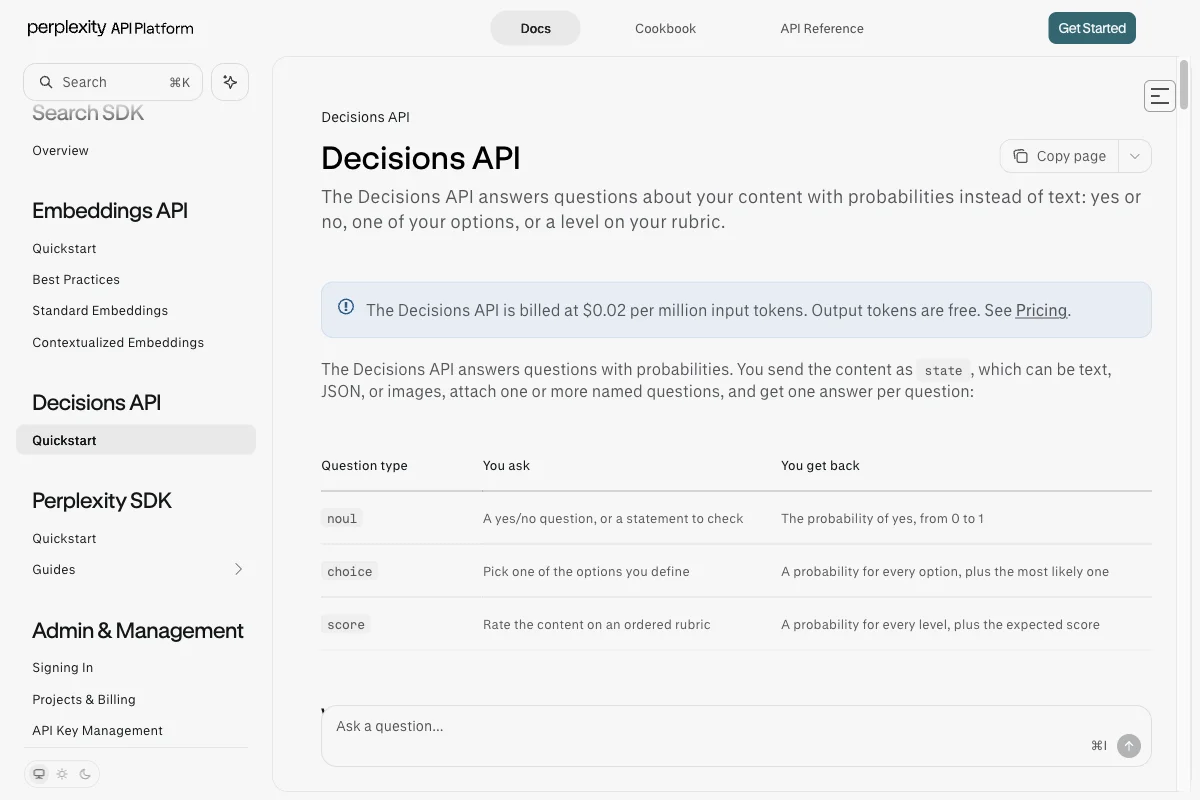
Die Perplexity Decisions API ist ein gehosteter Entscheidungsdienst von Perplexity und eine der günstigsten Jev-Alternativen in dieser Liste. Aktuell laufen dort pplx-decider-v1.2 und die schnellere Variante pplx-decider-flash-v1.2.
Laut Dokumentation kostet pplx-decider-v1.2 0,02 $ und die Flash-Variante 0,01 $ je Million Eingabetokens, die Ausgabe ist kostenlos. Das ist weniger als die Hälfte beziehungsweise rund ein Viertel des Jev-Preises. Die Gewichte von Version 1.1 stellt Perplexity zusätzlich unter Apache-2.0 auf Hugging Face, Basis ist Qwen3.8-27B.
Zählt bei vielen kleinen Anfragen jeder Cent, würde ich hier zuerst testen. Was mich bremst, ist der eigene Endpunkt statt der Jev-Schnittstelle. Zu Deutsch und zum Umgang mit deinen Daten sagt die Dokumentation außerdem nichts.
- Die Eingabe kostet 0,02 $ (v1.2) oder 0,01 $ (Flash) je Million Tokens, die Ausgabe ist kostenlos, und eine Gebühr je Anfrage gibt es nicht.
- Je Frage sind unter 256.000 Eingabetokens erlaubt, Choice erlaubt bis zu 255 Optionen.
- Als Zustand gehen Text, JSON und Bilder.
- Perplexity nennt für v1.1 einen Decision-Index-Wert von 61,56 gegenüber 57,9 für Jev (Herstellerangabe).
- Der Endpunkt POST /v1/decisions ist nicht die Jev-Schnittstelle, ein TypeSafe-Client läuft nicht unverändert.
- Score erlaubt nur 1 bis 10 Stufen.
- Jede Organisation darf 10 Anfragen pro Sekunde stellen.
- Zu Deutsch, Speicherung und Training mit Kundendaten sagt die Dokumentation nichts.
3. Microsoft-Decision-1
Microsoft-Decision-1 kommt von Microsoft und ist eine Jev-Alternative für alle, die ohnehin mit Azure arbeiten. Das Modell ist seit dem 9. Oktober 2026 in Microsoft Foundry und über OpenRouter verfügbar. Laut Microsoft basiert es auf einem nachtrainierten Qwen3.5-9B.
Der Preis ist mit 0,042 $ je Million Eingabetokens derselbe wie bei Jev, die Ausgabe ist kostenlos. In Foundry heißt der Endpunkt /v1/systemone, und die Dokumentation nennt das Anfrageschema ähnlich zu einer System-One-API. Mit dem Bereitstellungstyp DataZoneStandard bleibt die Verarbeitung laut Microsoft in der gewählten Datenzone.
Für Teams mit Azure-Vertrag ist das der bequemste Weg zu einem Jev-ähnlichen Dienst. Die Bestwerte bei Genauigkeit und Geschwindigkeit stammen allerdings aus Microsofts eigenem Vergleich.
- Der Preis ist derselbe wie bei Jev (0,042 $ je Million Eingabetokens), die Ausgabe ist kostenlos.
- Mit DataZoneStandard bleibt die Verarbeitung laut Microsoft innerhalb der gewählten Datenzone.
- Neben Foundry ist das Modell auch über OpenRouter erreichbar.
- Microsoft nennt 1,3 % geänderte Entscheidungen bei leicht veränderten Eingaben (Herstellerangabe).
- Microsoft beschreibt die Schnittstelle als ähnlich zu einer System-One-API, eine ausdrückliche Jev-Kompatibilität nennt Microsoft nicht.
- OpenRouter nennt 33 Tsd. Tokens Kontext, Grenzen für Optionen und Fragen nennt Microsoft nicht.
- Gewichte gibt es nicht, und Microsoft will das Modell künftig auf eigene und OpenAI-Modelle umstellen.
- Zu Deutsch sagt Microsoft nichts, die Ankündigung spricht nur von mehrsprachigen Aufgaben.
4. milliseconds.ai
milliseconds.ai ist ein gehosteter Entscheidungsdienst und vor allem für alle interessant, die erst einmal kostenlos ausprobieren wollen. Das Modell decision-machine-1 kommt dem Umfang von Jev nahe. Es beantwortet laut Anbieter Ja-Nein-Fragen, klassifiziert, bewertet und zieht Felder aus Text und Bildern.
Die Eingabe kostet 0,04 $ je Million Tokens, die Ausgabe ist frei. Für die Produktion kaufst du Guthaben ab 10 $, damit schaltest du Produktionsschlüssel frei. Gegenüber Jev mit 0,042 $ ist der Preisabstand klein und für sich kein Wechselgrund.
Ich würde milliseconds.ai als gehosteten Vergleich nehmen, allein wegen des großzügigen Testschlüssels. Ob deutscher Text gut klappt, kann ich dir nicht sagen, dazu gibt es schlicht keine Zahlen.
- Ein Modell deckt Ja-Nein-Fragen, Klassifikation, Bewertung, Antworten aus Quellen, Extraktion, Entitäten und Verifikation ab.
- Testschlüssel bekommen 125 Mio. freie Eingabetokens im Monat, erneuert monatlich.
- Text und Bilder werden verarbeitet.
- Die Ausgabe ist kostenlos, und freie Testtokens werden nach Angaben des Anbieters nicht vom Produktionsverbrauch abgezogen.
- Testschlüssel sind auf 30 Inferenzanfragen pro Minute begrenzt.
- Die API ist funktional Jev-nah, aber kein bloßer Tausch der Serveradresse.
- Die Bildextraktion nutzt einen generativen Pass, höchstens 5 Felder je Extract-Aufruf.
- Freier Zugang und Betafunktionen tragen laut Bedingungen keine allgemeine Verfügbarkeitszusage.
5. Fastino GLiDE
GLiDE kommt von Fastino Labs und ist ein gehostetes Entscheidungsmodell für alle, die bei schwierigen Fällen mehr Genauigkeit wollen. Es startet laut Fastino mit einer schnellen Einschätzung und denkt bei Unsicherheit zusätzlich nach. Verfügbar ist es über die Fastino API.
Die Eingabe kostet laut Preisliste 0,04 $ je Million Tokens, die Ausgabe ist kostenlos. GLiDE nutzt dieselbe System-One-Struktur wie Jev. Der Wechsel ist aber kein reiner Austausch, denn Basis-URL und Modellname unterscheiden sich.
GLiDE würde ich testen, wenn Jev bei kniffligen Fragen danebenliegt. Mit 0,04 $ kostet es inzwischen etwas weniger als Jev, und im unabhängigen JevBench 1.8.2 liegt die gehostete API mit 84,5 Capability-Punkten klar vor Jev 1.14.
- Bei Unsicherheit rechnet das Modell laut Fastino zusätzlich nach, statt sofort zu antworten.
- Die Anfragestruktur entspricht der von Jev (POST /v1/systemone).
- Choice erlaubt 2 bis 255 Optionen, Score bis zu 255 Stufen.
- Fastino nennt 64,81 Punkte im Decision Index gegenüber 57,91 für Jev (eigener Lauf).
- Kein direkter Ersatz, nötig sind eine andere Basis-URL und ein eigener Modellname.
- Zustand plus eine Frage dürfen höchstens 40.000 Tokens umfassen.
- Gewichte, Modellgröße und Angaben zu Deutsch fehlen.
6. Databricks ai_decide
ai_decide kommt von Databricks und ist eine Jev-Alternative für alle, deren Daten ohnehin in Databricks liegen. Die Funktion ist seit dem 30. September 2026 als Beta verfügbar. Sie läuft per SQL direkt auf Tabellen oder über eine REST-API für Echtzeitanwendungen.
Laut Databricks ist ai_decide direkt kompatibel mit der TypeSafe-API. Einen eigenen Preis je Million Tokens nennt die Dokumentation nicht, sie verweist auf die SQL-Preise von Databricks. Welches Modell darunter läuft, verrät Databricks ebenfalls nicht.
Außerhalb von Databricks ergibt ai_decide keinen Sinn. Wer dort aber Tickets, Dokumente oder Agenten-Ergebnisse in großen Mengen bewerten will, spart sich einen externen Dienst.
- Entscheidungen laufen per SQL direkt auf den Daten, ohne Export zu einem externen Dienst.
- Laut Databricks ist die Funktion direkt kompatibel mit der TypeSafe-API.
- Choice erlaubt 1 bis 255 Optionen, Score 2 bis 10 Stufen.
- Databricks speichert laut Dokumentation die übergebenen Parameter nicht, nur Metadaten des Laufs.
- Die Funktion gibt es nur innerhalb von Databricks und nur in einigen Regionen.
- Es ist eine Beta, und Antworten können laut Dokumentation zwischen Aufrufen schwanken.
- Einen Preis je Million Tokens gibt es nicht, abgerechnet wird über die Databricks-Preise.
- Das Modell darunter nennt Databricks nicht und behält sich vor, es zu wechseln.
7. Sqwish kettei
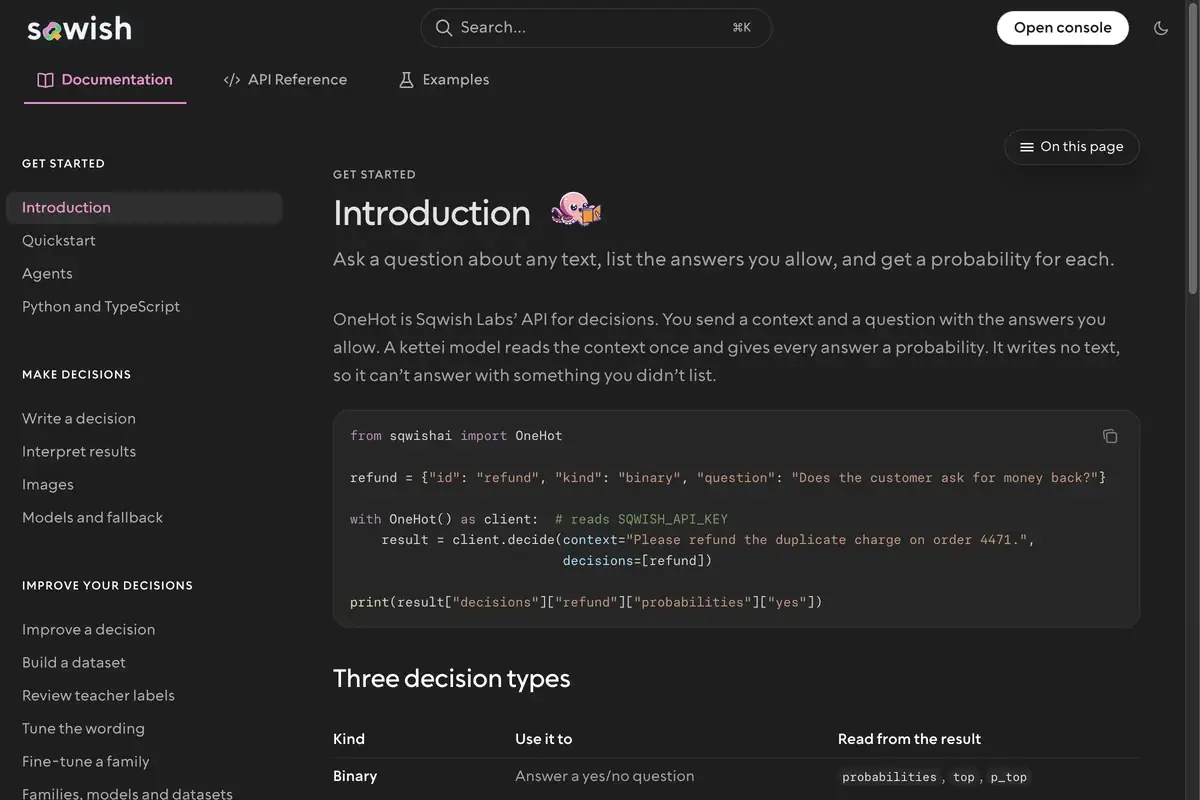
kettei kommt von Sqwish Labs aus Cambridge und ist eine Jev-Alternative für alle, die die Jev-Schnittstelle behalten und mehr Genauigkeit wollen. Die Modelle kettei-fat und kettei-chub laufen seit dem 14. Oktober 2026 über die API OneHot, dazu kommt das kleinere kettei-core.
Laut Preisliste kostet kettei-fat 0,06 $ je Million Eingabetokens, kettei-chub 0,04 $ und kettei-core 0,02 $. Ausgaben sind kostenlos, neue Konten bekommen 5 $ Startguthaben, das 30 Tage gültig ist. Pfad und Anfrageform von /v1/systemone bleiben laut Migrationsanleitung gleich, geändert werden Basis-URL, Schlüssel und Modellname.
kettei-fat wäre mein erster Test, wenn Jev bei kniffligen Fragen zu oft danebenliegt, denn im unabhängigen JevBench führt es die gehosteten Dienste an. Bremsen würde mich, dass neue Konten auf einer Warteliste landen können und Sqwish zu Sprachen nichts sagt.
- Laut Migrationsanleitung bleiben Pfad und Anfrageform von /v1/systemone gleich, nötig sind nur neue Basis-URL, neuer Schlüssel und ein kettei-Modellname.
- Im JevBench 1.8.2 erreicht kettei-fat 86,3 Capability-Punkte, Jev 1.14 kommt auf 75,0.
- Eine Anfrage darf bis zu 65.536 Eingabetokens enthalten, fat und chub lesen auch Bilder.
- Laut Sqwish werden Daten nicht zum Training der Modelle für andere Kunden verwendet. Mit Zero Data Retention (Zusatzvereinbarung) werden Inhalte nach der Antwort nicht gespeichert, sonst bleiben Antworten mit Idempotency-Key 24 Stunden verschlüsselt erhalten.
- Mit 0,06 $ je Million Eingabetokens ist kettei-fat teurer als Jev.
- Neue Konten können laut Dokumentation auf einer Warteliste landen.
- Sqwish betont selbst, dass gleiche Form nicht gleiche Genauigkeit oder Latenz bedeutet.
- Zu Sprachen sagt Sqwish nichts, und die GPUs stehen nur bevorzugt in Europa.
8. Super Decider
Super Decider kommt von Singularity Compute und ist ein Entscheidungsmodell für alle, die eine gehostete API mit offenen Gewichten wollen. Es basiert auf DiffusionGemma mit 26B Parametern, von denen 4B aktiv sind, und steht unter Apache-2.0 auf Hugging Face.
Die gehostete API kostet laut Readme 0,03 $ je Million Eingabetokens, Ausgaben sind kostenlos. Für den Wechsel von Jev genügen laut Hersteller eine neue URL und ein neuer Modellname. Im JevBench hat Super Decider den besten Composite-Wert aller gehosteten Dienste, also die beste Mischung aus Qualität, Kalibrierung, Tempo und Preis.
Für mehrstufige Fragen lässt sich laut Produktseite ein Thinking-Modus zuschalten. Das Modell schreibt dann zuerst einen kurzen Gedanken. Im JevBench steigt die Capability damit auf 85,9 Punkte, der Composite sinkt aber auf 74,5, weil die Antworten länger dauern.
Für mich ist Super Decider der interessanteste Neuzugang. Er ist günstiger als Jev, liegt im unabhängigen Benchmark vorn und lässt sich später selbst betreiben. API-Schlüssel gibt es allerdings nur über ASI:Cloud oder per Mail, und zum Datenschutz der API habe ich keine Angaben gefunden.
- Laut Readme genügen für den Wechsel von Jev eine neue URL und ein neuer Modellname.
- Im JevBench 1.8.2 erreicht es 84,9 Capability- und 78,5 Composite-Punkte, beides deutlich vor Jev 1.14.
- Eine Anfrage darf bis zu 64 Fragen, 131.072 Tokens und acht Bilder enthalten.
- Die Gewichte stehen unter Apache-2.0 und laufen laut Modellkarte auf einer 48-GB-GPU.
- API-Schlüssel gibt es über ASI:Cloud oder per Mail an den Hersteller, nicht über eine eigene Konsole.
- Laut Readme können sich Antworten ändern, wenn sich nur die Reihenfolge von JSON-Schlüsseln oder Optionen ändert.
- Bei mehrstufigen Datums- und Geldrechnungen liegt es laut Hersteller manchmal mit hoher Sicherheit falsch.
- Englisch ist die Hauptsprache, und zum Datenschutz der API fehlen Angaben.
9. Drex Max
Drex Max kommt von Nace.AI und ist das genaueste Modell der Drex-Familie, gedacht für Entscheidungen über Text und Bilder. Es steht seit dem 13. Oktober 2026 in der Modellliste und ist das einzige Drex-Modell, das Bilder liest.
Drex Max v1.1 kostet laut Dokumentation 0,03 $ je Million Eingabetokens, Ausgaben sind kostenlos. Die ursprüngliche Kennung von Drex Max wird auf diese Version umgeleitet, abgerechnet wird nach deren Preis. Laut Migrationsanleitung ist Drex mit Jev wire-kompatibel, das TypeSafe-SDK läuft ohne Fork gegen die Nace-API. Ändern musst du den Modellnamen.
Drex Max würde ich bei Bildentscheidungen in die engere Wahl nehmen. Bei den Limits je Anfrage liegt es mit 512 Fragen und höchstens 4 MiB im oberen Bereich.
- Laut Nace läuft das TypeSafe-SDK ohne Fork gegen die Drex-API.
- Im JevBench 1.8.2 erreichte die ursprüngliche Max-Version 84,2 Capability-Punkte.
- Pro Anfrage gehen bis zu acht Bilder.
- Choice erlaubt bis zu 255 Optionen.
- Die ursprüngliche Max-Kennung leitet laut Dokumentation auf Max v1.1 um, die Antwort nennt das Nachfolgemodell.
- Eine Anfrage darf bis zu 512 Fragen enthalten.
- Langen Zustand kürzt Drex Max laut Dokumentation vor der Auswertung.
- Zur Speicherung von Entscheidungsanfragen und zu Sprachen sagt die Dokumentation nichts Konkretes.
10. SubQ Snap
SubQ Snap kommt von Subquadratic und ist ein Entscheidungsmodell für sehr lange Eingaben. Version 1.1 erschien am 22. Oktober 2026 als öffentliche Vorschau und liest bis zu 384.000 Tokens.
Die Eingabe kostet 0,04 $ je Million Tokens, Ausgaben sind kostenlos, und neue Konten bekommen 100 Millionen Tokens geschenkt. Der Endpunkt heißt laut Dokumentation wie bei Jev /v1/systemone, eine ausdrückliche Kompatibilitätszusage macht SubQ aber nicht.
Wenn deine Zustände ganze Repositories oder lange Protokolle sind, kommt an SubQ Snap kaum ein anderer Dienst heran. Für kurze Fragen bringt der lange Kontext dagegen wenig.
- Der Kontext umfasst 393.216 Tokens.
- Neue Konten bekommen 100 Millionen Tokens kostenlos.
- Eine Anfrage darf bis zu 128 Fragen enthalten, Choice erlaubt 2 bis 255 Optionen.
- Im JevBench 1.8.2 erreicht Snap 1.1 81,9 Capability-Punkte.
- Es ist eine öffentliche Vorschau.
- Eine ausdrückliche Jev-Kompatibilität nennt SubQ nicht.
- Ein- und Ausgaben werden laut Dokumentation bis zu 60 Tage gespeichert, Zero Data Retention gibt es nur auf Anfrage.
- Beim Benchmark PhishNChips liegt Jev 1.14 laut SubQ selbst deutlich vorn.
11. Bespoke Nimble
Nimble kommt von Bespoke Labs und ist eine Modellfamilie für Klassifikation, Routing und Bewertung. Das aktuelle Modell nimble-v4.1-max (seit dem 5. November 2026 der Standard, nimble-v4-max läuft weiter) läuft über die Bespoke-API und liegt zusätzlich als Gewichte auf Hugging Face.
Die Eingabe kostet 0,04 $ je Million Tokens, Ausgaben sind kostenlos, und neue Konten bekommen 1 $ Startguthaben. Der Endpunkt heißt /v1/systemone, und die Dokumentation erklärt, wie du Nimble mit dem TypeSafe-SDK aus Python ansprichst. Die offenen Gewichte stehen allerdings unter CC BY-NC 4.0 und sind damit nicht für kommerzielle Nutzung freigegeben.
Nimble ist für mich die solide Mitte. Etwas günstiger als Jev, im JevBench klar davor und ohne Warteliste. Wer selbst hosten will, scheitert aber an der Lizenz.
- Die Dokumentation zeigt, wie du Nimble mit dem TypeSafe-SDK ansprichst.
- Im JevBench 1.8.2 erreicht nimble-v4-max 79,7 Capability- und 74,8 Composite-Punkte.
- Eine Anfrage darf bis zu 64 Fragen enthalten, pro Frage bis zu 256.000 Tokens.
- Ein festes Limit pro Minute gibt es nicht, nur eine Grenze für parallele Anfragen.
- Die offenen Gewichte stehen unter CC BY-NC 4.0, kommerzieller Selbstbetrieb ist damit ausgeschlossen.
- Bilder unterstützt die API laut Dokumentation nicht.
- Bis zum ersten Kauf von Guthaben laufen höchstens vier Anfragen parallel.
- Zu Datenschutz, Speicherung und Sprachen sagt die Dokumentation nichts.
12. Launchables Myles-G
Myles-G kommt von Launchables aus Großbritannien und ist eine Jev-Alternative für alle, bei denen der Preis zählt. Myles-G 31B ist seit dem 19. Oktober 2026 für alle verfügbar, dazu kommt die kleinere 12B-Variante.
Laut Preisliste kostet Myles-G 31B 0,005 £ und Myles-G 12B 0,0015 £ je Million Eingabetokens, zuzüglich britischer Umsatzsteuer. Ausgaben sind kostenlos. Das ist ein Bruchteil des Jev-Preises. Unter /v1/systemone nimmt die API laut Dokumentation dieselben Anfragen an wie unter /v1/decide, bestehende Clients laufen also weiter.
Der Preis ist so niedrig, dass ich ihn vor einem Einsatz noch einmal auf der Preisseite prüfen würde. Überzeugt hat mich, wie offen Launchables die Grenzen der eigenen Kalibrierung beschreibt.
- Mit 0,005 £ (31B) und 0,0015 £ (12B) je Million Eingabetokens ist es der günstigste kostenpflichtige Dienst in dieser Liste.
- Unter /v1/systemone funktionieren laut Hersteller bestehende Decision-Clients ohne Umbau.
- Live-Anfragen werden laut Hersteller nicht gespeichert und nicht zum Training verwendet.
- Choice erlaubt bis zu 256 Optionen, beide Modelle lesen auch Bilder.
- Die Abrechnung läuft über Guthaben in Pfund, zuzüglich britischer Umsatzsteuer.
- Batch-Dateien liegen laut Datenschutzerklärung auf Servern in Kanada, Konto-Daten in London.
- Das 31B-Modell liest nur 16.384 Tokens Kontext.
- Laut Hersteller stimmen zugesagte Ja-Nein-Antworten in etwa 70 % der Fälle, nicht in 80 %.
13. Levanto Sage
Sage kommt von Levanto Labs und ist ein Entscheidungsmodell mit eigener API, das neben Ja-Nein, Auswahl und Skala auch sortieren und verschlagworten kann. Welche Version die API ausliefert, nennt die Preisseite nicht, sie führt Sage 1.1 im Vergleich.
Laut Preisseite kostet die Eingabe im kostenlosen Tarif und im Developer-Tarif 0,05 $ je Million Tokens, in größeren Abos bis hinunter auf 0,038 $. Antworten sind kostenlos, nur Reasoning-Tokens kosten 1 $ je Million. Unter /v1/systemone spricht Sage das Jev-Format, laut Dokumentation genügen neue Basis-URL, Schlüssel und Modellname.
Sage gefällt mir wegen der klaren Datenschutzzusage. Bei der Preisgestaltung mit Abos und Reasoning-Kosten würde ich aber genau nachrechnen.
- Laut Dokumentation genügen für den Wechsel neue Basis-URL, Schlüssel und Modellname.
- Inhalte normaler Anfragen speichert Levanto laut Datenschutzerklärung nicht und nutzt sie nicht zum Training.
- Im JevBench 1.8.2 erreicht Sage 1.3.0 78,6 Capability- und 73,7 Composite-Punkte, Sage 1.4 nur 73,3 und 67,7.
- Neben Choice, Score und Noul gibt es Sortieren und Tags über die eigene API.
- Im kostenlosen Tarif kostet die Eingabe 0,05 $ je Million Tokens, mehr als bei Jev.
- Reasoning-Tokens kosten 10 $ je Million, und der Inhalt zählt bei jeder Frage erneut.
- Choice erlaubt nur 2 bis 120 Optionen, mit Bild nur 20.
- Fehlgeschlagene oder langsame Anfragen können bis zu 30 Tage als Diagnoseprotokoll gespeichert werden.
14. Codiv
Codiv ist eine Plattform, die mehrere offene Entscheidungsmodelle hinter einer Jev-kompatiblen Schnittstelle bündelt, und vor allem zum Vergleichen interessant. Zu den Modellen zählen OpenJev 0.1, Laya 1.0, Verdict 1.4, CLM 0.1 und JevK5 0.3.
Mit OpenJev ist razorback16/openjev gemeint, denn es gibt mehrere Projekte mit diesem Namen. Laut Anbieter genügt es, die Basis-URL zu wechseln.
Jeder Schlüssel darf 60 Anfragen je Minute stellen, dazu kommen 100 Millionen System-One-Tokens und 10 Millionen Textgenerierungstokens je Konto, ohne Karte.
Zum Datenschutz schreibt Codiv in der Datenschutzerklärung, dass die gesendeten Inhalte nicht gespeichert werden. Prüf vor vertraulicher Nutzung den Vertrag.
Für mich ist Codiv ein Ort zum Vergleichen, nicht zum Betreiben. Auf einen Produktivbetrieb würde ich mich nach dem Stand der Quellen nicht verlassen.
- Laut Anbieter genügt ein Wechsel der Basis-URL, die Python- und TypeScript-SDKs von TypeSafe laufen unverändert.
- Hinter einem Schlüssel liegen OpenJev 0.1, Laya 1.0, Verdict 1.4, CLM 0.1 und JevK5 0.3.
- Jedes Konto bekommt 100 Mio. System-One-Tokens ohne Karte.
- Die Datenschutzerklärung sagt, gesendete Inhalte würden nicht gespeichert (Anbieterangabe).
- Codiv nennt das Angebot selbst ein „Free public experiment“, einen Produktionstarif gibt es nicht.
- Kontingente und Funktionen können sich ändern, und eine Verfügbarkeitszusage fehlt.
- Jeder Schlüssel ist auf 60 Anfragen pro Minute begrenzt.
- Die Qualität hängt vom gewählten Modell ab, und „OpenJev“ meint hier razorback16/openjev, nicht die gleichnamigen anderen Projekte.
15. Djev
Djev ist eine günstige Jev-Alternative für alle, die mit einem Research Preview leben können, der nur auf Einladung läuft. Die Implementierung ist offen (Davipar/djev-dev, Apache-2.0) und nutzt DiffusionGemma mit vLLM. Der ausgewiesene Preis liegt bei 0,035 $ je Million Eingabetokens, die Ausgabe ist kostenlos.
Der Preis reizt mich, der Rest bremst mich. Ohne Einladungscode kommst du nicht hinein. Und dass Anfragen mindestens sieben inaktive Tage auf dem Server bleiben, würde ich bei vertraulichen Daten nicht akzeptieren.
- Der ausgewiesene Preis liegt mit 0,035 $ je Million Eingabetokens unter Jev (0,042 $) und milliseconds.ai (0,04 $), die Ausgabe ist kostenlos.
- Als Zustand gehen Text, JSON und Bilder, Optionen können selbst Bilder sein, und die Oberfläche kann Kamerabilder als Live-Frames auswerten.
- Eine Anfrage darf bis zu 32 Fragen, 20.000 Zeichen Zustand und sechs Bildanhänge enthalten.
- Die Implementierung ist offen (Apache-2.0) und läuft auf DiffusionGemma mit vLLM.
- Der Zugang ist „Invite only“ und braucht einen Einladungscode.
- Angenommene Anfragen und Ergebnisse bleiben mindestens sieben inaktive Tage auf dem Server, eine pauschale Zero-Data-Retention-Annahme ist falsch.
- Es ist ein Research Preview mit eigenem Endpunkt (POST /v1/request, Entwurfsstand), nicht mit dem TypeSafe-Endpunkt.
- Die Oberfläche nennt Modal als Inferenz-Host und Vercel als Auslieferung. „Token usage“ ist ausdrücklich keine Abrechnungssumme, weil wiederholte interne Lesevorgänge mitzählen.
16. OpenAI Decisions API
Die Decisions API kommt von OpenAI und ist eine Jev-Alternative für alle, die ohnehin mit der OpenAI-API arbeiten. OpenAI hat sie am 29. September 2026 auf dem DevDay vorgestellt, inzwischen ist sie allgemein verfügbar. Darunter läuft ausschließlich gpt-6-luna, als Eingabe gehen Text, Bilder und JSON.
Ohne Cache kostet die Eingabe 0,10 $ je Million Tokens, Ausgaben werden nicht berechnet. Für regionale Verarbeitung und lange Kontexte kommen Aufschläge dazu. Eine Anfrage darf bis zu 400 Fragen enthalten, die Fragetypen heißen predicate, choice und score.
Im unabhängigen JevBench 1.8.2 kommt die Decisions API auf 73,5 Capability- und 62,4 Composite-Punkte, also unter Jev 1.14. Bei mehr als dem doppelten Preis würde ich sie nur nehmen, wenn ohnehin alles über OpenAI läuft.
- Die API ist allgemein verfügbar und offiziell dokumentiert.
- Eine Anfrage darf bis zu 400 Fragen enthalten.
- Als Eingabe gehen Text, Bilder und JSON.
- Wer schon mit OpenAI-Schlüssel und OpenAI-Abrechnung arbeitet, braucht keinen weiteren Anbieter.
- Mit 0,10 $ je Million Eingabetokens kostet sie mehr als das Doppelte von Jev, dazu kommen mögliche Aufschläge.
- Der Endpunkt POST /v1/decisions ist nicht die Jev-Schnittstelle, Jev oder TypeSafe erwähnt die Dokumentation nicht.
- Im JevBench 1.8.2 liegt sie mit 73,5 Capability-Punkten unter Jev 1.14.
- Darunter läuft das proprietäre gpt-6-luna, einen Selbstbetrieb gibt es nicht.
17. Cloudflare Clef
Clef kommt von Cloudflare und ist eine Jev-Alternative für alle, die ihre bestehende Jev-Integration behalten und schneller entscheiden wollen. Seit dem 1. Oktober 2026 laufen die beiden Modelle Clef (27B) und Clef-flash (9B) auf Workers AI.
Clef kostet laut Modellseite 0,24 $ je Million Eingabetokens, Clef-flash 0,038 $. Die Gewichte stellt Cloudflare unter Apache-2.0 auf Hugging Face, Clef baut auf Qwen3.8-27B auf. Zum Datenschutz sichert Cloudflare zu, Anfragen und Antworten weder zu lesen noch zu speichern oder damit zu trainieren. Das gilt, solange du das Fine-Tuning nicht nutzt.
Clef finde ich spannend, weil er gehosteten Betrieb und offene Gewichte verbindet. Die Benchmark- und Latenzzahlen stammen aber von Cloudflare selbst, und zu Deutsch sagt Cloudflare nichts.
- Clef folgt der System-One-API, laut Changelog genügt der Wechsel von Endpunkt und Modell.
- Eine Anfrage darf bis zu 64 Fragen der Typen noul, choice und score enthalten. Clef liest 65.536 Tokens, Clef-flash 24.576.
- Cloudflare nennt im Median 209 ms für Clef und 39 ms für Clef-flash. Für Jev misst der Hersteller im eigenen Lauf 524 ms.
- Die offenen Gewichte erlauben später einen Selbstbetrieb.
- Clef kostet mit 0,24 $ je Million Eingabetokens fast sechsmal so viel wie Jev, nur Clef-flash ist mit 0,038 $ günstiger.
- Zu Deutsch und anderen Sprachen sagen Modellseiten und Blogbeitrag nichts.
- Zu langer Textzustand wird laut Dokumentation gekürzt, nicht abgelehnt.
- Bilder gehen nur eingebettet und höchstens vier je Anfrage, Bild-URLs nimmt die API nicht an.
Wer die Daten gar nicht erst an einen Dritten schicken will, betreibt selbst. Kontrolle klingt nach Freiheit, in der Praxis ist es eine Wartungsaufgabe, so wie bei jedem LLM, das du lokal betreibst.
Für den Selbstbetrieb gibt es keinen Tarif und keine Zahlen zu Betriebskosten. Bei den Laufzeiten hat sich dafür viel getan. Ollama unterstützt Entscheidungsmodelle inzwischen in stabilen Versionen, seit Version 0.40.4 vom 12. Oktober 2026 auch direkt im Terminal mit ollama run.
18. Surogate Rune
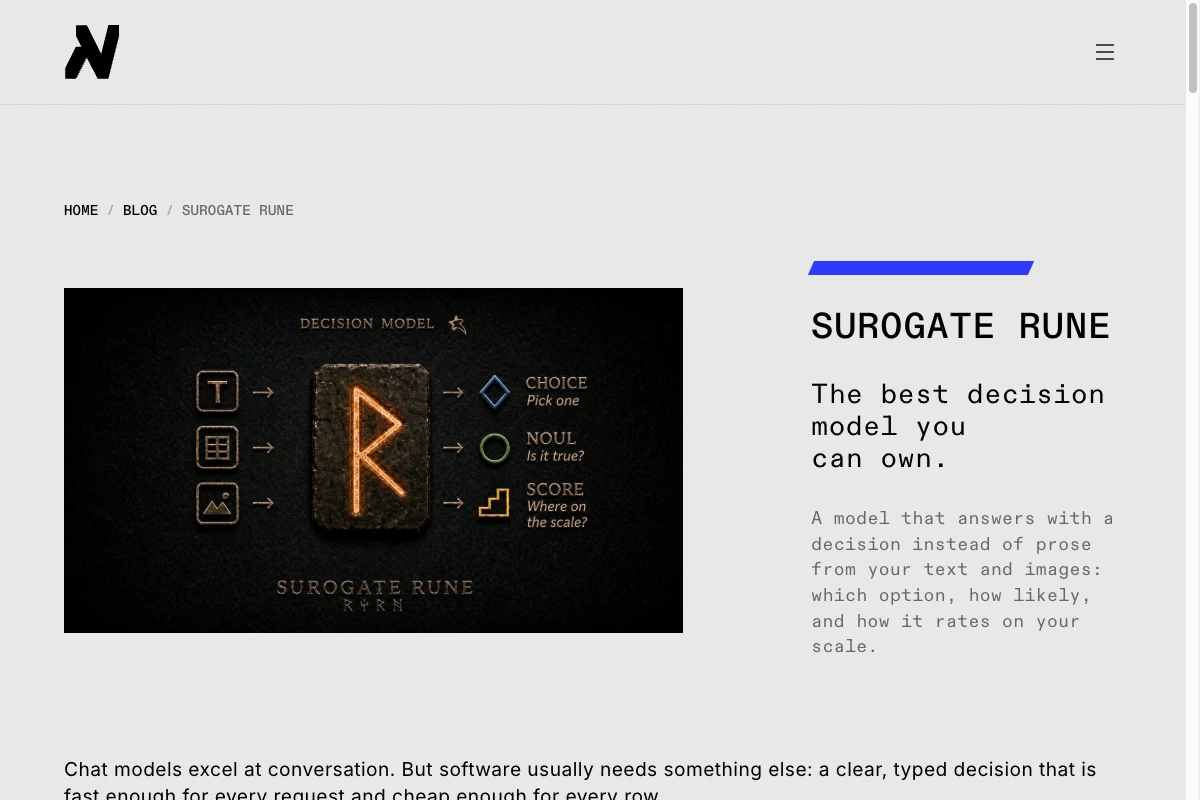
Surogate Rune kommt von Invergent und ist ein offenes Entscheidungsmodell für große GPUs, Bilder und sehr langen Kontext. Das Modell hat 26B Parameter, davon 4B aktiv, und steht unter Apache-2.0. Dazu gibt es laut SDK eine gehostete API, einen öffentlichen Tarif gibt es aber nicht.
Ich lese „4B aktiv“ nicht als „läuft auf meinem Laptop“. Wenn du keine große GPU hast, spar dir den Aufwand.
- Eine Anfrage liefert in einem Vorwärtsdurchlauf eine Wahl mit Wahrscheinlichkeiten über alle Optionen, dazu Noul und Score.
- Das Modell hat 262 Tsd. Tokens Kontext und nimmt Text, strukturierte Daten und Bilder mit Text.
- Der Hersteller nennt 90 bis 180 ms je Entscheidung auf einer RTX PRO 6000 ohne Netzwerkweg. Eine Bildentscheidung dauert 0,18 s.
- Optionales „Denken“ bis 512 Tokens greift nur bei Fragen, bei denen das Modell unter 70 % sicher ist (Herstellerangabe).
- Die Gewichte brauchen 51,6 GB, und der Hersteller betreibt sie auf 96-GB-Karten. „4B aktiv“ bedeutet nicht den Speicherbedarf eines 4B-Modells.
- Surogate 1.5.3 kann unter dauerhafter paralleler Last mit einem Speicherfehler stoppen, ein Build mit Fix (#217) ist nötig.
- Ein öffentlicher API-Tarif steht weder im Blogbeitrag noch im SDK, und der Repositoryname rune-26b-a4b-GGUF täuscht, denn geliefert werden BF16-Safetensors.
- Die SDK-Schnittstelle (POST /v1/decisions, Bearer-Schlüssel) ist vom TypeSafe-SDK abgeleitet, aber kein identischer Vertrag, und Sprachen nennt die Karte nicht.
19. Kev
Kev ist eine Jev-Alternative für alle, die ihre Jev-Schnittstelle behalten und das Modell selbst betreiben wollen. Die Modellfamilie Kev 1.0 von Jared Palmer kommt in den Größen 0,8B, 4B, 9B und 27B.
Der Code steht unter Apache-2.0, laut Readme gilt das auch für die Qwen-Basismodelle. Die Trainingsdaten haben eigene Lizenzen.
Kev läuft auf Nvidia-Grafikkarten und auf Apple Silicon. Über OpenRouter gibt es Kev-4B bei den Anbietern Phala und SiliconFlow für 0,042 $ je Million Eingabetokens bei 8k Kontext.
Beim Server lohnt ein zweiter Blick. Er ist standardmäßig offen. Eine Authentifizierung gibt es, sie ist aber optional und wird über die Variable KEV_API_KEY eingeschaltet.
Wenn du mich fragst, ist Kev der pragmatischste Weg, falls deine Jev-Integration bleiben soll und nur das Modell wechselt. Den offenen Server würde ich vor dem ersten Einsatz absichern.
- Das Readme sagt, das TypeSafe Python SDK laufe gegen einen Kev-Server unverändert.
- Es gibt vier Größen von 0,8B für den Laptop bis 27B für eine 80-GB-Karte, Startempfehlung ist Kev-4B.
- NVIDIA und Apple Silicon sind dokumentiert, ein eigener HTTPS-Endpunkt auf Modal ist ein Befehl und skaliert auf null.
- Über OpenRouter läuft Kev-4B bei Phala und SiliconFlow für 0,042 $ je Million Eingabetokens mit 8K Kontext.
- Der Server ist standardmäßig offen, Authentifizierung gibt es nur optional über KEV_API_KEY.
- Eine ähnliche Schnittstelle heißt noch lange nicht gleiche Qualität oder gleich aussagekräftige Konfidenzwerte.
- Ob Deutsch gut klappt, sagt niemand.
- Die Trainingsdaten haben eigene Lizenzen, Downloadformat und Ladeanleitung des konkreten Pakets sind vor dem Einsatz zu prüfen.
20. Lev
Lev kommt von Interfaze und ist eine Jev-Alternative für alle, die ein kleines Jev-kompatibles Modell auf eigener GPU betreiben wollen. Es ist ein LoRA-Adapter auf Qwen3.5-4B unter Apache-2.0, veröffentlicht am 24. September 2026.
Laut Ankündigung spricht Lev das Protokoll /v1/systemone, Code für das TypeSafe-SDK läuft nach einem Wechsel der Basis-URL. Den Server bringt Lev selbst mit. Die Modellkarte sagt aber auch klar „English only“.
Lev ist neben Kev der zweite Weg, die Jev-Schnittstelle selbst zu betreiben. Im eigenen Vergleich von Interfaze liegt Lev mit 68,9 % deutlich hinter Jev mit 76,1 %. Für einen Ersatz ist mir das zu viel Abstand, für Tests mit englischen Fällen reicht es.
- Lev spricht /v1/systemone, TypeSafe-Clients laufen nach dem Wechsel der Basis-URL.
- Ein eigener Server liegt bei.
- Mehrere Fragen laufen in einem Durchlauf, eine Choice mit 60 Optionen kostet so viel wie eine Ja-Nein-Frage.
- Interfaze nennt 69 ms Rechenzeit auf einer H100 (Herstellerangabe).
- Laut Modellkarte versteht Lev nur Englisch.
- Im eigenen Vergleich von Interfaze erreicht Lev 68,9 % gegenüber 76,1 % für Jev.
- Auf der CPU dauert ein Aufruf Sekunden, für Echtzeit brauchst du eine CUDA-GPU.
- Einige Trainingsdatensätze haben eigene, teils nichtkommerzielle Lizenzen.
21. Standard One
Standard One kommt von Standard Thinking und ist ein Entscheidungsmodell für deutsche Aufgaben auf eigener Hardware. Deutsch steht unter seinen neun Trainingssprachen.
Die 8B- und 3B-Variante basieren auf Ministral 3, aktuell ist Version 2.2 vom 4. Oktober 2026. Die Lizenz ist Apache-2.0. Es verarbeitet bis zu 32.768 Tokens und über den Adapter bis zu 255 Optionen (im nativen Format 26).
Die Modellkarte nennt Schwächen selbst. Die deutschen Messwerte auf der Herstellerseite stammen von Version 1.1, nicht von der zweiten Version. Sie arbeiten außerdem mit anderen Optionsmengen als die Jev-Werte.
Für deutsche Aufgaben mit wechselnden Regeln auf eigener Hardware ist Standard One mein erster Kandidat. Fachsprache würde ich separat testen.
- Deutsch gehört zu den neun Trainingssprachen, die Modellkarte listet de.
- Die Karte weist Basismodell, Adapter, zusammengeführte Gewichte und Server als Apache-2.0 aus, aktuell ist v2.2 vom 04.10.2026.
- Ein vorgeschalteter jev-adapter stellt /v1/systemone bereit, mit 32.768 Tokens und bis zu 255 Optionen (nativ 26).
- Der Hersteller nennt Schwächen selbst, das erleichtert die Testplanung, weil du weißt, wo du zuerst nachmessen musst.
- Laut Modellkarte sind Support-Triage mit zehn Klassen (36 %) und die Relevanz von RAG-Passagen (59 %) im Zero-Shot-Betrieb schwach.
- Die deutschen Werte (85,8 % Massive bei 20 Optionen, 60,5 % XNLI) gehören zu v1.1. Mit Jevs 79,2 % bei 59 Optionen sind sie nicht vergleichbar.
- Im nativen Format sind nur 26 Optionen möglich, mehr gehen nur über den Adapter bis 255.
- Der Betrieb braucht SGLang plus Adapter, und der Bildpfad ist nicht durch einen eigenen Bildbenchmark abgesichert.
22. Liquid d1
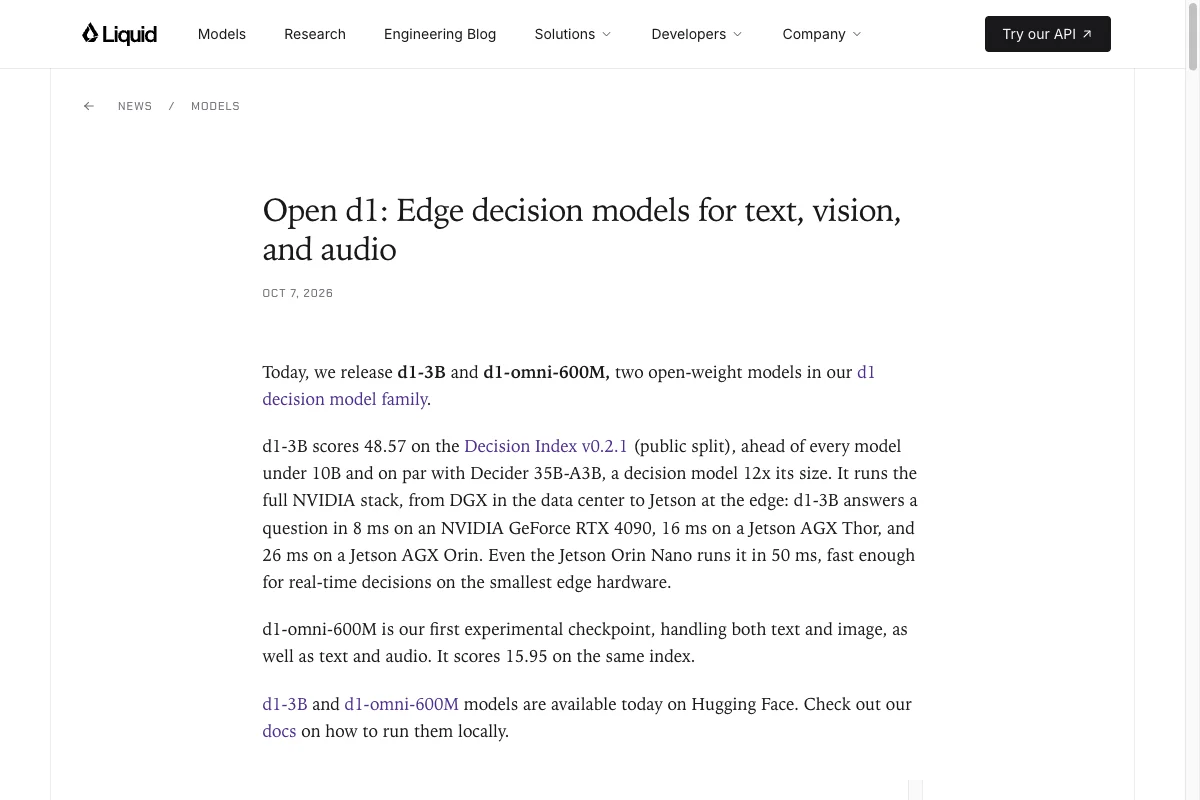
d1 kommt von Liquid AI und ist eine Familie von Entscheidungsmodellen für kleine Hardware bis hinunter zum Jetson. Am 7. Oktober 2026 hat Liquid AI d1-3B und das experimentelle d1-omni-600M veröffentlicht, beide mit offenen Gewichten.
d1-3B basiert auf LFM2.5-VL-3B, verarbeitet Text und Bilder und hat 32.768 Tokens Kontext. Die Modellkarte führt Deutsch unter 16 Sprachen. Die Lizenz LFM Open License v1.0 erlaubt die kommerzielle Nutzung aber nur Unternehmen mit weniger als 10 Mio. $ Jahresumsatz.
Für deutsche Entscheidungen auf Edge-Geräten ist d1-3B für mich einer der interessantesten Kandidaten. Die Lizenzgrenze würde ich vor dem Einsatz genau prüfen, und Messwerte für Deutsch gibt es auch hier nicht.
Seit dem 5. Oktober 2026 gibt es d1 zusätzlich als gehostete API von Liquid AI. Sie nimmt Anfragen unter /v1/systemone an, auch mit Bildern, und Liquid AI rechnet mit 0,04 $ je Million Eingabetokens. Jede Frage wird dabei als eigener Prompt abgerechnet. Über Vercel und OpenRouter ist d1 bisher nur für Text erreichbar.
- Liquid AI nennt 8 ms je Frage auf einer RTX 4090 und 50 ms auf einem Jetson Orin Nano (Herstellerangabe).
- Als Zustand gehen Text und Bilder, d1-omni-600M nimmt zusätzlich bis zu 30 Sekunden Sprache.
- Die Modellkarte führt Deutsch unter 16 Sprachen.
- Mit 48,57 Punkten im Decision Index 0.2.1 laut Hersteller das beste Entscheidungsmodell unter 10B.
- Die LFM-Lizenz ist keine Open-Source-Lizenz, ab 10 Mio. $ Jahresumsatz ist die kommerzielle Nutzung nicht lizenziert.
- Wer selbst hostet, spricht das Modell in Python an, /v1/systemone gibt es nur in der gehosteten API.
- d1-omni-600M ist ausdrücklich ein experimenteller Checkpoint.
- Deutsch steht nur in den Metadaten der Modellkarte, Messwerte dazu fehlen.
23. Mapika Decider
Mapika Decider ist eine offene Modellfamilie für Entscheidungen mit sehr vielen Optionen über einen gemeinsamen Kontext. Choice akzeptiert 2 bis 255 Optionen, Score 2 bis 10 Stufen und die Hauptmodelle nehmen bis zu 32 Tsd. Kontext. Die Lizenz ist Apache-2.0, die Modellkarte ist englisch.
Aktuell sind 2B v12 und 4B v3. Ältere Stände wie 2B v11 und 4B v2.1 bleiben unter Tags erreichbar.
Mapika ist einen Test wert, wenn du viele Optionen über einen gemeinsamen Kontext abfragst und Englisch reicht. Dass die Autoren ihre Freigaberegeln offenlegen, spricht für sie. Es ist aber auch eine Warnung.
- Choice akzeptiert 2 bis 255 Optionen, Score 2 bis 10 Stufen.
- decide_batch bewertet viele Zustände mit vielen Fragen in einem Aufruf.
- Die Request-Form entspricht Jev (POST /v1/systemone), im Prozess oder über HTTP.
- Mit abstain_below=t gibt eine Entscheidung unter der Konfidenzschwelle None zurück.
- Die Familie entwickelt sich schnell (aktuell 2B v12 und 4B v3), ältere Versionen bleiben nur unter Tags erreichbar.
- Die Modellkarte nennt nur Englisch, zu Deutsch sagt sie nichts.
- HTTP-Server und schema() brauchen die Torch-Engine, eine GGUF-Datei allein ergibt keine Entscheidungsschnittstelle.
- Verbesserungen auf schwierigen Aufgaben gingen teils mit Verschlechterungen anderer Aufgaben oder der Kalibrierung einher.
24. JevK5
JevK5 ist ein englischsprachiges Entscheidungsmodell mit Jev-Schnittstelle und vor allem für Entscheidungen auf einer einzelnen GPU interessant. Es stammt von allebee und ist nicht mit TypeSafe verbunden. Es gibt die Modelle JevK5-4B v0.3 und JevK5-9B v0.3.3 unter Apache-2.0. Der Server nimmt die TypeSafe-Form von /v1/systemone entgegen.
Für deutsche Texte fällt JevK5 raus, da gibt es nichts zu deuteln. Für englische Entscheidungen auf einer einzelnen GPU mit rund 9 GB Speicher ist es einen Versuch wert.
- Die Lizenz ist Apache-2.0. Die Readme nennt rund 9 GB GPU-Speicher für 4B und rund 19 GB für 9B in bf16.
- Der Server akzeptiert die TypeSafe-Form von /v1/systemone mit den drei Typen.
- Bis zu 16 Optionen werden in einem Durchlauf bewertet, mehr Optionen in mehreren Durchläufen.
- Für v0.3 legt der Entwickler die Trainingsdaten offen. Es sind nur Trainingssplits, ohne MMLU und MMLU-Pro, RACE-Anteile sind entfernt (Herstellerangabe).
- Die Readme sagt: „The model is English-only“.
- Eingaben über 16.384 Tokens werden abgelehnt, und der Server serialisiert Anfragen auf einer GPU.
- Die Qualität auf Jevs veröffentlichten Praxis-Workflows ist laut Readme noch nicht gemessen.
- Die unabhängigen JevBench-v1.4-Werte betreffen v0.2, nicht v0.3, und ältere Gewichte hatten eine offengelegte MMLU-Pro-Überschneidung.
25. Strands Decider
Strands Decider 2B kommt von Strands Labs und ist ein kleines offenes Entscheidungsmodell zum Experimentieren auf dem eigenen Rechner. Strands Labs ist das Team hinter dem Agenten-SDK Strands Agents. Es ist ein LoRA-Adapter mit kleinem Entscheidungskopf auf Qwen3.5-2B-Base unter Apache-2.0, vorgestellt am 1. Oktober 2026.
Der mitgelieferte Server nimmt Anfragen unter /v1/systemone in derselben Form wie Jev an. Eine ausdrückliche Kompatibilitätszusage macht das Team aber nicht. Das Modell läuft auf Nvidia-GPUs, Apple Silicon und der CPU.
Für mich ist Strands Decider ein Spielplatz, kein Ersatz für den Produktivbetrieb. Für schnelle lokale Tests auf dem Laptop passt es gut, bei langen Dokumenten nennt das Team selbst die Schwachstelle.
- Das Team nennt im Median 115 ms auf einer RTX 3090 und 153 ms auf einem M3 Pro (Herstellerangabe).
- Der Server nimmt /v1/systemone mit Zustand und benannten Fragen entgegen.
- Die Zahl der Optionen je Frage ist laut Readme nicht begrenzt.
- Im öffentlichen JevBench beantwortet es 176 von 231 Aufgaben richtig (Herstellerangabe).
- Lange, mehrstufige Dokumente nennt das Team selbst als Schwachstelle.
- Score und Noul übertragen sich laut Team schlecht auf Aufgaben, die vom Trainingsmix abweichen.
- Bilder gehen nur ohne eigenes Training, gelernt hat das Modell nur mit Text.
- Zu Sprachen sagt das Team nichts, und die Architektur ist laut Ankündigung noch im Fluss.
26. AutoTrust JEV-27B
AutoTrust JEV-27B kommt vom AutoTrust AI Lab und ist ein offenes Modell für Entscheidungen und normale Textgenerierung in einem Checkpoint. Es setzt einen trainierten Entscheidungsblock auf ein unverändertes Qwen3.8-27B. Seit dem 30. September 2026 gibt es zusätzlich die Bildvariante JEV-27B-VL.
Laut Modellkarte bildet der Entscheidungsteil Jev 1.13 nach und liegt im eigenen Vergleich mit 84,07 Punkten knapp vor Jev (83,85). Die Gewichte brauchen rund 54 GB, und der mitgelieferte Server nutzt einen eigenen Endpunkt.
Ein Nachbau, der laut Modellkarte auch Jevs Fehler übernimmt, ist für mich kein Ersatz. Er ist ein Werkzeug für Teams mit großer GPU, die Jev lokal nachbilden wollen.
- Ein Checkpoint liefert Noul, Choice und Score und kann zusätzlich normal Text generieren.
- Choice erlaubt 2 bis 256 Optionen, Prompts bis 256 Tsd. Tokens.
- Das Team nennt 137 ms je Einzelanfrage auf einer B200 (Herstellerangabe).
- Die Lizenz ist Apache-2.0, dazu kommt eine Variante für Bilder.
- Laut Modellkarte übernimmt der Entscheidungsteil Jevs Fehler gleich mit.
- Die Gewichte brauchen rund 54 GB, die Bildvariante eine GPU mit mindestens 80 GB.
- Der Server spricht /v1/decide statt /v1/systemone und kürzt Zustände standardmäßig ab 1.024 Tokens.
- Der Fokus liegt auf Englisch, andere Sprachen wurden nicht systematisch gemessen. Das Team rät von Entscheidungen mit hohem Risiko ab.
27. H2O-Lightning
H2O-Lightning kommt von H2O.ai und ist eine offene Modellfamilie für Entscheidungen auf eigener Hardware. H2O-Lightning-4B basiert auf Qwen3.5-4B, steht unter Apache-2.0 und nimmt Anfragen unter /v1/systemone an.
Laut Modellkarte verarbeitet die 4B-Variante bis zu 255 Optionen und bis zu vier Bilder je Anfrage, gemessen auf einer einzelnen L40S mit 48 GB. Am 20. Oktober 2026 kam H2O-Lightning-31B dazu, das im JevBench nach Capability zu den stärksten offenen Modellen gehört. Dessen Modellkarte ist aber nur nach Anmeldung einsehbar, und die Lizenz erlaubt nur nichtkommerzielle Nutzung.
Für den Selbstbetrieb ist die 4B-Variante mein Favorit unter den neuen offenen Modellen, weil Lizenz, Server und Messwerte zusammenpassen. Das 31B-Modell taugt wegen der Lizenz nur zum Ausprobieren.
- H2O-Lightning-4B steht unter Apache-2.0 und bringt einen Server für /v1/systemone mit.
- Im JevBench 1.8.2 liegt die 4B-Variante mit 75,0 Capability-Punkten gerundet gleichauf mit Jev 1.14, beim Composite mit 77,9 klar davor.
- Choice erlaubt bis zu 255 Optionen, dazu kommen bis zu vier Bilder je Anfrage.
- Eine kostenlose Demo auf Hugging Face erlaubt erste Tests ohne eigene GPU.
- Das stärkere 31B-Modell ist nur nichtkommerziell lizenziert, die Modellkarte nur nach Anmeldung lesbar.
- Der empfohlene Betrieb braucht einen eigenen vLLM-Build von H2O.ai.
- Getestet wurde laut Karte vor allem auf Englisch.
- Es ist kein Chatmodell und liefert keine Begründungen.
28. Torchcast Decision
Torchcast Decision 4B kommt von Torchcast AI und ist ein kleines offenes Entscheidungsmodell für eine einzelne GPU. Version 1.3 ist ein Fine-Tune von Qwen3.5-4B und steht unter Apache-2.0.
Ein Server für /v1/systemone liegt bei, laut Modellkarte funktionieren TypeSafe-kompatible Clients damit. Im JevBench hat v1.3 den besten Composite-Wert aller offenen Modelle, weil es klein, schnell und günstig im Betrieb ist.
Wer ein kleines Modell mit Jev-Schnittstelle sucht, sollte Torchcast neben Lev und Kev testen. Die großen Geschwister mit 12B und 27B stehen allerdings unter einer nichtkommerziellen Lizenz.
- Version 1.3 steht unter Apache-2.0 und bringt einen eigenen Server mit.
- Im JevBench 1.8.2 erreicht v1.3 77,5 Capability- und 80,5 Composite-Punkte, beides vor Jev 1.14.
- Torchcast nennt eine Median-Latenz von 31,9 ms auf einer A40 (Herstellerangabe).
- Choice nimmt beliebig viele Optionen, mehr als 26 werden in Gruppen entschieden.
- Die 12B- und 27B-Varianten stehen unter CC BY-NC 4.0 und sind nicht kommerziell nutzbar.
- Der Server läuft nur mit PyTorch und beantwortet Anfragen nacheinander, vLLM und llama.cpp werden nicht unterstützt.
- Prompts über 16.384 Tokens kürzt das Modell auf Anfang und Ende.
- Die Karte nennt nur Englisch, und Wahrscheinlichkeiten können in neuen Domänen unzuverlässig sein.
29. Quyet-1.0
Quyet-1.0 kommt von Chinh Nguyen und ist eine offene Modellfamilie vom kleinen Encoder bis zum großen Modell. Quyet-1.0-Large basiert auf Gemma-4-31B-it, steht unter Apache-2.0 und gehört im JevBench zu den stärksten offenen Modellen.
Die Antworten folgen laut Modellkarte der TypeSafe-Form von /v1/systemone, angesprochen wird das Modell über das Python-Paket quyet oder vLLM. Je Frage sind höchstens zehn Optionen erlaubt, und der Zustand darf bis zu 6.000 Tokens lang sein.
Quyet ist eine Option für Teams mit großer GPU, die auf Englisch oder Vietnamesisch entscheiden lassen. Für Deutsch und viele Optionen würde ich andere Modelle zuerst testen.
- Im JevBench 1.8.2 erreicht Quyet-1.0-Large 81,7 Capability- und 73,8 Composite-Punkte.
- Die Lizenz ist Apache-2.0, laut Karte gilt das auch für das Basismodell Gemma 4.
- Die Familie reicht von Encodern mit 153M Parametern bis zum 31B-Modell.
- Eine Browser-Demo auf quyet.ai erlaubt erste Tests.
- Je Frage sind höchstens zehn Optionen erlaubt.
- Der Zustand darf nur 6.000 Tokens lang sein.
- Das große Modell braucht eine GPU mit 80 GB.
- Getunt ist es auf Englisch und Vietnamesisch, andere Sprachen klappen laut Karte schlechter.
30. Decisio
Decisio ist ein Open-Source-Server für Entscheidungen auf einem unveränderten Basismodell und vor allem für alle interessant, die Jev auf eigener Hardware ersetzen wollen. Das Projekt von aminry nutzt Gemma 4 mit 12B oder 31B Parametern oder Qwen3.6-35B-A3B, das Modell selbst wird nie nachtrainiert.
Der Server spricht laut Readme das System-One-Format von TypeSafe unter /v1/systemone. Er läuft auf einer eigenen GPU oder auf dem Mac, das 31B-Modell braucht etwa eine 96-GB-Karte oder einen Mac mit 64 GB. Im JevBench liegt Decisio mit Gemma 4 31B beim Composite vor Jev 1.13.
Decisio ist für mich der Gegenentwurf zu den nachtrainierten Modellen. Es zeigt, wie weit ein unverändertes Basismodell mit guter Auslese kommt, und gehört deshalb neben Cygnet in jeden Vergleich.
- Der Server spricht laut Readme das System-One-Format unter /v1/systemone.
- Im JevBench erreicht Decisio 0.8.0 auf Gemma 4 31B 79,6 Capability- und 73,2 Composite-Punkte.
- Choice erlaubt bis zu 255 Optionen, mehrere Fragen teilen sich einen Zustand.
- Es läuft auch auf dem Mac, mit 64 GB für das 31B-Modell.
- Die JevBench-Werte gelten für Version 0.8.0, aktuell ist eine deutlich neuere Version.
- Für das 31B-Modell brauchst du eine Karte mit rund 96 GB oder ein H100 mit 80 GB.
- Zu Sprachen sagt das Readme nichts.
- Das Projekt stammt von einer Einzelperson, nicht von einem Unternehmen.
31. Intern-Decision
Intern-Decision kommt von InternLM und ist eine lokale Bibliothek für mehrere Fragen über denselben Text oder dieselben Bilder. Die Modelle gibt es in den Größen 0,8B, 2B und 4B auf Basis von Qwen3.5. Über eine DecisionEngine laufen mehrere typisierte Fragen über denselben Zustand, ein abgesicherter Produktionsserver ist es aber nicht.
Die Herstellerzahlen klingen gut. Ich würde sie als Anlass zum Nachmessen lesen, nicht als Grund zum Wechsel.
- Mehrere typisierte Fragen laufen über denselben Zustand, die Felder teilen sich einen kausalen Vorwärtsdurchlauf.
- Der Hersteller nennt für 4B 90,02 % Durchschnittsgenauigkeit über sieben Suiten gegenüber 88,74 % für Jev. Protokolle und Umfang weichen laut Hersteller ab.
- Die mittlere lokale Latenz beträgt 44,16 ms auf einer RTX 4090. In derselben Herstellertabelle steht Jev mit 109,70 ms. Die Messbedingungen unterscheiden sich.
- Bis zu acht Bilder pro Anfrage sind möglich, Training, Inferenz und Kalibrierung liegen als Code vor, die Gewichte sind Apache-2.0.
- Eine Anfrage nimmt 1 bis 16 Fragen mit höchstens 62 Optionen je Frage. Eingaben über 8.192 Tokens werden abgelehnt statt gekürzt.
- Es ist eine lokale Bibliothek, kein abgesicherter Produktionsserver und keine Jev-kompatible HTTP-Schnittstelle.
- Alle Zahlen sind Herstellerangaben mit eigenen Protokollen, eine deutsche Qualitätsauswertung fehlt.
- Die 44,16 ms gelten für 289 Eingabetokens und drei Felder, nicht für lange Bildanfragen unter Last.
Bevor du Hardware bestellst, kommt die unbequeme Frage, ob deine Aufgabe vielleicht etwas viel Einfacheres löst. Deshalb gehört in jeden Vergleich ein Kontrollarm, und die nächsten drei Einträge sind genau das.
32. Cygnet
Cygnet kommt von Blockbrain und ist ein Kontrollarm, also eine Variante ohne Spezialmodell, gegen die du die anderen misst. Es setzt auf ein unverändertes Gemma-4-12B-it ohne Fine-Tuning und läuft mit dem Standard-vLLM. Es verarbeitet bis zu 26 Optionen und 16.384 Tokens Kontext. Kalibriert wurde es auf 241 selbst erzeugten Beispielen, nicht auf den öffentlichen JevBench-Aufgaben.
Nimm Cygnet als Maßstab für deine Tests. Schafft ein aufwendiger Nachbau auf deinen Fällen nicht mehr als Cygnet mit einer unveränderten Basis, brauchst du ihn nicht.
- Es braucht kein Fine-Tuning und läuft mit dem unveränderten vLLM 0.30.0.
- Die Kalibrierung (T = 3,4) stammt von 241 selbst erzeugten Beispielen, die öffentlichen JevBench-Aufgaben dienten nur zum Messen.
- Der Autorenlauf zählt 203 von 231 öffentlichen JevBench-Aufgaben richtig (87,9 %), bei 0,050 bis 0,066 s Median-Latenz auf einer 48-GB-Karte.
- Jede Entscheidung erzeugt nur ein Ausgabetoken, die Kosten hängen fast nur an den Eingabetokens.
- Mehr als 26 Optionen, zu lange Eingaben oder unbekannte Fragetypen lehnt der Shim mit HTTP 422 ab.
- Jede Frage löst einen eigenen internen Aufruf aus, einen gemeinsamen Durchlauf für beliebig viele Fragen gibt es nicht.
- Getestet wurde auf 48-GB-Karten (RTX A6000, L40S), Aussagen zu kleinerer Hardware fehlen.
- Die 87,9 % betreffen nur die 231 öffentlichen Aufgaben im Autorenlauf, einen Platz in einer JevBench-Rangliste gibt es nicht.
33. SemIf
SemIf ist ein Framework, das die Wahrscheinlichkeiten für Optionen direkt aus Basismodellen ausliest, und vor allem als schlanker Kontrollarm interessant. Es stammt von TheoLeeCJ und steht unter MIT-Lizenz. Das Projekt hieß früher OpenJev und ist ausdrücklich nicht mit TypeSafe verbunden.
Mich überzeugt vor allem, dass andere Projekte darauf aufbauen. Die Kalibrierung musst du trotzdem selbst prüfen.
- Es liest die Wahrscheinlichkeiten für vorgegebene Optionen direkt aus einem Basismodell, ein eigenes Training ist nicht nötig.
- Backends gibt es für CUDA, Apple MLX, PyTorch/MPS und CPU über llama.cpp mit GGUF, dazu eine Browser-Demo.
- Auf Apple Silicon laufen parallele Entscheidungen über einen gemeinsamen Zustand.
- Andere Projekte bauen darauf auf, JevK5 nutzt ausdrücklich die Optionsauswertung von SemIf.
- Das Projekt reproduziert das Schnittstellenprinzip, nicht TypeSafes unveröffentlichtes Training, und ist ausdrücklich nicht mit TypeSafe verbunden.
- Eine normierte Verteilung über die Optionen beweist keine gute Kalibrierung.
- Modell- und Backendwechsel können Genauigkeit, Laufzeit und Reihenfolgeempfindlichkeit verändern.
- Der Repositoryname wechselte von SemIf zu SemIf-OpenJev (GitHub leitet um), und „OpenJev“ ist mit mehreren anderen Projekten verwechselbar.
34. AnyJev
AnyJev kommt von Nokia Applied Research und Tencent Hunyuan und ist eine Python-Bibliothek für dauerhaft gleiche Entscheidungen. Sie legt Kalibrierungsschichten auf unveränderte Basismodelle, steht unter Apache-2.0.
Für einmalige, ständig wechselnde Fragen ist es mir zu schwergewichtig.
- Stufe L0 arbeitet ohne Labels mit Optionsrotation auf einem unveränderten Basismodell, die label-trainierten Stufen L1 und L2 wurden in Version 0.3.0 entfernt.
- Die adaptive Rotation kommt mit 7,2 statt 18 Rotationen bei einer bescheinigten Abweichung von 1 % aus (Autorenwert).
- „Accuracy“ misst hier die Übereinstimmung mit einem Lehrer-LLM, nicht mit menschlich geprüfter Wahrheit.
- Die label-trainierten Stufen gibt es nur noch in Version 0.2.0.
- Der Readout ist auf 26 Optionen begrenzt, ein Span-Readout darüber hinaus steht laut Roadmap noch aus.
- Backends sind Transformers, vLLM, SGLang und llama.cpp, eine Jev-kompatible HTTP-Schnittstelle erwähnt die Readme nicht.
Bei festen Kategorien kann ein Klassifikator reichen. Das ist die schlichteste Lösung, und sie wird oft unterschätzt.
35. SetFit
SetFit kommt von Hugging Face und ist ein Few-Shot-Framework für feste Kategorien, die sich selten ändern. Es baut auf Sentence Transformers mit mehrsprachigen Basismodellen auf. Laut Dokumentation genügen schon „only 8 labeled examples“, du brauchst allerdings eigene Labels und eine saubere Datenaufteilung. Neue Kategorien bedeuten erneutes Training.
Bei festen deutschen Kategorien, die sich selten ändern, würde ich immer zuerst fragen, ob ich wirklich ein Entscheidungsmodell brauche. Ein Klassifikator ist dann die schlichtere Lösung.
- Auf dem Sentiment-Datensatz Customer Reviews genügen laut Dokumentation „only 8 labeled examples“ je Klasse.
- Das Framework kommt ohne Prompts aus („prompt-free“) und braucht keine großen Modelle wie T0, Llama oder GPT-4.
- Mit einem mehrsprachigen Sentence-Transformer-Checkpoint lassen sich Texte in mehreren Sprachen klassifizieren.
- Training und Inferenz sind laut Dokumentation typischerweise eine Größenordnung schneller als bei großen Modellen.
- Du brauchst eigene Labels und eine saubere Datenaufteilung.
- Neue oder veränderte Kategorien können erneutes Training und Kalibrierung erfordern.
- Eine Jev-kompatible API wäre zusätzliche Anwendungssoftware, nicht Teil des Frameworks.
- Deutsch klappt nur mit mehrsprachiger Basis, und Zahlen zur Genauigkeit auf Deutsch gibt es nicht.
36. GLiClass
GLiClass kommt von Knowledgator und ist ein Zero-Shot-Klassifikator für Kategorien, die sich oft ändern. Die Labels gibst du erst zur Laufzeit an, die Lizenz ist Apache-2.0. Für allgemeine, regelbezogene Urteile taugt es nicht als Ersatz.
Wechseln deine Kategorien oft und hast du keine Trainingsdaten, ist GLiClass der leichteste Start. Für Urteile nach Regeln würde ich es nicht nehmen. Zu Geschwindigkeit, Größe und Genauigkeit nennt die Readme keine konkreten Zahlen.
- Die Labels gibst du erst zur Laufzeit an, ein Training auf deinen Kategorien entfällt (Zero-Shot).
- Mehrfachklassifikation mit Schwellenwert ist eingebaut (classification_type='multi-label', threshold).
- Für lange Texte gibt es eine eigene Chunking-Pipeline für lange Dokumente.
- Es ist kein Ersatz für allgemeine, regelbezogene Urteile.
- Anzahl und Länge der Labelbeschreibungen gehören zur Konfiguration und beeinflussen die Qualität.
- Eine Jev-kompatible Hülle würde das Modell nicht zu einem allgemeineren Entscheider machen.
- Die Readme nennt keine Sprachen, wie gut Deutsch klappt, bleibt offen.
37. GLiNER2.5 multilingual
GLiNER2.5 multilingual kommt von Fastino und ist ein Extraktionsmodell für alle, die Felder und Entitäten statt Urteile brauchen. Es hat 287M Parameter und basiert auf mDeBERTa-v3-base. Die Karte nennt nur „Multilingual“, Deutsch steht nicht ausdrücklich darin.
Willst du keine Ja-Nein-Urteile, sondern Felder aus Text, gehört GLiNER2.5 auf deine Liste. Ob es deutsche Geschäftsdokumente gut liest, musst du selbst prüfen. Damit steht die Auswahl, und es bleibt die Frage nach Deutsch und Datenschutz.
- Ein Modell liefert Entitäten, Klassifikation, strukturierte Records und Relationen.
- Es hat 287M Parameter und rund 594 MB Gewichte, lokal ohne externe API.
- Die Familie gibt es auch als 74M- und 194M-Variante (englisch) mit derselben API.
- Die Karte nennt Apache-2.0 und eine Fenstergröße von max_len=4096 sowie einen Abschnitt für lange Dokumente.
- Die Karte nennt nur „Multilingual“, Deutsch steht nicht ausdrücklich darin.
- Ein Extraktionsmodell beantwortet nicht automatisch jede Entscheidungsfrage, es liefert Werte und Textspannen.
- „Mehrsprachig“ ist keine Qualitätsgarantie für deutsche Geschäftsdokumente.
- Benchmarkwerte des älteren GLiNER2 gelten nicht für die 2.5-Familie, und eine Jev-artige Schnittstelle gibt es nicht.
Wie gut klappt deutscher Text, und wo bleiben deine Daten?
Auf Deutsch gibt es genau eine Zahlenreihe, und sie stammt von einem Anbieter.
Deutscher Text im Vergleich
Jev nennt Englisch als primäre Trainingssprache und rät, andere Sprachen auf eigenen Inhalten zu testen. Direkte deutsche Vergleichszahlen liefert nur ein Anbieterbenchmark von Privatemode, also von einem Beteiligten.
Er enthält fünf deutsche Datensätze. Die Grafik zeigt die Trefferquoten von Jev und Privatemode in Prozent. Jev steht jeweils oben, Privatemode darunter.
gradually.aiEine einheitliche Richtung gibt es nicht. Bei zwei Aufgaben liegt Jev vorn, bei drei Privatemode. Die Streuung der Wiederholungen liegt bei Jev zwischen 0,2 und 0,9 Prozentpunkten, bei Privatemode zwischen 0,0 und 1,3. Einen Abstand wie 1,3 Prozentpunkte bei Massive Intent würde ich deshalb nicht überbewerten.
Für die übrigen Kandidaten fehlen deutsche Messwerte. Standard One nennt Deutsch als Trainingssprache, Liquid AI führt Deutsch in den Sprachangaben von d1-3B. Von den neuen gehosteten Diensten nennt keiner Deutsch ausdrücklich.
Wer Entitäten und Felder aus deutschen Texten holen will, findet GLiNER2.5 multilingual. Seine Karte nennt „Multilingual“, Deutsch aber nicht ausdrücklich.
Datenschutz und Betriebsort
Beim Thema LLM-Datenschutz zählt vor allem, wo deine Daten verarbeitet werden. Privatemode beschreibt eine attestierte Verarbeitung, die sich laut Anbieter aus der Ferne überprüfen lässt. Codiv schreibt in der Datenschutzerklärung, dass es die gesendeten Inhalte nicht speichert. Cloudflare sichert für Clef zu, Anfragen weder zu lesen noch zu speichern oder damit zu trainieren.
Microsoft hält die Verarbeitung mit DataZoneStandard in der gewählten Datenzone, und Databricks speichert die übergebenen Parameter laut Dokumentation nicht. Djev speichert angenommene Anfragen dagegen mindestens sieben inaktive Tage. Levanto und Launchables speichern Inhalte normaler Anfragen laut eigener Aussage nicht, SubQ dagegen bis zu 60 Tage. Perplexity sagt in der Dokumentation zur Datenhaltung gar nichts.
Bei Kev über OpenRouter läuft deine Anfrage über zwei Zwischenstationen, OpenRouter und einen der Anbieter Phala oder SiliconFlow. Der Selbstbetrieb hält die Daten im Haus. Für vertrauliche Inhalte würde ich deshalb zuerst Privatemode oder den Selbstbetrieb prüfen und alles andere hintanstellen.
Nehmen wir an, du hast dich entschieden. Dann fangen die eigentlichen Probleme erst an.
Was beim Wechsel wirklich schiefgeht
Wer Jev ersetzen will, denkt zuerst an den Preis. Aber der Preis trägt den Wechsel selten.
Preis pro Token ist nicht Preis pro Fall
Die meisten gehosteten Dienste kosten zwischen 0,01 und 0,06 $ je Million Eingabetokens, Jev liegt laut TypeSafe-Dokumentation mit 0,042 $ mittendrin. Deutlich teurer sind nur OpenAI und Cloudflare Clef. Die Grafik zeigt die Listenpreise in Dollar.
gradually.aiLaunchables rechnet in Pfund und unterbietet mit 0,0015 bis 0,005 £ alle anderen. Privatemode rechnet in Euro, Databricks über die eigenen Plattformpreise. Diese drei fehlen deshalb in der Grafik.
Zur Größenordnung hilft eine Rechenannahme. Bei 1.000 Eingabetokens je Entscheidung kosten 100.000 Entscheidungen bei Jev 4,20 $ und bei Perplexity 2,00 $. Bei kleinen und mittleren Mengen rechtfertigt die reine API-Ersparnis damit keinen eigenen GPU-Betrieb. Eigene Mengen rechnest du mit dem API-Kostenrechner nach.
Große Optionsmenüs können mehrere Aufrufe auslösen, bei Privatemode etwa über 128 auszulesenden Wahrscheinlichkeiten. Bei Liquid d1 und Levanto Sage zählt der Zustand außerdem bei jeder Frage erneut. Das verändert die Kosten je Fall.
Der Konfidenzwert ist nicht übertragbar
Jev berechnet den Konfidenzwert (in der Schnittstelle das Feld confidence) aus der Verteilung über die Optionen. Ein Wert von 0,9 bedeutet anderswo etwas anderes, je nachdem ob ein System Maximalwahrscheinlichkeit, Entropie oder eine normierte Größe nutzt.
Meine Schwellen von 0,75 bis 0,80 gelten deshalb nur für Jev. Eine Regel wie „ab 0,9 automatisch ausführen“ musst du für jedes Modell neu kalibrieren. Die Schwelle von einem System auf ein anderes zu kopieren, ist der schnellste Weg zu stillen Fehlern.
Kompatibel hat fünf Bedeutungen
Wenn ein Anbieter „kompatibel“ sagt, kann er fünf verschiedene Dinge meinen:
- Transport, also dieselbe Form der Anfrage.
- Schema, also dieselbe Struktur der Antwort.
- Semantik, also dieselbe Bedeutung der Felder.
- Wahrscheinlichkeit, also vergleichbare Werte.
- Betrieb, also gleiche Grenzen und Verfügbarkeit.
Erst wenn alle fünf stimmen, hast du einen Ersatz für Jev. Bei den Grenzen lohnt ein Blick in die Grafiken, denn Kontext und Optionen unterscheiden sich stark. Zuerst der Kontext in Tokens, dann die Zahl der Optionen je Frage.
Kontextgrenzen in Tokens
Privatemode nennt mit 1 Mio. Tokens den größten Kontext, Kev über OpenRouter mit 8.000 den kleinsten. Jev kommt auf 64.000 Tokens.
gradually.aiOptionen je Frage
Jev erlaubt wie die meisten Alternativen 255 Optionen je Frage. AutoTrust und Launchables kommen auf 256, Quyet-1.0 nur auf 10.
gradually.aiOffen heißt nicht frei
Im Wort „offen“ steckt eine Falle. Ein offenes Modell ist nicht automatisch kommerziell frei, und die Lizenz des Codes ist nicht die Lizenz der Gewichte. Ein Beispiel dazu kommt gleich.
Auch bei der Auswahl gibt es Fallen. Ein paar Namen tauchen in mehreren Listen auf und fehlen hier trotzdem, mit gutem Grund.
Warum manche bekannten Namen fehlen
Bekannt heißt nicht empfehlenswert. JevBench führt inzwischen über 300 Systeme. Meine Auswahl von 37 Einträgen folgt den typischen Aufgaben und dem, was über die Projekte bekannt ist. Diese Auslassungen sind mir am wichtigsten:
- Laya: Die Basischeckpoints schneiden laut Pinggy-Blog zero-shot „near chance“ ab, taugen also nur mit Anpassung. Das ist die Beobachtung eines Blogs, kein unabhängiger Test. Über Codiv kannst du Laya trotzdem ausprobieren.
- Hopper: Die Modellkarte sagt „Do not use this adapter commercially“. Das ist das Warnbeispiel für Lizenzfallen.
- Decision 1.0: Die Gewichte liegen vor, der Pull Request #4086 für den Standardbetrieb ist aber noch offen.
- Tev1 und FlyMy Decision-2B: Bei Tev1 ist die Lizenz der Gewichte noch in Finalisierung. Bei FlyMy Decision-2B sind Fragen zur Nutzung offen.
Neue Einträge seit Oktober nehme ich nur auf, wenn sie eine eigene Dokumentation oder Modellkarte haben und im JevBench bei Capability mindestens Jev 1.14 erreichen und beim Composite mindestens 70 Punkte. Daran scheitern auch bekannte Namen.
- Mercury Decide, wity-1 und SPX-CD: Sie liegen bei Capability oder Composite unter der Schwelle.
- Snowflake Decision, Hanzo Kai und Upstage Solar Decide: Für sie gibt es noch keine JevBench-Messung, Snowflake ist zudem eine private Vorschau.
- basal-omni, Sieve-31B, Elf 1, mammoth-1 und vLLM-SR d3: Sie erfüllen die Messwerte, ich habe sie für diese Liste aber noch nicht im Detail geprüft. Seit Version 1.8 schätzt JevBench die Betriebskosten offener Modelle nach GPU-Zeit. Für mammoth-1 und vLLM-SR d3 fällt der Kostenwert dadurch deutlich niedriger aus als mit dem früheren Listenpreis und liegt jetzt unter der Kostengrenze für das Capability-Ranking.
Dazu kommen Winnow, OneJev, reflex, jqv, Von, Verdict und einige mehr. Ich habe mich bei ihnen bewusst nicht entschieden.
Manche brauchen ein Basismodell zum Adapter, manche haben eine Gemma-Lizenz, manche liegen im Medienfokus. Schlecht sind sie deshalb nicht. Anwendungen, die nur Jev nutzen, zählen nicht als Alternativen.
Bleibt die Frage, wie du selbst herausfindest, was zu dir passt.
So testest du, bevor du wechselst
Der beste Test ist langweilig. Du nimmst deine eigenen Fälle mit sauberen Antworten und vergleichst so, dass du es morgen wiederholen kannst.
Sechs Schritte reichen dafür:
- Halte den Vertrag fest. Schreib Modell-ID, Revision, Quantisierung und Laufzeit auf und mische keine Versionen.
- Sammle eigene Fälle mit Referenzantworten und trenne die Fälle zum Einstellen von denen zum Prüfen.
- Lege Mindestmetriken und die akzeptable Fehlerquote fest, bevor du das erste Ergebnis siehst.
- Prüfe die Robustheit. Stell die Frage allein, mit irrelevanten Zusatzfragen und in vertauschter Reihenfolge. Benenne außerdem Kategorien neutral um, denn typkorrekte Antworten können laut einem Preprint trotzdem die falsche Bedeutung wählen.
- Lass die Alternative im Schattenbetrieb neben dem Bestehenden laufen.
- Plane einen Rückfallpfad, bevor du umschaltest.
Dabei gilt eine Obergrenze. Nimm höchstens eine Referenz, drei Alternativen und einen Kontrollarm. Betragsgrenzen und Berechtigungen gehören in deinen Anwendungscode, nicht ins Modell.
Als Kontrollarm eignet sich ein unverändertes Basismodell wie bei Cygnet oder ein schlanker Klassifikator wie SetFit. Dazu kommt ein naheliegender dritter Weg, ein Sprachmodell mit vorgegebenem Ausgabeformat (Structured Outputs). Wie gut das im Vergleich zu Jev funktioniert, zeigen deine eigenen Fälle.
Wenn du bis hier gelesen hast, kennst du die Landkarte. Fehlt nur der Satz zum Mitnehmen.
Welche Jev-Alternativen sind am beliebtesten?
Die meisten Alternativen in diesem Artikel sind Entscheidungsmodelle. Hier siehst du, welche davon am häufigsten gesucht, genutzt und erwähnt werden.
Am beliebtesten sind derzeit AutoTrust JEV-27B-VL (55 Punkte), Julia 1 (44 Punkte) und GLiNER2.5-Decide (44 Punkte). 38 Entscheidungsmodelle haben einen Wert im Beliebtheitsindex von gradually.ai.
Mit dem Schalter am Chart wechselst du zwischen Welt, EU und Deutschland.
Die beliebtesten Entscheidungsmodelle
Beliebtheitsindex von 0 bis 100, höher ist beliebter.
20 von 38 Modellen
Quelle: gradually.ai Beliebtheitsindex
Wie gut entscheiden die Jev-Alternativen im Test?
Bevor du von Jev wechselst, lohnt sich ein Blick auf die Qualität der Entscheidungen. Dieser Test lässt mehrere Modelle dieselben Aufgaben lösen.
In unserem automatischen Test GraduallyBench Decision v1 treffen 3 Modelle dieselben 60 Entscheidungen auf Deutsch und Englisch, etwa beim Einordnen, Weiterleiten und Prüfen von Vorgaben. Feste Regeln werten die Antworten aus. Vorn liegt Jev mit 93,3 Punkten, danach folgen Clef-Flash (85,0 Punkte) und Laya Multilingual (36,7 Punkte).
Fehlgeschlagene Anfragen und ungültige Antworten zählen als falsche Entscheidung. Ein Mensch hat die Aufgaben noch nicht gegengeprüft.
GraduallyBench Decision v1
Wert von 0 bis 100 aus fünf gleich gewichteten Aufgabenfamilien, höher ist besser
Quelle: GraduallyBench Decision v1
Fazit
Kurzum:
Die eine Jev-Alternative gibt es nicht. Deine gibt es. Sie hängt davon ab, ob dir Datenschutz, deutscher Text, Selbstbetrieb oder ein einfacher Kontrollarm am wichtigsten ist.
Wenn ich dir nur eines mitgeben dürfte, dann das. Ein sauberer Kontrollarm schlägt jede Bestenliste, denn er misst auf deinen Fällen und nicht auf fremden.
Wo du Jev selbst sinnvoll einsetzt, zeigen dir die Anwendungsfälle für Jev.
Bevor du umbaust, lass deine echten Fälle samt richtiger Antwort gegen Jev, höchstens drei Alternativen und ein unverändertes Basismodell laufen.
Du musst nicht über 50 Modelle kennen. Ein sauberer Testlauf mit deinen eigenen Fällen sagt dir mehr als jede Bestenliste, und der ist kein Hexenwerk.
Offene Fragen klären die sieben Antworten unten.
Häufig gestellte Fragen zu Jev-Alternativen
Jev ist ein System-One-Modell von TypeSafe AI. Es erzeugt keinen Text, sondern beantwortet typisierte Fragen zu einem Zustand, den du mitschickst.
Choice wählt aus Optionen, Score bewertet auf einer Skala, Noul liefert einen Ja-Wert zwischen 0 und 1. Laut TypeSafe-Dokumentation nutzt die Jev-API den Endpunkt POST /v1/systemone. Du passt Jev über Zustand und Fragenformulierung an, nicht durch Nachtraining.