Veröffentlichte Benchmarkwerte aus derselben Version und Vergleichskohorte, API-Preise und technische Eckdaten. Unterschiedliche Testeinstellungen werden sichtbar ausgewiesen.
gemeinsame Messreihen
202
verschiedene Benchmarks
26
jüngster Abruf
04.09.2026
Modellauswahl ändern
Steckbrief
Allgemeine Daten
Erscheinungsdatum, Verfügbarkeit, Kontextfenster, Architektur und veröffentlichte Parameterzahlen auf einen Blick. Nicht veröffentlichte Angaben bleiben als solche markiert.
Die Tabelle vergleicht die offiziellen Standard-API-Tarife pro 1 Mio. Token einschließlich veröffentlichter Cache-Preise. Batch, Fast, Priority, regionale Aufschläge, Toolaufrufe und Cloudpreise sind nicht eingerechnet.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Preise nach Anbieter
Direkte Entwicklertarife und über OpenRouter geroutete Anbieterpreise sind getrennt gekennzeichnet. Alle Preise gelten in USD pro 1 Mio. Token. Kontextabhängige Direktpreise sowie regionale, Flex-, Priority- und weitere OpenRouter-Tarife bleiben einzeln erkennbar.
Nur veröffentlichte Ergebnisse mit derselben Benchmark-Version, Aufgabe, Metrik und Vergleichskohorte werden gegenübergestellt. Wenn Anbieter unterschiedliche Reasoning-Stufen, Agenten oder Ausgabegrenzen verwendet haben, steht das direkt in der Tabelle.
Fähigkeitsprofil aus vergleichbaren Benchmarks
Jede Achse mittelt direkt vergleichbare Benchmarkfamilien. Ein Wert von 100 bedeutet den stärkeren Wert innerhalb dieses Duells, keinen universellen Qualitätswert.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Luna: Snapshot: gpt-5.6-luna-xhigh, Reasoning: xhigh, Harness: Arena text, style control Grok 4.3: Snapshot: grok-4.3, Harness: Arena text, style controlGPT-5.6 Luna: Stilbereinigte Arena-Bewertung aus 24.433 anonymen Paarvergleichen.Grok 4.3: Stilbereinigte Arena-Bewertung aus 65.024 anonymen Paarvergleichen.
Höherer Messwert1.452,364
95-%-Konfidenzintervall: ±5,03Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.442,599
95-%-Konfidenzintervall: ±3,771Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
LMArena Text, Style ControlBusiness, management and financeTestdetails
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Luna: Snapshot: gpt-5.6-luna-xhigh, Reasoning: xhigh, Harness: Arena text, style control Grok 4.3: Snapshot: grok-4.3, Harness: Arena text, style controlGPT-5.6 Luna: Stilbereinigte Arena-Bewertung aus 4.691 anonymen Paarvergleichen.Grok 4.3: Stilbereinigte Arena-Bewertung aus 13.131 anonymen Paarvergleichen.
Höherer Messwert1.461,709
95-%-Konfidenzintervall: ±9,371Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
1.439,103
95-%-Konfidenzintervall: ±6,526Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Testaufbau nicht identisch dokumentiertKein direkter SiegerVersion: style-control-v1Messgröße: style-controlled Bradley-Terry ratingBewertung: Mehr ist besserGPT-5.6 Luna: Snapshot: gpt-5.6-luna-xhigh, Reasoning: xhigh, Harness: Arena text, style control Grok 4.3: Snapshot: grok-4.3, Harness: Arena text, style controlGPT-5.6 Luna: Stilbereinigte Arena-Bewertung aus 1.691 anonymen Paarvergleichen.Grok 4.3: Stilbereinigte Arena-Bewertung aus 3.641 anonymen Paarvergleichen.
1.474,185
95-%-Konfidenzintervall: ±15,484Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Höherer Messwert1.479,363
95-%-Konfidenzintervall: ±10,781Der Arena-Score misst menschliche Präferenzen und ist kein fester Fähigkeitstest. Konfidenzintervall und Modellkonfiguration gehören zum Ergebnis.
Zeichenerklärung:besserer Wertbesser, aber nicht eindeutigGleichstand
Eigene Modelltests
Community-Tests zum Anschauen
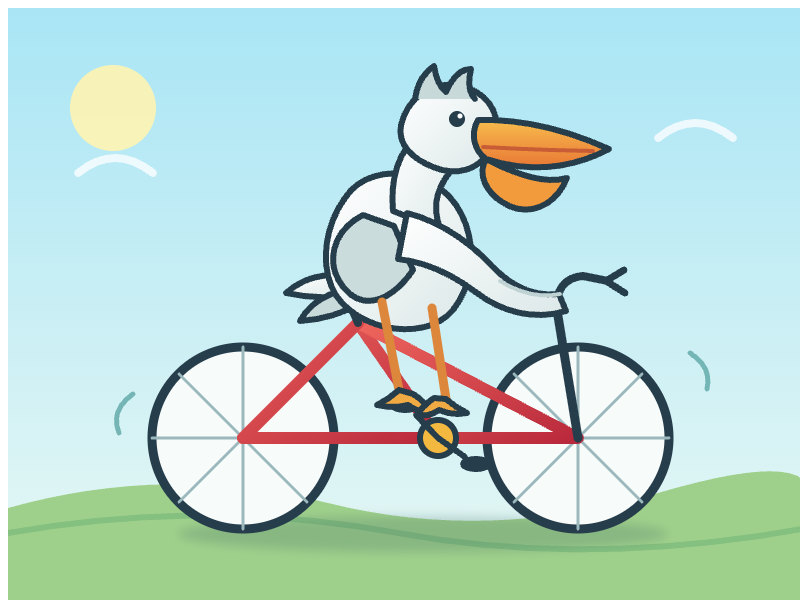
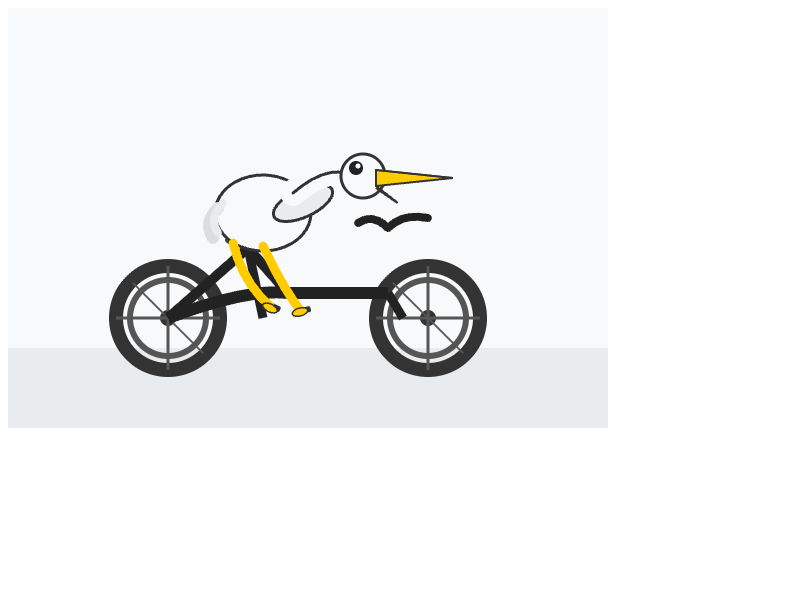
Vergleiche, wie die Modelle denselben Prompt umsetzen. Jeder Test zeigt den ersten Versuch, ohne nachträgliche Korrekturen am erzeugten Code. Die Ergebnisse fließen nicht in einen Gesamtscore ein.
Pelikan auf dem Fahrrad
Community-Klassiker für eine freie SVG-Zeichnung.
GPT-5.6 Luna
Community-Klassiker für eine freie SVG-Zeichnung.Erster Versuch
Datum des Testlaufs
07.09.2026
API-Anbieter
openrouter
Angefragtes API-Modell
openai/gpt-5.6-luna
API-Modell laut Antwort
openai/gpt-5.6-luna
Festgelegter Endpunkt
OpenAI | openai/gpt-5.6-luna-20260709
Reasoning-Einstellung
high
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung
Antwortzeit
49,9 s
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Grok 4.3
Community-Klassiker für eine freie SVG-Zeichnung.Erster Versuch
Datum des Testlaufs
07.09.2026
API-Anbieter
openrouter
Angefragtes API-Modell
x-ai/grok-4.3
API-Modell laut Antwort
x-ai/grok-4.3
Festgelegter Endpunkt
xAI | x-ai/grok-4.3-20260430
Reasoning-Einstellung
high
Temperatur
Anbieterstandard
Tokenlimit inklusive Reasoning
8.192 Token
Testprotokoll
community-visual-tests-v1
Technische Prüfung
Bestanden, keine Qualitätsbewertung
Antwortzeit
149 s
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Entscheidend sind deine Aufgaben, dein Budget und die benötigte Kontextlänge. Ein Coding-Benchmark sagt wenig über Bildverständnis oder Agentenarbeit aus.
Die Standardpreistabelle nutzt direkte Entwicklertarife. Der Anbieter-Vergleich kennzeichnet OpenRouter-Endpoints, Regionen und Sondertarife separat.
Jeder Messwert verlinkt seine Messstelle und zeigt den Abrufstand. Je nach Kennzeichnung handelt es sich um eine Anbieterangabe, ein offizielles Benchmark-Leaderboard oder eine unabhängige Evaluation. Strittige oder archivierte Ergebnisse werden nicht verwendet.
Weitere Duelle
Ähnliche LLM-Vergleiche
Vergleiche GPT-5.6 Luna und Grok 4.3 mit weiteren wichtigen Modellen. Alle Duelle nutzen dieselbe Daten- und Benchmarklogik.