Seed 1.6 Flash
ByteDance
Seed 1.6 Flash ist die kompakte API-Variante von ByteDances multimodalem Deep-Thinking-Modell. Sie akzeptiert Text, Bilder und Video, bietet bis zu 256.000 Token Kontext und kann mit deaktiviertem Denken direkt antworten. Die Parameterzahl bleibt unveröffentlicht, Gewichte gibt es nicht.
Die BytePlus-Dokumentation führt den Dienst als kontrollierbare API für produktive Agenten- und Dokumentenabläufe. Für lokale Forschung gibt es keinen Checkpoint, weil ByteDance nur die providergebundene Auslieferung anbietet.
| Angabe | Wert und Quelle |
|---|---|
| Gewichte | ProprietärQuelle |
| Zugang | APIQuelle |
| Kontextfenster | 256.000 TokenQuelle |
| Hinweise | Kompaktes multimodales Deep-Thinking-Modell mit einem Kontextfenster von 256.000 Token; die Parameterzahl ist nicht veröffentlicht.Quelle |
| Eingabe | Text, Bild, Video (abgerufen 2026-09-22)Quelle |
| Ausgabe | Text (abgerufen 2026-09-22)Quelle |
| Funktionen | Werkzeugaufrufe, Kontext-Cache und strukturierte Ausgabe (Beta). Verarbeitet auch Bilder und Videos. (abgerufen 2026-09-22)Quelle |
| Veröffentlichung | 2025-06-15Quelle |
| Lizenz | proprietary BytePlus termsQuelle |
| API-Modellkennung | seed-1-6-flash-250715Quelle |
Benchmark-Metaanalyse
Diese Gradually-Indizes ordnen ausgewählte veröffentlichte Messwerte auf einer Skala von 0 bis 100 ein. Sie sind keine Prozentgenauigkeit und keine Garantie für ein Ergebnis in deiner Anwendung.
Noch nicht genug unabhängige Werte für einen Score
vorläufig
Methodenfassung: benchmark-meta-score-v3
Es zählen aktive Messwerte aus geprüften Primärquellen, wenn mindestens fünf Modelle im selben dokumentierten Vergleichsschnitt aus Datensatz, Harness, Agent, Werkzeugen und Versuchsanzahl verglichen werden. Pro Benchmark-Reihe und Auswerter zählt ein gemeinsamer Setup-Schnitt aus dem neuesten Abruf. Bei mehreren ausdrücklich erfassten Reasoning-Stufen derselben Quelle und Testreihe zählt die höchste dokumentierte Stufe (none bis max), nicht der höchste Ergebniswert. Die ausdrückliche Quellenangabe „Non-reasoning“ entspricht none. Unbekannte oder mehrdeutige Stufen führen zum Ausschluss des Modells aus der betreffenden Reihe. Innerhalb jeder Reihe werden Prozentwerte und Quoten logit-transformiert, andere Einheiten bleiben unverändert, und anschließend werden alle Werte standardisiert. Ein Ein-Faktor-Modell schätzt daraus eine gemeinsame Leistungsstärke je Modell und je Reihe, wie deutlich sie zwischen den Modellen trennt. Bereichswerte weichen davon nur so weit ab, wie die eigenen Ergebnisse im Bereich es belegen. Der Gesamtwert gewichtet die Kernbereiche mit 75 % und Finanzen, Recht und Gesundheit mit 25 %. Er erfordert mindestens acht Testreihen aus zwei Quellen und drei Bereichen. Die Skala von 0 bis 100 bezieht sich auf eine feste Referenzgruppe aus 29 Sprachmodellen, deren Durchschnitt bei 50 liegt.
Veröffentlichte modellabhängige Parameter können abweichen. Das ist kein kontrolliertes Experiment; solche Vergleiche werden als vorläufig gekennzeichnet.
Nicht gemessene Reihen werden nicht als Nullwert eingesetzt. Fehlen einem Modell eigene Werte in einem Kernbereich, steht dort seine Gesamtstärke, und der Hinweis „geschätzt, ohne eigene Werte in …“ nennt den Bereich. Weniger Testreihen führen zu einem größeren Standardfehler.
Das 95-%-Intervall folgt aus dem Standardfehler von 200 Neuberechnungen mit zufällig neu gezogenen Testfamilien. Es beschreibt, wie genau die erfassten Testreihen den Wert festlegen. Es ist keine Prognose für künftige Aufgaben oder spätere Neuberechnungen mit anderen Teilnehmern.
Die Quellenzahl ist keine Anzahl unabhängiger Experimente.
OECD-Handbuch zu zusammengesetzten IndikatorenAlle 0 Testfamilien und 0 von 0 Rohmesswerten sind hier aufgeführt. Die vollständige Rechnung für alle Modelle enthält der JSON-Export.
Jeder Auswerter misst andere Fähigkeiten unter eigenen Bedingungen. Testreihen, Gesamtindizes und ihre Komponenten bleiben getrennt. Die Ergebnisse darunter behalten ihre Skalen, Konfigurationen und Quelldaten.
Für dieses Modell ist derzeit kein aktives Ergebnis der geprüften externen Auswerter zugeordnet. Weitere Quellenbelege stehen darunter.
Die Abdeckung ist keine Qualitätsrangliste. Überschneidende Tests und mehrere Einstellungen zählen nicht als unabhängige Versuche. Herstellerangaben, historische und strittige Ergebnisse bleiben außerhalb dieser Übersicht und sind in den Detailbelegen gekennzeichnet.
Für diese Messungen fehlen passende Vergleichswerte unter gleichen Testbedingungen. Die Originalwerte und Quellen bleiben hier nachlesbar.
Ein SVG-Prompt, feste Ausgabeparameter. Aufnahmen erscheinen nur bei gemeldeten 0 Reasoning-Tokens oder dokumentiert fehlender Reasoning-Steuerung. Gleiche Testbedingungen machen die interne Rechenleistung der Modelle nicht identisch.
Community-Klassiker für eine freie SVG-Zeichnung.
Seed 1.6 Flash
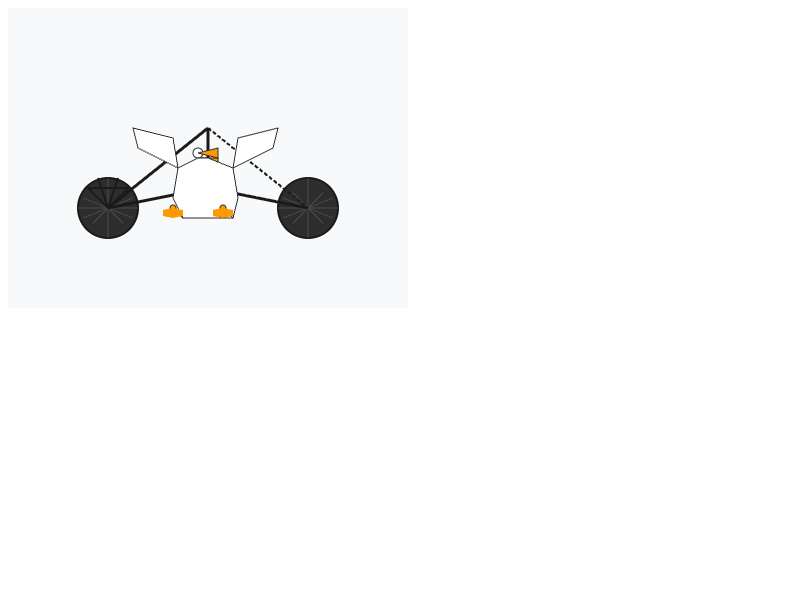
Reasoning (angefragt): high
Visuell geprüft. Aus diesem Einzeltest ergibt sich kein Gesamturteil über das Modell.
Generate an SVG of a pelican riding a bicycle
Tokenlimit inklusive Reasoning: 8.192 Token
Ursprung der Aufgabe (Simon Willison)9,4 / 100
| Art | Nachweis und Datenstand |
|---|---|
| Preis | API-Basispreise ohne Cache- oder Batch-Rabatt. Höhere Kontextstufen und weitere Tarife stehen unter Kosten. |
| Recherchestand | Recherchestand 8. September 2026. 6 Quellen-URLs geprüft. Das dokumentiert die geprüften Quellen, nicht sämtliche Veröffentlichungen zu diesem Modell. |
| In den geprüften Quellen nicht gefunden | parameters-billions Originalwortlaut No exact value located in the checked primary model card/API documentation. |
| In den geprüften Quellen nicht gefunden | active-parameters-billions Originalwortlaut No exact value located in the checked primary model card/API documentation. |
| In den geprüften Quellen nicht gefunden | knowledge-cutoff Originalwortlaut No exact value located in the checked primary model card/API documentation. |
| Ungeklärt | AA benchmark rows Originalwortlaut No exact Artificial Analysis model page located in the checked public sitemap. |
| Ungeklärt | other-table-metric-direction Hinweis Dieselbe Tabelle enthält PCS und fünf Phänotypdimensionen. Hier wird nur die aggregierte Genauigkeit erfasst, weil die zitierte Studie nicht belegt, dass höhere Phänotypwerte eine höhere Modellqualität bedeuten. |
| Weitere Quelle | Modellmetadaten (abgerufen 22. September 2026) · BytePlus Seed 1.6 Flash documentation · Redaktionelle Beschreibung geprüft am 2. Oktober 2026 |
| Weitere Quelle | A Memetic Landscape for Scrutinizing LLMs, OpenReview Table 3 (abgerufen 15. Oktober 2026) |
| Weitere Quelle | Modellmetadaten (abgerufen 8. September 2026) |
| Weitere Quelle | ByteDance Seed 1.6 technical overview · Redaktionelle Beschreibung geprüft am 2. Oktober 2026 |
| Weitere Quelle | OpenRouter: Beliebtheitsindex (abgeleitet), CC BY 4.0 |
| Weitere Quelle | Vercel AI Gateway: Beliebtheitsindex (abgeleitet), CC BY 4.0 |
| Weitere Quelle | Ollama: kumulierte Downloads für den Beliebtheitsindex |
| Weitere Quelle | Replicate: kumulierte Ausführungen für den Beliebtheitsindex |
| Weitere Quelle | Google Trending Now: begrenzte Feed-Auswahl für Deutschland und USA |
| Weitere Quelle | Creative Commons Attribution 4.0 |